用AI辅助证明康威猜想:Vibe Coding进军数学证明
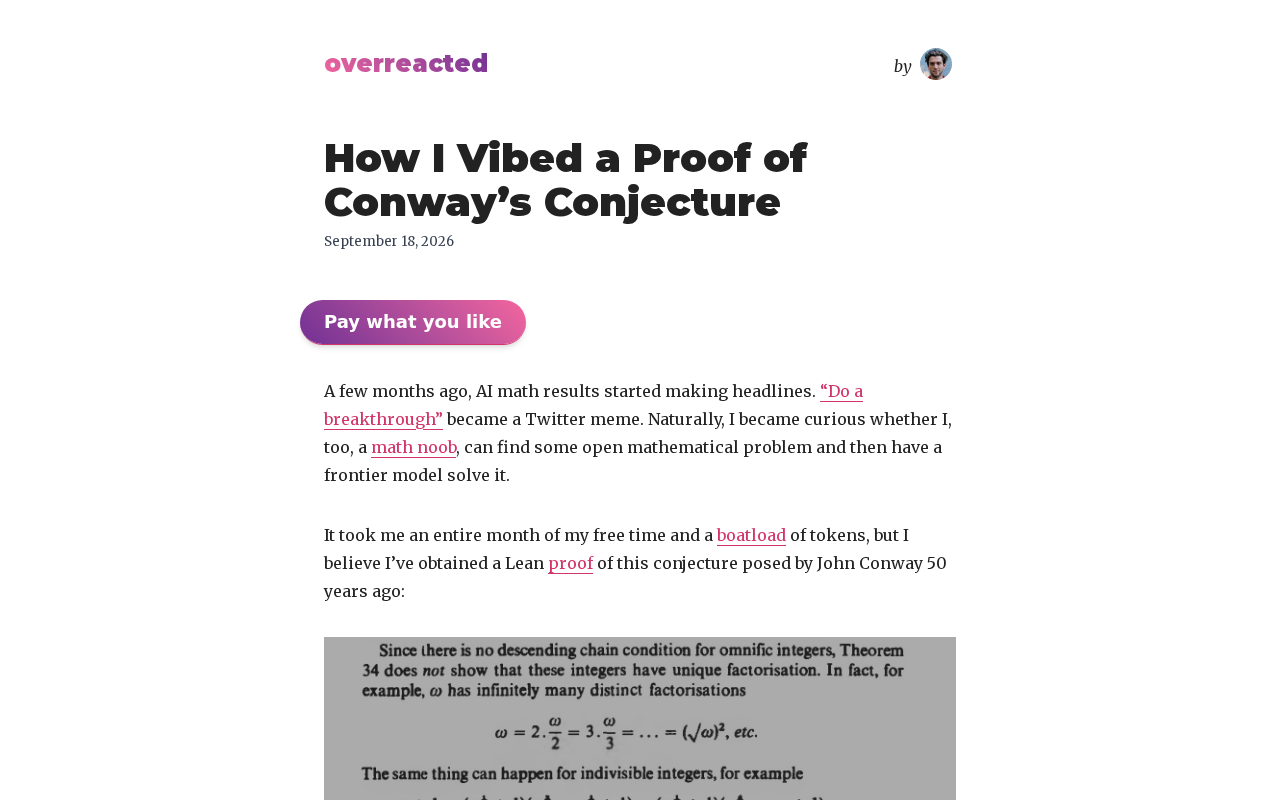
Dan Abramov用AI「氛围编程」方式尝试构造康威猜想论证,引发社区关于AI能否参与严肃数学的争论。
React核心贡献者Dan Abramov将「vibe coding」方法论从编程迁移到数学证明,借助AI协作尝试构造康威猜想的论证,并以「Why I think it's correct」为标题公开全过程,以「我认为」而非「我证明」的措辞保持审慎。该项目在Hacker News引发两极反应:乐观派视AI为高效的「思维放大器」,警惕派则指出大语言模型的数学论证极易产生「看似正确实则有误」的幻觉,而数学证明的价值恰在于严格性。文章进一步指出,Lean、Coq等形式化证明助手与AI结合是更可靠的方向,纯自然语言论证缺乏机械验证保障。Abramov此次实验的意义不在于是否真正证明了猜想,而在于把AI辅助数学的过程与局限性公开呈现,为社区讨论提供了具体参照。
当"氛围编程"遇上数学猜想
知名前端工程师、React核心贡献者Dan Abramov(gaearon)近日在GitHub发布了一个引人注目的项目:他借助AI以"vibe coding"(氛围编程/直觉式协作编程)的方式,尝试构造康威猜想(Conway's conjecture)的一个证明或精化(refinement)。这个项目在Hacker News上获得了245个赞和逾229条评论,引发了关于AI在严肃数学研究中角色的激烈讨论。
所谓"vibe coding",是近来在开发者社区流行的一种工作方式:开发者不再逐行编写代码,而是通过与大语言模型持续对话、迭代反馈,让AI承担大量生成工作,人类则负责把握方向、验证结果。Abramov把这套方法论从写代码迁移到了数学证明的构造上,本身就是一次颇具实验性质的尝试。
项目在做什么
根据项目仓库的说明,Abramov并非声称自己独立完成了一个严格的数学证明,而是记录了他与AI协作、逐步逼近某个论证的过程。仓库中专门有一节标题为"Why I think it's correct"(为什么我认为它是正确的),坦诚地列出了他相信这个论证成立的理由,而非以权威口吻宣布定论。
这种表述方式本身值得关注。它体现了一种审慎态度:AI辅助产生的数学论证,其"正确性"需要经过独立验证,作者用"我认为"而非"我证明了"来定性,把判断权交还给读者与数学社区。
康威猜想(Conway's conjecture)由数学家约翰·霍顿·康威提出,属于组合数学或数论领域的开放问题(具体指向需结合仓库上下文确认,康威一生提出过多个著名猜想,包括与整数序列、博弈论相关的命题)。康威猜想的共同特征是:陈述往往简洁直观,但严格证明极为困难,需要深刻的结构洞察。正因如此,它成为测试AI数学能力的有趣标靶——足够具体、有文献可查,但又远未被"平凡化"。Abramov选择这一对象而非教科书例题,说明他的目标是探索AI在真实开放问题上的边界,而非演示AI完成已知可解任务的能力。
社区的两极反应
Hacker News上的讨论呈现出明显的分歧。
一派持乐观和好奇态度,认为这类实验展示了AI作为"思维放大器"的潜力。对于探索性的数学工作而言,AI能快速生成候选思路、补全推导细节、检查符号运算,确实可以显著提高效率。即便最终证明需要人工严格化,AI也扮演了有价值的"草稿伙伴"角色。
另一派则保持警惕。他们指出,大语言模型生成的数学论证极易出现"看起来正确但实际有误"的情况——推导中某一步的逻辑跳跃、隐含假设或符号滥用,往往需要专业数学家逐字审查才能发现。数学证明的价值恰恰在于其严格性,而"vibe"式的直觉判断与这种严格性存在天然张力。用"我觉得对"来评价一个证明,正是许多评论者担忧的地方。
AI辅助数学的真实边界
这个项目触及了一个更大的话题:AI究竟能在多大程度上参与数学证明?
目前,形式化证明助手(如Lean、Coq)与AI的结合被认为是更可靠的方向——AI负责生成证明策略,形式化系统负责机械地验证每一步的正确性,从而杜绝"看起来对"的幻觉。相比之下,纯自然语言的AI论证缺乏这层机械验证的保障,正确性完全依赖人工把关。
Abramov的实验属于后者,它更像是一次公开的探索记录,而非可直接采信的成果。它的价值不在于是否真的证明了康威猜想,而在于把AI辅助数学的过程、方法和局限性摊开来供社区讨论。
形式化证明助手是一类将数学语言转化为计算机可验证逻辑的软件系统。Lean 和 Coq 是其中最具代表性的两个:用户用专门的形式化语言逐步写出定理和证明,系统会对每一推导步骤进行机械检验,任何逻辑漏洞都会导致编译失败。这与自然语言证明有本质区别——后者依靠读者的数学直觉"填补"作者省略的步骤,而形式化系统不允许任何隐式跳跃。近年来,DeepMind的AlphaProof、Meta的COPRA等项目正在探索用大语言模型自动生成Lean证明脚本,再由Lean验证,从而将AI的生成能力与形式化系统的严格性结合。这一路径被普遍认为比纯自然语言论证更可信,因为"看起来对"的幻觉无法通过形式化系统的检验。
一次值得围观的实验
对于开发者和AI观察者而言,这个项目提供了一个具体案例,去思考AI协作方法论能否跨越领域边界。写代码时,编译器和测试可以充当即时反馈;而在数学证明中,缺少同等强度的自动验证机制,人类判断的权重陡然上升。
Abramov作为技术社区的知名人物,用开放、坦诚的方式分享了这次尝试——包括他的不确定性。无论最终论证是否经得起数学家的检验,这种"把过程和疑虑一并公开"的姿态,本身就为AI时代的知识生产提供了一个有意思的参照。
结语
AI正在渗透到越来越多需要严密推理的领域。康威猜想这样的数学难题,或许还不是大语言模型能独立攻克的对象,但人机协作探索的边界正在被不断试探。真正的问题不是"AI能不能证明",而是"我们如何验证AI给出的论证"——这道关卡,目前仍牢牢握在人类手中。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
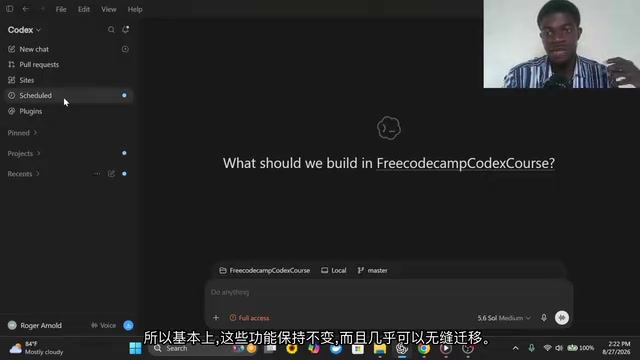
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
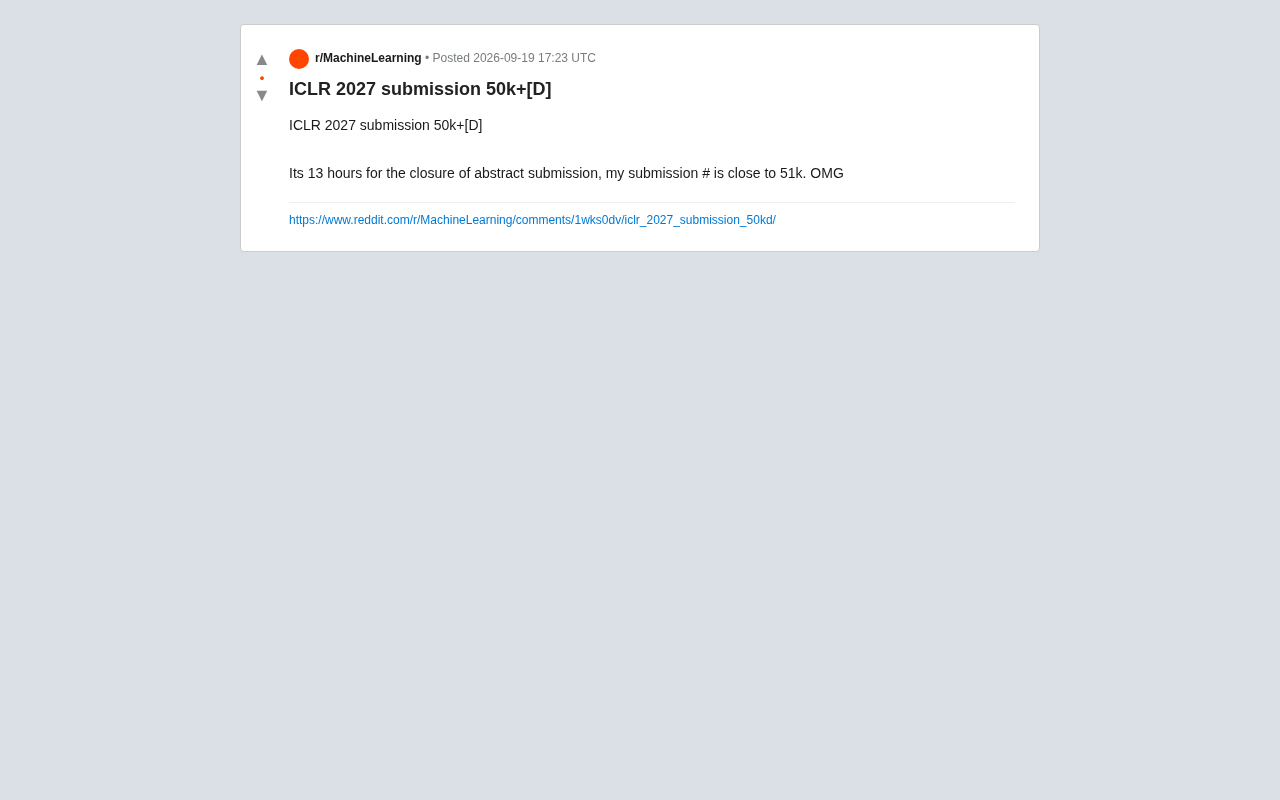
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。