用AI照抄舞蹈动作:换人换画风不换动作实操教程
利用AI动作迁移技术,上传角色图、舞蹈视频与深度视频,即可将任意舞蹈动作套用到不同角色与画风上。
本文介绍了一套借助AI工具实现「舞蹈复刻」的简易流程:核心原理是提取原始视频的动作骨骼数据,替换角色外观与视觉风格,而非重新制作动画。具体操作通过「Flova拉片大师」专家技能模块完成,用户需准备角色参考图、舞蹈视频和深度视频三类素材,并附上描述关键词,提交后由AI自动分析生成成片。深度视频是其中最易被忽视的关键素材,能有效减少动作迁移时的肢体错位与穿模问题。这种流程大幅降低了视频创作门槛,但成片质量强依赖素材精度与提示词完整度,商业使用时还需关注舞蹈动作的版权风险。
AI舞蹈复刻的核心思路
短视频平台上频繁出现同一支舞被不同角色、不同画风重复演绎的作品。背后的原理并不复杂——保留原始动作数据,替换角色形象与视觉风格。这类玩法之所以流行,是因为它把过去需要动作捕捉、绑定骨骼、逐帧渲染的复杂流程,压缩成了几步简单操作。
据B站UP主分享的演示,整个制作过程依托一个专家技能连接器完成,用户只需准备好素材、输入描述,剩下的分析与生成交给AI模型自动处理。这种「上传素材—等待出片」的模式,正是当前AI视频工具降低创作门槛的典型体现。
这类技术在学术上通常被称为「动作迁移」(Motion Transfer)或「人体姿态驱动生成」(Pose-driven Video Generation)。其底层逻辑是将人体运动抽象为与外观无关的骨骼序列或姿态热图(Pose Heatmap),再将这套运动信号注入到新角色的图像生成过程中。早期代表性工作如 DensePose、OpenPose 负责提取骨骼关键点,近年来 ControlNet 等条件控制机制的成熟使得「姿态条件→图像生成」的链路更加稳定,Flova 等工具正是在此基础上封装了面向普通用户的完整流水线。
具体操作步骤拆解
第一步:调用专家技能连接器
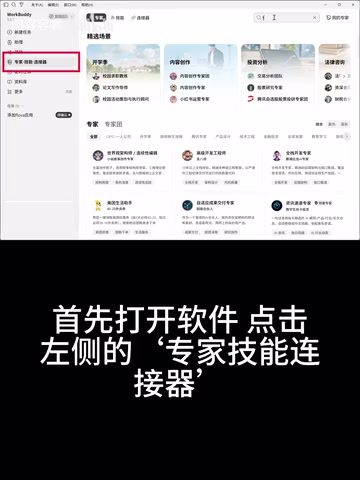
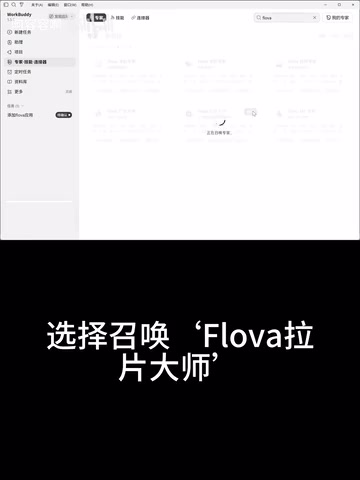
打开对应软件后,在左侧找到「专家技能连接器」,在搜索框中输入关键词 Flova,选择召唤对应的「Flova 拉片大师」技能模块。这一步本质上是加载一个针对舞蹈动作提取与迁移优化过的工具链。
第二步:准备并上传三类素材
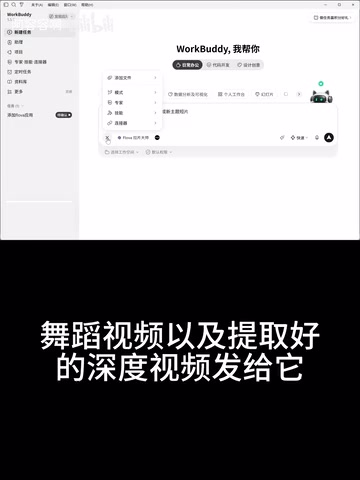
完成技能加载后,需要向工具提供三份关键素材:
- 角色参考图:决定最终画面中「谁」在跳舞,可以是不同人物、不同画风的形象;
- 舞蹈视频:提供原始的舞蹈内容作为动作来源;
- 提取好的深度视频:包含空间深度信息,用于让AI更准确地还原肢体运动的三维姿态。
深度视频是这套流程中容易被忽视但很关键的一环。相比只用普通视频,深度信息能显著改善动作迁移时的身体结构一致性,减少肢体错位、穿模等常见问题。
深度视频(Depth Video)的获取通常有两种途径:一是使用专门的深度估计模型(如MiDaS、Depth Anything等开源工具)对普通视频进行处理,逐帧生成灰度深度图序列;二是部分AI视频工具内置了深度提取功能,可直接将普通舞蹈视频转换为深度视频。深度图中,像素亮度代表该点距摄像机的相对距离——越亮表示越近,越暗表示越远。AI模型通过这份额外的空间信息,能更准确地推断出人体各关节在三维空间中的实际位置,而不是仅凭二维像素猜测肢体层级关系,这对于手臂交叉、身体转向等复杂动作尤为重要。
第三步:附上描述关键词
上传素材的同时,需要附带对应的描述性关键词,用文字进一步约束画风、场景与角色特征。提示词的精确度直接影响成片质量,这也是这类工具从「能用」到「好用」的分水岭。
第四步:等待自动出片
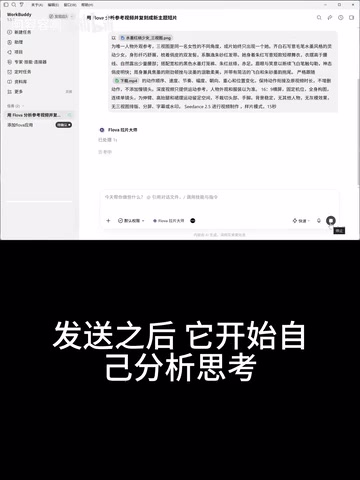
发送素材与关键词后,模型会自行完成分析与思考,无需人工干预,直接等待渲染完成即可获得成片。
这类玩法的价值与局限
从创作效率角度看,动作复用是极高性价比的做法。一段精心设计或来自热门舞蹈的动作,可以被反复迁移到不同角色上,快速产出多个版本的内容,特别适合追热点、做二创的短视频创作者。
但也要理性看待其边界。动作迁移的效果高度依赖输入素材质量——参考图清晰度、深度视频的准确性、提示词的完整度,任何一环薄弱都会让成片出现瑕疵。此外,直接复用他人原创舞蹈动作,在商用或规模化传播时可能涉及版权与原创性问题,创作者需自行注意合规风险。
写在最后
这套「换人、换画风、不换动作」的流程,代表了AI视频生成工具走向平民化的一个方向:把专业的动作捕捉与风格迁移能力,封装成傻瓜式的上传交互。对普通用户而言,理解每类素材的作用、打磨提示词,是把这类工具用出效果的关键。原作者已将具体提示词放在评论区,感兴趣的读者可自行取用实践。
相关推荐
WorkBuddy是什么?国内AI智能体入门实战全解析
WorkBuddy是什么?本文解析这款国内AI智能体的核心能力:批量处理文件、对接企业微信等办公软件、连接器与技能市场,以及与豆包、Codex的对比差异,帮助新手快速理解并上手AI数字员工。
解析Agent Harness:从Claude Code源码看AI智能体架构
深度解析 Agent Harness(Harness Engineering)架构,结合 Claude Code 源码泄露事件,梳理 AI 智能体的底层原理、核心组件与工程实现思路,帮助开发者理解大模型应用的前沿架构范式。
VSCode SSH 代理机制解析:便利背后的安全隐忧
VSCode Remote-SSH 的代理转发机制引发 Hacker News 讨论。本文解析 VSCode SSH Agent 的工作原理、便利性背后的安全隐患,以及开发者应采取的防护实践。