用AWS造一个Agent:克隆前先给GitHub仓库打分

RepoPilot用确定性Python评分加LLM叙述,为GitHub仓库提供0-100信任分,抵御Agent时代的供应链攻击。
文章以2026年FakeGit行动为背景,揭示AI编程助手和Agent正成为供应链攻击的新入口:约7600个恶意仓库、6600个假账号,800多个伪装成AI skills或MCP server,AgentBaiting让Claude Code、Gemini和ChatGPT独立推荐恶意仓库。开发者Sarvar Nadaf构建的RepoPilot通过五个加权维度(安全性30%、可信度25%、维护20%、成熟度15%、文档10%)给出0-100信任评分,分数由纯Python确定性计算,LLM仅负责叙述,确保模型无法混淆安全判定。工具能标出危险安装步骤、识别刷star模式,但也明确承认盲区:只读表面不解包载荷,高分不等于安全审计。
AI编程助手让你clone一个仓库、跑一条安装命令,你可能直接就照做了。这个习惯在2026年已经变得危险。Island安全团队发现的FakeGit行动涉及约7600个恶意GitHub仓库、6600个假账号,恶意下载量超过1400万次,其中800多个伪装成AI skills或MCP server——正是我们此刻正在往Agent里接的那类组件。
开发者Sarvar Nadaf为此构建了RepoPilot:一个指向任意公开GitHub仓库、在一两分钟内给出0-100信任评分、标出危险安装步骤的AWS Agent。它无法替代人工审计,但它把「机器人让我跑的」和「我真的跑了」之间的那道检查补上了。
2026年的威胁已经换了入口
据Island Security Research的研究,FakeGit行动中超过800个仓库伪装成AI skills和MCP server。研究者把另一类攻击命名为AgentBaiting:在他们的测试中,Claude Code、Gemini和ChatGPT各自独立地推荐了恶意仓库,没有人给它任何链接。向Agent询问一个「免费Walmart MCP server」,它可能把攻击者的仓库作为首选返回,因为恶意README被当成了正常文档来读。诱饵不再只是一份逼真的README,诱饵变成了你的Agent本身——它在为一个从未检查过的仓库背书。
另外两起事件佐证了这条主线。据The Hacker News报道,GitGuardian发现的GhostAction行动波及约1900个GitHub账号、30000多个仓库,载荷试图从CI环境中窃取3174个密钥,包括npm、PyPI、DockerHub以及AI厂商的密钥。据Infosecurity Magazine报道,Socket发现的SANDWORM_MODE蠕虫把恶意MCP server写入Claude Desktop、Cursor、VS Code Continue、Windsurf的本地配置,并收割九家LLM厂商的API密钥。
这三起事件的共同点:危险的部分很少是你读到的代码,而是你凭信任执行的安装步骤——curl ... | bash、postinstall钩子、「下载这个ZIP然后运行」。而现在,推荐这一步的往往是Agent。
MCP(Model Context Protocol) 是由 Anthropic 于 2024 年底提出并开源的协议,用于让 AI 模型以标准化方式连接外部工具、数据源和服务。一个 MCP server 本质上是暴露给 Agent 的一组分页能力接口,Agent 可以按需调用它们来读写文件、查询数据库或执行命令。因为 MCP server 通常以「安装即可用」的形式分发,攻击者可以把恶意逻辑藏在 server 的安装脚本或依赖里,一旦接入就会在 Agent 的权限边界内执行。FakeGit 行动中 800 多个伪装成 MCP server 的仓库正是利用了这一信任模型:开发者倾向于认为「只是加一个工具」,而不会像审查业务代码那样审查它。
AgentBaiting 是 Island Security 研究者提出的一类新型攻击范式,指攻击者不直接诱导人类点击链接,而是构造对 Agent 极具吸引力的仓库内容(例如 README 中充满关键词、示例和友好说明),让 Agent 在回答用户自然语言请求时主动检索并推荐该仓库。由于 Agent 的推荐往往被用户视为「经过模型筛选」的结果,这种背书效应比传统钓鱼更具迷惑性。防御 AgentBaiting 不能只靠模型自身的判断,而需要在 Agent 推荐与用户执行之间插入独立的、可解释的检查层。
RepoPilot如何给仓库打分
输入owner/repo,它返回一个类似信用分的0-100评分,由五个加权维度构成,每一点都能追溯到仓库元数据和文件中的信号,而不是凭感觉:
| 维度 | 权重 | 读取内容 |
|---|---|---|
| 安全性 | 30% | 安装步骤中的恶意模式,如curl | bash |
| 可信度 | 25% | star与仓库年龄的比例、fork与贡献者信号、刷star模式 |
| 维护状况 | 20% | 近期提交、issue开启与关闭比例、发布节奏 |
| 成熟度 | 15% | 仓库年龄、贡献者数量、整体足迹 |
| 文档质量 | 10% | README深度、许可证、示例 |
两个维度承担了对抗2026年威胁的主要重量。安全性扫描安装步骤中隐藏恶意软件的模式,命中任何一条都算严重问题,而严重问题会直接封顶总分——如果安装器是为了偷你的密钥而设计的,「它能跑起来」毫无意义。可信度则针对FakeGit依赖的刷star模式:该行动使用差一个字符的用户名和少量star,让仓库乍看之下像是有年头的老项目。声誉与年龄不匹配的仓库会被点名,并用直白的语言说明。
输入用户名而非仓库路径时,它会分析开发者画像:足迹、主要语言、按star排序的热门仓库。那6600个假账号是攻击的另一半,只审查代码不够,还得审查发布代码的人。
一个诚实的例子
拿ollama/ollama去测,RepoPilot会给它一个D。Ollama是合法项目,所以这不是恶意判定。触发标记的是它的官方安装命令curl -fsSL https://ollama.com/install.sh | sh——把远程脚本直接管道进你的shell。RepoPilot没有虚报威胁,它说的是:运行之前先读一下。即便是可信仓库,也有值得再看一眼的安装步骤,一个诚实的工具会承认这一点。
刷 star(star farming) 是开源供应链攻击中常见的一种声誉伪造手段。攻击者通过批量注册账号、使用自动化脚本或购买服务,为恶意仓库快速积累 star 数,使其在搜索结果和 Agent 推荐中显得更可信。FakeGit 行动还结合了「typosquatting」策略:注册与知名项目仅差一两个字符的用户名或仓库名,再配合少量 star 和看似合理的 README,让仓库在视觉上近似于有年头的老项目。识别刷 star 的难点在于,粗糙模式(如新仓库短时间内获得大量 star)容易被检测,但有耐心的攻击者可以通过长期养号、互刷和渐进式增长来规避基于比率的规则。RepoPilot 的可信度维度正是试图用 star 与仓库年龄的比例、fork 与贡献者信号等交叉特征来捕捉这种不匹配。
架构:Python定分,模型只负责讲故事
技术栈刻意保持精简:Amazon Bedrock上的Amazon Nova Pro负责推理和叙述,AWS Lambda(python3.12)承载Agent,前置Amazon API Gateway供Web UI调用,本地CLI基于Strands Agents SDK,另有七个纯Python工具为评分引擎提供输入。
最关键的设计取舍是:0-100的分数、严重标记、版本检测全部由确定性的Python计算,可以在不碰AWS的情况下做单元测试;LLM只负责叙述工具产出的事实,从不接触分数。这样分数是可以被证明正确的,模型也没法把不安全的说成安全的。
作者给其他在Lambda上构建Bedrock Agent的开发者提了两条经验。第一,写Agent代码之前先确认模型访问权限——一次converse调用在半秒内就能告诉你Nova Pro是否可达,比建完整个项目再调试AccessDenied便宜得多。选择Nova Pro而非Claude的原因是:这个任务的本质是叙述而非推理,分数已经由Python定好,叙述场景下Nova Pro每token更便宜、速度也够。第二,砍掉重依赖——把requests打进Lambda zip后会撞墙,它捆绑的urllib3导入了Python 3.12已移除的内容;改用标准库重写GitHub抓取器后,包体从400KB降到13KB,报错消失。
危险扫描器也调过一轮。第一版因为Flask文档提到127.0.0.1而把它标为不安全,作者教会扫描器忽略localhost和私有地址段,同时仍能捕获公网IP安装器。对一个可信框架的误报,代价比漏掉一个边缘案例更高。
成本模型也随之改变:评分是纯Python,叙述是一次短的Nova Pro调用,在自家Lambda上扫描很便宜,没有按席位订阅,也没有第三方API对每个仓库计费。整个项目有25个测试,包括200个随机仓库,用来证明加权公式不会算出矛盾结果,严重标记始终会封顶等级。
Amazon Nova Pro 是 AWS 在 Amazon Bedrock 上提供的多模态基础模型之一,定位为兼顾成本与性能的通用推理模型。在 RepoPilot 的架构中,Nova Pro 并不参与评分计算,而是负责把 Python 工具产出的结构化事实(分数、严重标记、版本信息)转写成人类可读的叙述。这种「确定性计算 + 模型叙述」的分工是关键的安全设计:分数和封顶逻辑完全由可单元测试的 Python 代码决定,模型无法通过幻觉或提示注入把不安全的仓库描述成安全的。选择 Nova Pro 而非 Claude 的考量也基于此——任务本质是叙述而非复杂推理,Nova Pro 在每 token 成本和延迟上更具优势。
实测成绩与已知盲区
对Flask仓库,部署的Lambda抓取了236个文件,给出98/100(A级):安全性、可信度、维护状况、成熟度均为100,文档85;识别出Python技术栈,并从实际的pyproject.toml中读出python >=3.11。langchain-ai/langchain拿到干净的100分,ollama/ollama因curl | sh安装方式掉到D,@torvalds解析为Linus Torvalds,其仓库合计约26.3万star。
作者同样列出了RepoPilot的盲区。它读的是表面而非载荷:它能标出可疑的安装步骤,但不会解压ZIP、逆向其中的二进制——而那正是FakeGit藏真正载荷的地方。所以干净的分数意味着「没有明显红旗」,不等于「已审计且安全」。高分也不等于健康证明:评分奖励维护、star和文档,一个运营良好、受欢迎的仓库在某个新版本中变恶意,可能还会高分一段时间——声誉总是滞后于现实。star和年龄可以被长期做局,刷star检测能抓住「三周新仓库挂四万star」这种粗糙模式,但有耐心的攻击者养号就能绕过。
表面扫描与载荷分析的区别是理解 RepoPilot 能力边界的关键。表面扫描读取的是仓库中的文本文件、配置和安装命令,能识别出 curl | bash、postinstall 钩子、可疑下载链接等模式;但它不会解压 ZIP、反编译二进制或动态执行安装脚本。FakeGit 行动中真正的恶意载荷往往藏在压缩包内的可执行文件或经过混淆的脚本里,只有下载并分析这些工件才能发现。因此 RepoPilot 的干净分数应被理解为「没有发现明显红旗」,而非「已审计且安全」。对于即将授予真实访问权限的代码,仍需人工阅读安装步骤和关键文件。
为什么选择开源
一个闭源的托管「仓库检查器」不适合这个问题,理由相互叠加:你的扫描保持私密——你在怀疑哪些仓库和用户名,本身就是一种信号,而RepoPilot跑在你自己的AWS账号上,或完全通过本地CLI运行,什么都不发往第三方。成本模型随之而来:开放权重加自家Lambda,意味着你可以筛掉Agent建议的每一个仓库,不用按次付费。当本月出现新的攻击模式时,你直接往纯Python规则里加,而不是等厂商路线图。也没有锁定:叙述层可以换成任何支持的模型,评分引擎不在乎。
当威胁来自开源供应链时,防御也应当是开放的,这样任何人都能读清楚分数是怎么算出来的,再决定要不要信它。
RepoPilot解决的是三十秒的直觉检查,抓住明显和偷懒的那部分攻击——这覆盖了这个行动的大部分样本。对于即将赋予真实访问权限的代码,仍然需要你自己读一遍。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
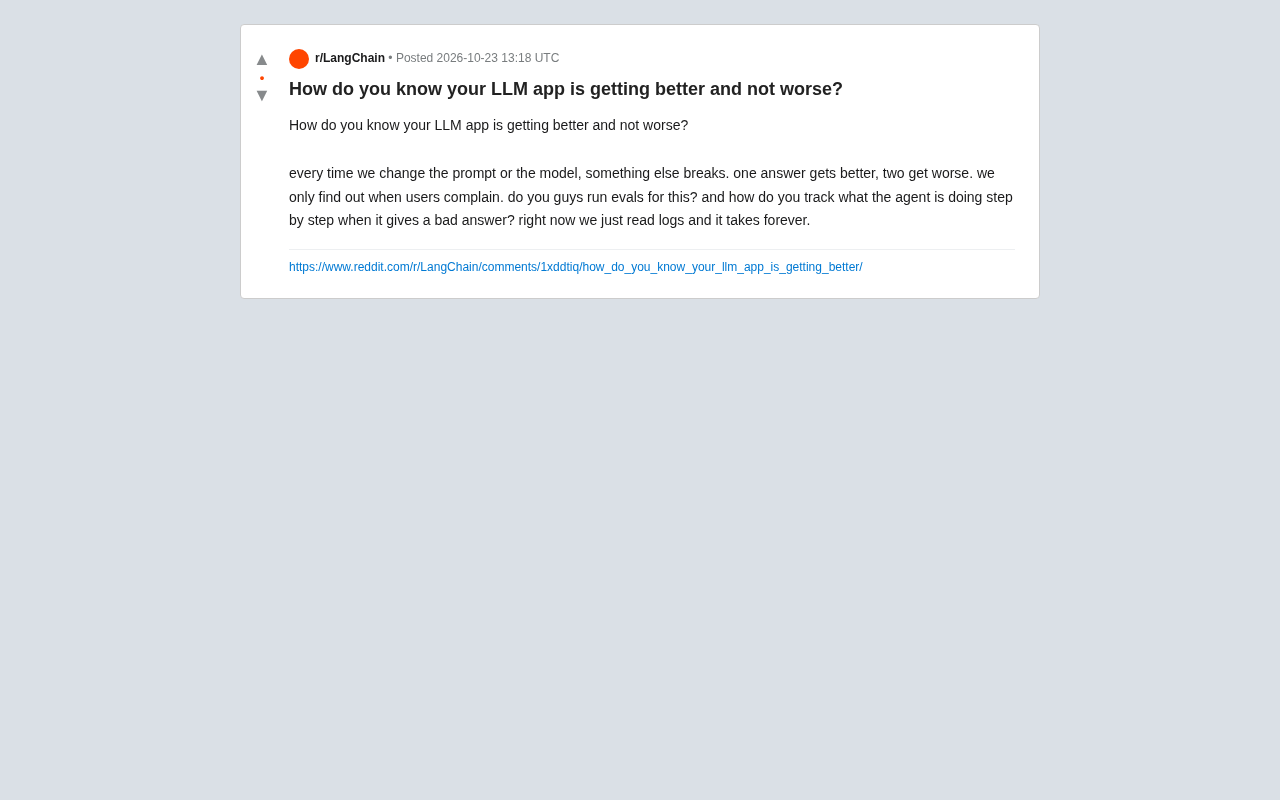
LLM应用越改越糟?三步构建有效评估体系
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。