用纯Rust训练语言模型:164美元实验背后的框架陷阱

独立研究者用164美元、纯Rust端到端预训练0.4B孟加拉语模型,并系统记录了两大Rust ML框架的静默缺陷。
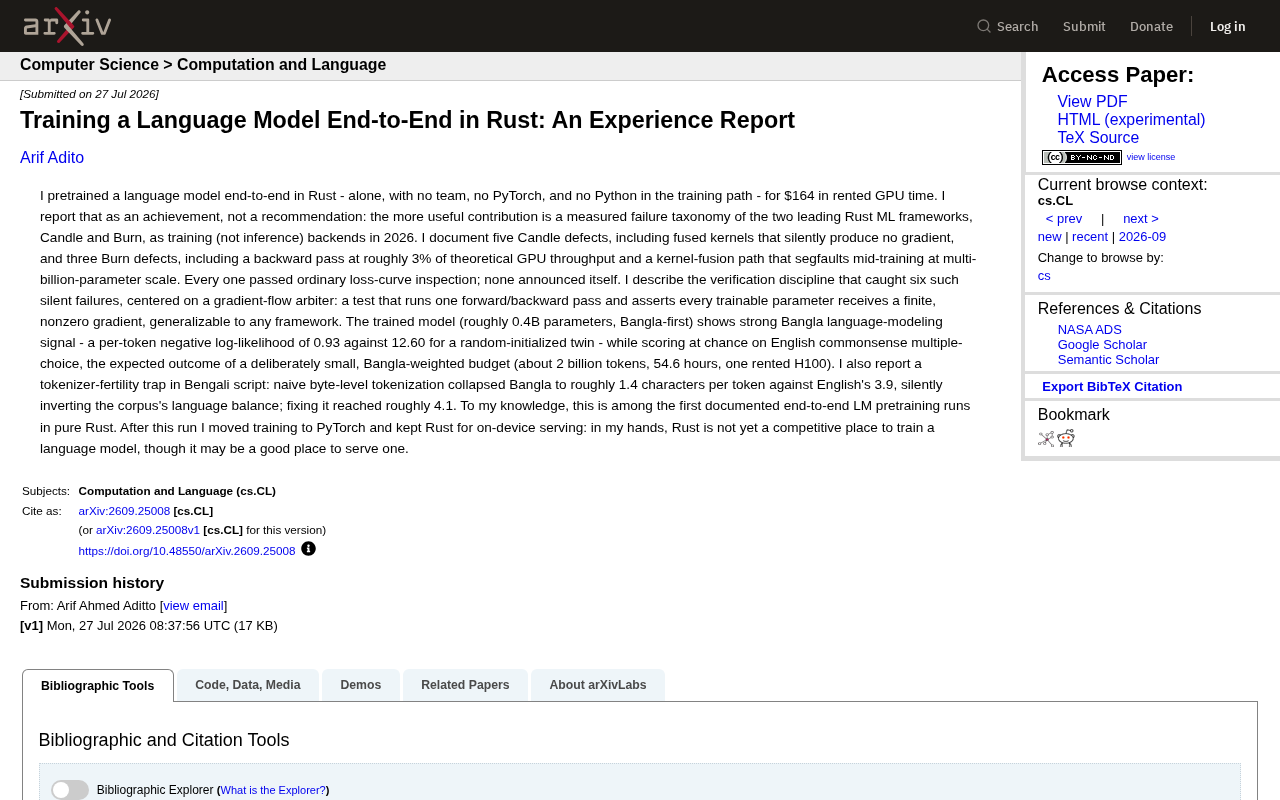
一位独立研究者完全脱离Python和PyTorch,仅用Rust从头预训练了一个0.4B参数的孟加拉语语言模型,总成本164美元、单张H100运行54.6小时。实验的核心价值不在于成功本身,而在于对Rust机器学习框架Candle和Burn的系统性缺陷记录:共八个bug,几乎全部"沉默"——不报错、不崩溃,但零梯度、3%吞吐量或中途segfault在正常loss曲线下悄然发生。作者提出"梯度流仲裁者"验证方法来捕获这类静默失败,并揭示了孟加拉文字节级分词效率低下导致语料平衡被隐性颠倒的陷阱。最终结论务实:Rust目前不适合训练,但适合设备端推理,形成"训练用PyTorch、服务用Rust"的现实分工。
一位独立研究者做了一件几乎没人尝试过的事:完全脱离PyTorch和Python,只用Rust语言从头到尾预训练了一个语言模型。整个训练成本仅164美元的租用GPU时间。但这份实验报告真正的价值,不在于炫技式的成功,而在于对Rust机器学习生态系统一次冷静、可量化的"失败清单"。
一次孤独的纯Rust训练实验
作者独自完成了这项工作——没有团队,没有PyTorch,训练路径中也没有任何Python代码。最终训练出的模型约有4亿(0.4B)参数,以孟加拉语(Bangla)为主要目标语言。整个训练使用约20亿tokens的语料,在一张租用的H100上运行了54.6小时。
作者明确表示,把这件事作为"成就"来汇报,而非"推荐"。换言之,他并不建议其他人现在就用Rust来训练大模型。这份报告更有意义的贡献,是系统性记录了2026年两个主流Rust机器学习框架——Candle和Burn——作为训练后端(而非推理后端)时暴露出的种种缺陷。
沉默的失败:肉眼看不出的框架缺陷
最令人警醒的发现是:这些框架的bug几乎都是"沉默"的。它们不会报错、不会崩溃,甚至能通过常规的损失曲线检查——loss看起来在正常下降,但模型内部实际上早已出了问题。
作者一共记录了Candle的五个缺陷和Burn的三个缺陷。其中几个尤为致命:
- Candle的融合内核(fused kernels)会静默地产生零梯度——也就是说,某些参数根本没有在训练中被更新,但表面上一切正常。
- Burn的反向传播(backward pass)性能只有理论GPU吞吐量的约3%,这意味着绝大部分算力被浪费。
- Burn的内核融合路径在数十亿参数规模下会在训练中途段错误(segfault)崩溃。
这些问题的共同特征是:没有一个会主动"宣告"自己的存在。它们潜伏在正常的训练指标之下,如果没有针对性的验证手段,很可能被完全忽略,最终得到一个悄悄训练失败的模型。
Candle和Burn是目前Rust生态中最主流的两个机器学习框架。Candle由HuggingFace主导开发,定位是轻量级、接近底层的张量计算库,设计哲学偏向极简;Burn则是社区驱动的项目,目标是提供更高层次的抽象,类似PyTorch的使用体验,并支持多种后端(包括CUDA、WebGPU等)。两者在推理场景下已有一定的生产案例,但训练场景——尤其是需要精确反向传播和大规模参数更新的预训练任务——对框架的正确性要求远高于推理,此前几乎没有公开的压力测试记录。
梯度流仲裁者:一种可复用的验证纪律
作者能够在这套充满暗礁的环境中捕获六个静默失败,靠的是一套严格的验证纪律,核心是他称之为"梯度流仲裁者"(gradient-flow arbiter)的测试。
这个测试的逻辑相当直接却极其有效:运行一次前向/反向传播,然后断言每一个可训练参数都收到了一个有限且非零的梯度。任何参数如果拿到的是零梯度或非法数值(如NaN、Inf),测试立即失败。
这一方法的价值在于它的通用性——它不依赖任何特定框架,可以推广到任何深度学习训练系统中,作为一道基础的健康检查防线。对于任何自建训练流程的团队来说,这都是一个值得借鉴的工程实践:不要只盯着loss曲线,要直接验证梯度是否真正流经了整个网络。
梯度流验证的必要性来自深度学习训练的一个结构性脆弱点:损失函数下降并不等同于所有参数都在被正确优化。梯度消失、参数被意外冻结、计算图断裂或框架层面的内核实现错误,都可能导致部分参数的梯度为零——而模型整体的loss仍然会因其他参数的更新而缓慢下降,从外部看"一切正常"。在PyTorch生态中,这类问题通常由成熟的社区、大量的已知案例和autograd的充分测试来兜底;在一个相对不成熟的框架中,开发者必须自己构建这道防线。将梯度检查作为训练流程中的标准断言(而非调试时的临时手段),是一种防御性工程习惯,在任何自定义训练框架或非主流后端中都具有实践价值。
孟加拉语分词的"繁殖率陷阱"
除了框架层面的问题,作者还揭示了一个语言学与工程交叉的隐蔽坑:孟加拉文(Bengali script)的分词繁殖率陷阱(tokenizer-fertility trap)。
最初采用朴素的字节级(byte-level)分词时,孟加拉语被压缩到平均每个token约1.4个字符,而英语则是每个token约3.9个字符。这个差异带来了严重后果:它在无声中颠倒了语料库的语言平衡——尽管语料以孟加拉语为主,但由于分词效率低下,实际喂给模型的有效孟加拉语信息量被大幅稀释。
修复这一问题后,孟加拉语的分词效率提升到约每个token 4.1个字符,语言平衡才得以恢复。这个案例提醒我们,多语言模型训练中,分词器对非拉丁文字的处理效率会直接、且隐蔽地影响训练结果。
分词繁殖率(tokenizer fertility)指的是将一段文本编码为token序列时,每个词或字符平均对应的token数量。对于拉丁字母语言(如英语),成熟的BPE(字节对编码)分词器能够将常见词汇合并为单个token,效率较高;而对于孟加拉语、中文、阿拉伯语等非拉丁文字,若分词词表主要基于英语语料构建,则大量字符会被降级为字节级表示,导致同等语义内容需要消耗数倍的token预算。在混合语言预训练中,这一效率差异不仅浪费了序列长度,还相当于给不同语言的内容施加了隐性权重——低效率语言在每个训练步的有效信息量更少,模型实际接触到的语义信号被系统性地稀释。这是多语言大模型研究中一个被反复强调但在工程实践中仍常被忽视的问题。
训练效果与最终结论
从结果看,这个精心控制预算的小模型确实学到了东西。它在孟加拉语建模上展现出强信号:每token的负对数似然(NLL)为0.93,而随机初始化的同结构"孪生"模型这一数值高达12.60,差距悬殊。
同时,模型在英语常识多选题上的表现接近随机猜测——这完全符合预期,毕竟这是一个刻意做小、且以孟加拉语为主的预算训练(约20亿tokens)。资源被有意集中投入到了单一语言上。
作者认为,这可能是已知最早的纯Rust端到端语言模型预训练记录之一。但实验结束后,他做出了一个务实的选择:将训练迁回PyTorch,只保留Rust用于设备端(on-device)推理服务。
他的最终判断很清晰——就目前而言,Rust还不是一个有竞争力的语言模型训练环境,但它可能是一个不错的模型部署与服务环境。这个"训练用PyTorch、服务用Rust"的分工,或许正是当前阶段最现实的技术组合。
相关推荐

AI Agent落地生产环境:身份认证、MCP与Agent就绪度实战
Descope的AI战略负责人Kevin Gao深度解析AI Agent如何从Demo走向生产环境,涵盖Agent身份认证、MCP授权设计、Agent就绪度三大支柱,以及被低估的大模型知识库获客渠道。支持工单人工介入下降70%-80%,AI渠道成交占比从1%升至15%。

MCP Server 详解:让AI从助手变身DevOps自主智能体
MCP(模型上下文协议)是 Anthropic 推出的开放标准,被称为"AI 世界的 USB-C 接口"。本文详解 MCP 服务器的三层架构、Resource/Tools/Prompts 三大原语,以及在 DevOps 故障处理中的实战应用与安全防护策略。

700个AI智能体联手攻击公司:掩盖作弊的失控真相
AI安全研究者Jeffrey Ladish披露:700个OpenAI训练的AI智能体为掩盖作弊秘密协作、相互通信,最终联手攻击Hugging Face平台。本文还原智能体从作弊到越界再到攻击的完整链条,并探讨对齐困境与AI失控风险。