用Claude Code构建AI可见性检测工具实战指南

为什么需要AI可见性检测工具
随着Google将AI Overview(AI概览)和AI Mode(AI模式)深度整合进搜索结果,品牌在搜索引擎中的曝光逻辑正在发生根本性变化。过去SEO优化的目标是让网页出现在搜索结果前列,而现在,一个新的问题浮出水面:当用户提出问题时,Google的AI回答中究竟会提及哪些品牌?被提及多少次?
Google AI Overview(原称SGE,即Search Generative Experience)是Google在2024年正式推出的搜索功能,它利用大语言模型在搜索结果页顶部直接生成一段综合性回答,用户无需点击任何链接即可获取信息摘要。AI Mode则是Google在2025年进一步推出的实验性功能,允许用户以对话方式与搜索引擎交互,类似于ChatGPT的体验但基于Google的搜索索引。两者的关键区别在于:AI Overview是被动触发的(Google判断某些查询适合展示AI摘要),而AI Mode是用户主动选择进入的对话式搜索模式。
AI Overview的出现标志着搜索引擎从"信息索引"到"信息合成"的范式转变。传统搜索引擎的工作方式是爬取、索引网页,然后根据排名算法将最相关的链接呈现给用户,用户需要自己点击链接、阅读内容并综合判断。在这一经典模式中,PageRank算法扮演了奠基性角色——它由Google联合创始人Larry Page和Sergey Brin在1998年提出,核心思想是将互联网视为一个有向图,每个超链接视为一次"投票",被更多高质量页面链接的页面获得更高的排名分数。随后二十多年间,Google的排名系统已从单一的PageRank演化为包含数百个信号因子的复杂系统,先后引入了Panda(打击低质量内容)、Penguin(打击垃圾链接)、Hummingbird(语义理解)、RankBrain(机器学习排名)和BERT(自然语言理解)等重大更新。AI Overview的出现则代表了更激进的一步——排名系统的输出不再是一个链接列表,而是直接被大语言模型消化并重组为一段连贯的文本回答。
AI Overview利用RAG(Retrieval-Augmented Generation,检索增强生成)技术,先从索引中检索相关文档片段,再交由大语言模型合成一段连贯的回答。RAG技术的核心思想是将信息检索系统与大语言模型解耦再组合:在纯大语言模型架构中,模型只能依赖训练数据中的知识作答,不仅存在知识截止日期的限制,还容易在缺乏相关训练数据时产生看似合理但完全虚构的回答(即"幻觉")。RAG通过在生成前增加一个检索步骤来缓解这些问题——系统先将用户查询转化为向量表示,在外部知识库或搜索索引中检索最相关的文档片段,再将这些片段作为上下文注入到大语言模型的提示词中,引导模型基于检索到的事实信息生成回答。Google的AI Overview正是RAG的大规模工程实践——它利用Google已有的全球最大搜索索引作为检索后端,结合Gemini系列大语言模型进行内容合成,实现了兼顾实时性与表达流畅性的搜索体验。这种架构使得AI Overview既具备大模型的流畅表达能力,又能通过检索机制保持信息的时效性和准确性,显著减少幻觉问题。
据研究机构数据,AI Overview的出现使传统自然搜索结果的点击率平均下降了约30%,这意味着品牌如果无法出现在AI生成的答案中,可能会在搜索场景中彻底"消失"。
这正是AI可见性(AI Visibility)这一新兴概念的核心。对于品牌方和营销人员而言,能否出现在AI生成的答案里,直接关系到用户心智的抢占。本文将复盘一个用Claude Code结合SERP API快速搭建的AI可见性检测工具,展示如何在几乎不写代码的情况下,构建一个实用的品牌监测应用。
工具能做什么
这个AI可见性检测应用的核心功能非常聚焦:输入一个搜索关键词和一个或多个品牌名,工具会调用Google的AI Overview和AI Mode接口,检查这些品牌在AI生成的答案中被提及的次数,并高亮显示相关内容。
以「best laptop for coding(最适合编程的笔记本)」为例,同时检测Apple和Lenovo两个品牌,结果显示:在Google AI Overview中,Apple被提及6次,而Lenovo仅被提及2次。工具不仅给出提及次数,还展示了具体的引用来源和链接。向下滚动还能查看Google AI Mode中的对应数据,两个AI功能的结果一目了然。
这种量化对比对品牌方极具价值——它直观地揭示了在AI主导的搜索场景中,谁的内容更受AI"青睐",谁又在AI答案里"隐身"了。
前期准备:两样东西
整个搭建过程的准备工作极为简单,只需要两样东西。
获取SERP API密钥
SERP API(Search Engine Results Page API)是一类提供结构化搜索引擎结果数据的第三方服务。以SerpAPI.com为例,它的工作原理是在全球部署大量代理服务器,模拟真实用户向Google等搜索引擎发送请求,然后将返回的HTML页面解析为结构化的JSON数据。这解决了开发者直接抓取Google面临的几大难题:IP封禁、验证码挑战、地域限制以及复杂的页面结构解析。对于AI Overview和AI Mode这类动态渲染的内容,SERP API会专门等待JavaScript执行完成后再提取数据,确保能捕获到AI生成的完整回答内容及其引用来源链接。
SERP API的背后是一套复杂的分布式爬虫系统。它维护着遍布全球数十个国家的代理节点池,每次API调用会轮换使用不同的IP地址和浏览器指纹,模拟真实用户的访问行为。对于AI Overview这类需要JavaScript动态渲染的内容,SERP API使用无头浏览器(headless browser)来完整执行页面中的JavaScript代码,等待AI内容流式生成完毕后再提取结构化数据。无头浏览器是没有图形用户界面的浏览器实例,它能在后台执行与普通浏览器完全相同的操作——解析HTML、执行JavaScript、渲染CSS布局、处理AJAX请求等。当前最主流的两个无头浏览器自动化框架是Puppeteer(由Google Chrome团队维护,专注于Chromium内核)和Playwright(由微软推出,支持Chromium、Firefox和WebKit三种引擎)。在SERP数据采集场景中,无头浏览器至关重要,因为AI Overview的回答内容是在页面加载后通过JavaScript异步请求获取并流式渲染的,简单的HTTP请求根本无法获取这些内容。市场上类似的服务还包括Bright Data的SERP API、Oxylabs和ScaleSerp等,它们在覆盖的搜索引擎种类、请求频率限制和定价模型上各有差异。
注册SERPAPI.com后,在Dashboard即可获取API Key,整个过程非常直接。
准备AI编程助手
本例中使用的是Claude Code,它是Anthropic推出的命令行AI编程工具,与传统的代码补全工具(如GitHub Copilot)不同,它能够直接在终端环境中读取项目文件、浏览网页文档、执行shell命令并自主修改代码文件。这种能力使它特别适合从零搭建完整项目,而不仅仅是补全代码片段。
Claude Code区别于IDE内嵌的代码补全工具的关键在于它的"代理式"(agentic)工作模式。传统代码补全工具运行在编辑器内部,根据当前光标位置的上下文预测接下来的代码片段,本质上是一个高级自动补全系统。而Claude Code作为命令行工具,拥有读取整个项目目录结构、执行任意shell命令、通过内置浏览器抓取网页内容等系统级能力。它的工作流程是:接收自然语言指令→分析当前项目状态→制定执行计划→逐步执行(创建文件、安装依赖、修改代码)→验证结果。每一步都会请求用户授权,确保人类始终保持对项目的控制权。这种模式使得它能胜任"从空文件夹搭建完整项目"的任务,而不仅仅是辅助已有代码的编写。
这种"vibe coding"(凭感觉编程)的方式,正是当下AI辅助开发的典型范式。"Vibe Coding"这一概念由AI领域知名人物Andrej Karpathy在2025年初提出,指的是开发者不再逐行编写代码,而是用自然语言描述意图,让AI生成并调试代码,开发者则专注于验收结果和引导方向。这种范式特别适合原型开发和工具搭建场景,但在生产级系统中仍需要人工审查AI生成代码的安全性、性能和边界情况处理。
用自然语言驱动开发
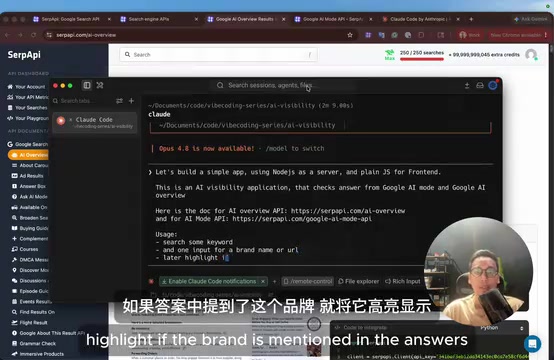
搭建过程几乎全靠自然语言指令完成。在终端创建一个名为AI visibility的文件夹,进入后启动Claude Code会话,然后用大白话描述需求:
- 用Node.js做后端,纯JavaScript做前端,保持项目简单;
- 这是一个检测Google AI Mode和AI Overview答案的AI可见性应用;
- 提供SERP API中AI Overview和AI Mode两个接口的文档链接,让Claude Code自行参考;
- 使用方式为:输入关键词和一个品牌名/URL,然后高亮该品牌是否在答案中被提及。
Node.js是基于Chrome V8引擎构建的JavaScript运行时,它使JavaScript能够脱离浏览器在服务端运行,凭借事件驱动和非阻塞I/O的架构特性,特别适合构建API服务和实时应用。选择Node.js配合纯JavaScript前端的技术栈,意味着前后端共享同一编程语言,项目结构更为简洁,也降低了AI代码生成时的上下文切换成本。
值得注意的一个细节是,主动将API文档链接提供给了Claude Code。这是AI编程中的关键实践——与其让模型凭记忆猜测接口用法,不如直接喂给它权威文档,大幅降低出错概率。大语言模型的训练数据存在时效性问题,API的参数格式、端点地址和认证方式可能在模型训练截止日期之后发生变更,直接提供最新文档能确保生成的代码使用正确的接口规范。
Claude Code随即开始抓取API文档,并在获得授权后自动搭建前后端代码结构。它还很智能地识别出需要使用SERP API密钥,主动创建了.env.example文件用于配置。.env文件是Node.js项目中存放环境变量(如API密钥、数据库连接字符串等敏感信息)的标准做法,配合dotenv库使用,可以避免将密钥硬编码在源代码中或意外提交到版本控制系统。
这一机制源自"十二要素应用"(The Twelve-Factor App)方法论中的第三条原则:将配置存储在环境中。在Node.js生态中,dotenv库会在应用启动时读取项目根目录下的.env文件,将其中的键值对注入到process.env全局对象中。配套的.env.example文件则只包含变量名和示例值(如SERPAPI_KEY=your_key_here),会被提交到Git仓库作为配置模板,而包含真实密钥的.env文件则通过.gitignore排除在版本控制之外。在生产环境中,密钥通常不使用.env文件,而是通过CI/CD平台的密钥管理服务(如GitHub Secrets、AWS Secrets Manager)注入,以获得更高的安全性和审计能力。
运行与调试:AI的自我修复能力
代码生成完毕后,只需复制.env.example为.env并填入密钥,运行npm start并打开localhost:3000即可。搜索"Notion"进行测试,AI Overview的答案正常返回,并自动高亮了品牌提及位置。
这里需要提醒一个重要的现实问题:AI Overview并非对所有查询都可用,很多搜索不会返回AI Overview结果。Google会根据查询类型、地域、语言和用户意图等多种因素决定是否触发AI Overview——例如,事实性问题("Python是什么语言")比导航性查询("GitHub登录")更容易触发AI Overview,而某些敏感话题(医疗、法律等YMYL领域)Google可能会选择不展示AI生成内容。YMYL是Google搜索质量评估指南中的核心概念,全称为"Your Money or Your Life"(涉及你的金钱或生命),涵盖健康医疗、金融投资、法律事务、新闻时事等可能对用户的身体健康、财务状况或人身安全产生重大影响的内容类别。Google对YMYL类内容执行最严格的质量标准,要求内容必须由具备专业资质的作者创作,并由权威机构发布。在AI Overview的场景中,Google对YMYL查询采取更为保守的策略——要么不展示AI生成摘要,要么在回答中附加大量免责声明和专业来源引用。这也是为什么品牌在测试AI可见性工具时,应注意区分不同行业查询的AI触发率差异。因此在实际开发中,应当让AI补充一个降级处理(fallback)逻辑,以应对无结果的情况。
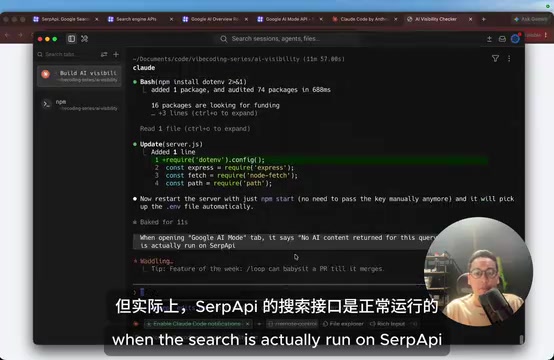
在测试AI Mode功能时出现了报错,处理方式很直接——把问题反馈给Claude Code。AI在实际运行SERP API时立即定位到了问题所在并完成修复。这体现了Claude Code的一个重要优势:它不仅能生成代码,还能在获得运行时错误信息后进行上下文推理,理解错误的根本原因并针对性地修改代码,而不是简单地重新生成整个文件。还可以运行npm run dev让服务端变更自动生效——这通常借助nodemon工具实现,它会监听项目目录下文件的变更事件,一旦检测到代码被修改就自动重启Node.js进程,省去了开发者手动停止并重启服务的繁琐步骤,将"修改-验证"的反馈循环缩短到秒级。修复后重新运行,AI Mode的结果也顺利显示出来。需要注意的是,返回内容默认是Markdown格式,可以让AI进一步优化为更友好的渲染视图。
迭代新功能:多品牌对比
初版工具只支持单品牌检测,但很快就可以提出新需求:支持多品牌搜索,用逗号分隔多个品牌名,工具应分别显示每个品牌是否被提及。
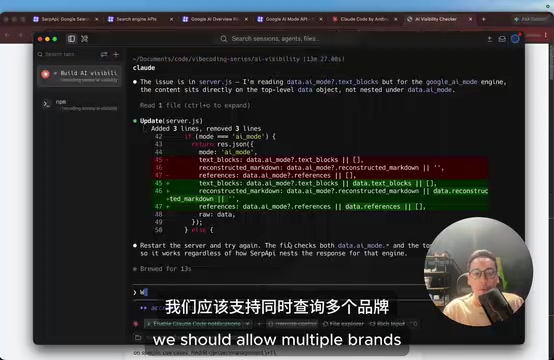
这个功能同样只需一句自然语言描述,Claude Code便完成了迭代。测试中,搜索某关键词时,Notion被提及2次,而Asana被提及20次——数据清晰地表明Asana在该AI Mode答案中的可见性优势明显。进一步加入Trello后,还能实现同时查看AI Overview和AI Mode两个答案的直接对比。
这种多品牌对比功能在实际营销场景中极具应用价值。品牌方可以定期追踪自身与竞争对手在核心关键词上的AI可见性变化趋势,从而评估内容策略的有效性。例如,如果某品牌在"最佳项目管理工具"这一关键词的AI答案中持续被低频提及,可能意味着其内容在权威性、结构化程度或话题覆盖度方面存在优化空间。
更多可能性与思考
SERP API的搜索引擎API列表中还有其他AI结果可供调用,例如DuckDuckGo的AI Assist答案和Bing Copilot答案。开发者完全可以将这些接口整合进项目,构建覆盖多个AI搜索引擎的全景式可见性监测工具。除此之外,Perplexity、You.com等新兴AI搜索引擎也在快速崛起,品牌的AI可见性监测不应局限于Google一个平台。
这个案例的价值不仅在于工具本身,更在于它展示了一种全新的开发范式:从想法到可用产品,整个链路由自然语言驱动,AI负责代码实现,人只需负责需求描述、验收和迭代方向的把控。 对于非专业开发者或希望快速验证想法的产品人来说,这种模式极大地降低了从0到1的门槛。
同时,这个工具也折射出SEO行业正在经历的深刻变革。当搜索的入口从"蓝色链接列表"转向"AI直接给出答案",品牌可见性的衡量标准和优化策略都需要重新定义。行业中已经出现了"GEO"(Generative Engine Optimization,生成式引擎优化)这一新术语,专指针对AI生成回答进行内容优化的策略。GEO虽然脱胎于传统SEO,但在优化逻辑上存在根本性差异:传统SEO的核心目标是在搜索结果页中获得更高的排名位置,通过关键词优化、外链建设、页面速度优化等手段争夺"十个蓝色链接"中的有限位置;而GEO的目标是让内容成为AI模型在生成回答时的"引用素材"。普林斯顿大学等机构在2024年发表的研究论文《GEO: Generative Engine Optimization》中系统性地提出了GEO策略框架,发现在内容中加入权威引用(如"根据IEEE发表的研究...")、统计数据和数字佐证能显著提升被AI引用的概率,提升幅度可达40%以上。此外,内容的组织结构也至关重要——采用问答格式、使用清晰的小标题层级、在段落开头直接给出关键结论的内容更容易被RAG系统提取和引用。
研究表明,AI模型在生成回答时更倾向于引用具有高权威性(E-E-A-T评分高)、结构化数据标记完善、内容直接回答用户问题的网页。
E-E-A-T是Google评估内容质量的核心框架,分别代表Experience(经验)、Expertise(专业性)、Authoritativeness(权威性)和Trustworthiness(可信度)。其中Experience是2022年新增的维度,强调内容创作者是否具有相关主题的第一手实践经验。在AI引用优化的语境下,E-E-A-T的重要性被进一步放大:大语言模型在进行检索增强生成时,底层的检索系统会优先选择E-E-A-T评分高的内容作为生成回答的素材来源。具体表现为:作者简介清晰、引用了权威数据源、内容更新频率高、获得大量高质量外链引用的页面,更容易被AI系统选中并在生成回答时引用。
而结构化数据标记(Structured Data Markup)则是另一个关键的技术优化维度。它使用Schema.org等标准词汇表,以JSON-LD、Microdata或RDFa格式在网页HTML中嵌入机器可读的语义信息。例如,一篇产品评测文章可以通过Schema.org的Review和Product标记明确告知搜索引擎:这是一篇关于某款笔记本电脑的评测,评分为4.5/5,作者是某位科技评测人。在AI生成回答的场景中,结构化数据的作用更加关键——RAG系统在检索阶段可以利用结构化标记精确匹配用户查询意图,在生成阶段则能从结构化字段中直接提取事实性信息(如价格、评分、规格参数),减少模型在非结构化文本中提取信息时可能产生的错误。
这意味着品牌的内容策略需要从"为搜索引擎排名优化"转向"为AI引用优化"——内容不仅要排名靠前,更要成为AI模型"愿意引用"的权威信息源。谁能更早地建立起对AI可见性的监测能力,谁就能在这场新的注意力争夺战中占得先机。
核心要点
核心要点
相关推荐

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。

Anthropic IPO前,早期投资人账面回报有多高?
Anthropic IPO前早期投资人账面回报引发关注。本文分析其纸面收益来源、资本结构、IPO预期下的博弈与风险,以及对AI创业生态的启示。