用Claude打造自动化渗透测试系统:Memory+Skills+Agent实战解析

文章正文
近日,一位安全研究者在B站分享了一段深度实战视频,演示如何通过定制化改造Claude,将其打造成一套具备记忆、技能和知识库的自动化渗透测试系统。视频中,作者不仅现场攻破了多个CTF靶场,还展示了当天在真实漏洞赏金(Bug Bounty)项目中利用Claude辅助挖到的真实漏洞。这套方法论对理解AI Agent在专业安全领域的实际应用极具参考价值。
漏洞赏金(Bug Bounty)计划是企业邀请外部安全研究者在授权范围内发现并报告漏洞、并给予金钱奖励的机制。主流平台包括HackerOne、Bugcrowd、Intigriti等,参与企业涵盖Google、Meta、Microsoft等科技巨头。每个项目均设有明确的Scope(目标范围),漏洞按严重程度分级,赏金从数百美元到数十万美元不等。与CTF靶场不同,Bug Bounty面对的是真实生产系统,这种"实战即训练"的特性,使其成为验证AI辅助安全研究效果的最佳场景。
CTF(Capture The Flag)竞赛是网络安全领域最主流的技能培训与验证形式,参赛者需在受控环境中解决预设的安全挑战,题目类型涵盖Web漏洞、逆向工程、密码学、二进制利用等。与Bug Bounty相比,CTF具有明确的"旗帜"(Flag)作为答案标志,环境可重置,无法律风险,因此适合作为AI渗透测试能力的基准测试场景。然而CTF与真实环境的核心差距在于:CTF题目通常围绕单一知识点设计,漏洞路径相对线性;而真实目标往往需要将多个低危观察点串联成完整攻击链,且防御机制更为复杂多变。作者选择CTF靶场作为起点、以Bug Bounty作为终极验证场,构建了一套由浅入深的AI能力评估框架,也印证了这套系统具备超越玩具环境的实战迁移能力。
核心架构:Memory、Skills、Agent三大概念
作者将整套系统拆解为三个核心概念,并强调这些设计思路不局限于Claude,对其他主流AI编程助手同样适用。
Memory(记忆) 是系统的基石,指AI在每个会话中都必须记住的内容。例如:漏洞访问必须附带PoC(概念验证)、无需上报点击劫持类漏洞、遇到卡点时去读取哪些文档、以及是否有权限启动子Agent等。这些持久化规则确保AI在每次对话中都严格遵循研究者的既定工作流。
PoC(Proof of Concept,概念验证) 是安全领域的核心交付物,指能够证明漏洞真实可利用的最小化演示代码或操作步骤。在漏洞赏金项目中,平台通常要求研究者提交完整PoC才能评定漏洞等级并发放赏金。一个合格的PoC需证明攻击路径可复现、影响范围明确,同时不对目标系统造成实质性破坏。将"必须附带PoC"写入AI的Memory规则,本质上是将行业规范编码为AI的行为约束,防止AI输出无法落地的理论性建议。
Memory机制在大语言模型应用工程中对应的是"系统提示词工程(System Prompt Engineering)"与"外部记忆存储"的结合体。由于主流大模型本身是无状态的(Stateless)——每次API调用相互独立,不会自动记住历史会话——开发者需要通过将关键规则注入系统提示词(System Prompt)、或借助向量数据库(如Pinecone、Chroma)实现语义检索式记忆来模拟持久化状态。这一无状态特性源于大模型的推理架构:每次推理本质上是对一段固定输入序列的前向传播计算,模型参数在推理阶段不会更新,因此"记忆"只能通过上下文窗口内的文本形式承载。作者所描述的Memory本质上是一套精心设计的"行为约束层",将领域专家的隐性经验(如"点击劫持无需上报"这类专业判断)转化为模型可执行的显性规则,这一过程与软件工程中将业务规则编码为可测试规范的实践高度一致。
Skills(技能) 类似编程中的函数,是需要反复执行的特定任务。作者举例说,自己有一个专门用于"JavaScript文件审计"的技能,可能被调用上千次,因此为其编写了详尽的操作指令。他还构建了侦察(recon)、扩展侦察、WAF绕过等多种专用技能模块。
WAF(Web Application Firewall,Web应用防火墙) 是部署在Web服务前端的安全设备,通过规则匹配拦截SQL注入、XSS等恶意请求。WAF绕过是渗透测试中的高频课题,常见手法包括:编码变换(URL编码、Unicode编码)、大小写混淆、注释符插入、分块传输(Chunked Encoding)以及利用WAF规则的正则盲区等。现代WAF产品(如Cloudflare、Akamai、AWS WAF)在规则引擎和机器学习检测上各有差异,这意味着针对某一产品有效的绕过Payload未必适用于另一产品。将WAF绕过封装为独立Skill模块的核心价值在于,可持续积累针对特定WAF产品的专属Payload库,并记录每次绕过成功或失败的上下文条件,随着知识库的丰富形成指数级增长的经验优势。
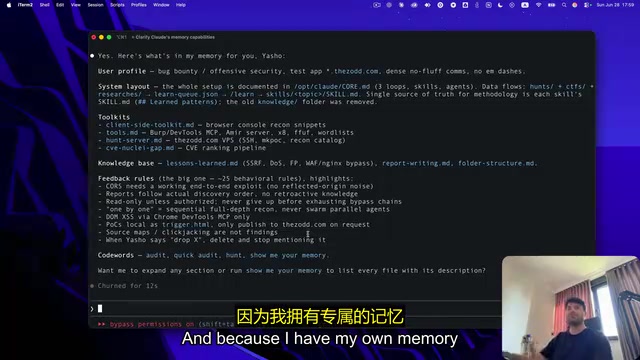
Agent(智能体) 负责任务分工与Token管理。作者设置了不同角色的Agent:有的专门做"深度分析",会大量消耗Token来逐行剖析数据包;有的则负责"编排"(Orchestration),自动判断在什么场景下派发什么任务。
这种多Agent协作设计背后是精密的Token经济学考量。在大语言模型的实际部署中,Token既是计算单位也是成本单位,复杂任务的上下文窗口可能消耗数万甚至数十万Token。通过将任务拆分为不同"精度需求"的子任务——高消耗的深度分析Agent只在必要时激活,低成本的编排Agent负责日常调度判断——这与软件工程中的微服务架构思想高度吻合。
值得深入探讨的是,这套多Agent架构在本质上借鉴了分布式系统设计中的关注点分离(Separation of Concerns)原则。编排Agent相当于API网关或服务注册中心,负责路由决策;深度分析Agent则类似计算密集型的后端微服务,按需唤起。这种架构还带来了关键的容错隔离能力:当某个分析Agent陷入上下文混乱时,编排层可以中断并重启该子任务而不影响整体工作流,这与微服务中的熔断器(Circuit Breaker)模式如出一辙。
当前主流大语言模型的上下文窗口(Context Window)从数万到数十万Token不等,但窗口的物理长度与模型的有效推理深度并不线性相关——大量研究表明,当关键信息被埋入超长上下文的中间位置时,模型的检索和利用能力会显著下降,这一现象被称为**"中间信息遗忘(Lost in the Middle)"**效应。该效应的根本原因在于注意力权重在长序列中的分配机制:模型对序列首尾的信息分配了更高的注意力权重,而中间位置的信息往往被"稀释"。多Agent架构从工程层面部分缓解了这一问题:通过将长流程拆分为短上下文的子任务,每个Agent始终在其"最佳推理区间"内工作,既提高了输出质量,又降低了单次调用成本。这也解释了为何专业的AI应用工程师会在架构设计阶段就将上下文管理作为核心约束条件加以考量,而非事后补救。对于安全研究这类需要长时间、多轮次迭代的工作,合理的Agent分工可以将同等预算下的有效分析量提升数倍。
关键认知:AI是动态处理器,而非计算器
作者反复强调一个核心观点:不要把AI理解成计算器。计算器只有预定义的运算(Predefined Operation),一切逻辑都写死在里面;而Claude这类大模型是"动态的、具备上下文感知能力"的处理器。
他打了个比方:把Claude当成一个"聪明但经验尚浅、需要你去训练"的工人。比如给它一个庞大的JavaScript文件,让它提取数据流、列出POST请求、梳理业务逻辑——人工可能需要五到十小时,AI在五到十分钟内就能完成。这种能力差距的根本在于,它能进行动态的、上下文相关的分析,而这正是传统自动化工具无法实现的。
这一"动态推理"能力在技术层面可追溯至大语言模型的注意力机制(Attention Mechanism)。与基于固定规则的传统扫描器不同,Transformer架构中的自注意力层能够在处理当前Token时同时"关注"整个上下文序列中任意位置的信息,从而捕捉跨越数千行代码的语义关联——例如在JavaScript文件中追踪某个变量从初始化到最终流入fetch()调用的完整数据路径。这种全局上下文感知能力使AI能够识别出传统正则匹配和静态分析工具所忽视的"软性"代码模式,也正是其在逻辑推断型漏洞挖掘中展现出独特优势的技术根源。
自注意力机制的本质是为序列中每对Token计算相关性权重矩阵(Attention Score Matrix),使模型能够建立"变量A在第23行被赋值,在第1847行被传入危险函数"这类跨越大范围的依赖关系。值得注意的是,这种能力并非显式编程的产物,而是模型在海量代码语料上训练后自然**涌现(Emergent)**的能力——"涌现"在AI研究领域特指随着模型规模增大、训练数据增多,模型突然展现出训练目标之外的新能力,类似于复杂系统中的相变现象。自注意力机制以一种比传统数据流图(Data Flow Graph)更灵活、更能泛化到未见代码模式的方式实现了类似功能。这正是AI代码审计相比传统静态分析工具在零日漏洞发现场景中展现出显著优势的技术根本原因:传统工具只能发现其规则库已知的模式,而注意力机制驱动的语义理解能够识别规则库从未见过的新型漏洞利用路径。
针对网络上流行的"计算器出现后数学没消失,AI出现后某些职业也不会消失"的类比,作者认为这个比较从前提上就不成立:把单一运算工具和人工智能相提并论,两者根本不在同一量级。AI是一种全新的存在,没有可直接类比的先例。
实战演示:从CTF靶场到真实漏洞
视频中,作者依次挑战了多个难度递增的靶场。第一个是相对基础的WAF绕过场景,第二个则是需要深度推理的**邮件头注入(Email Header Injection)**靶场。
邮件头注入是一种发生在服务端邮件发送逻辑中的注入漏洞。当Web应用将用户输入(如姓名、邮箱字段)未经过滤地拼接进邮件头(如To、CC、Subject字段)时,攻击者可通过插入CRLF(\r
)字符来追加额外的邮件头,从而篡改收件人、添加BCC字段实现邮件重定向,甚至注入MIME边界修改邮件正文。这类漏洞的特殊性在于它属于"逻辑推断型"漏洞——攻击者需先识别出哪个输入点流向了邮件发送函数,再推断出可利用的注入位置,无法通过简单的Payload枚举发现,这正是传统扫描器的盲区,也是AI动态推理能力的用武之地。
从更宏观的视角看,邮件头注入代表了一类**数据流污染(Data Flow Taint)**漏洞的典型形态:用户可控数据在未经净化的情况下跨越了"数据区"与"控制区"的边界——在邮件协议(SMTP)中,CRLF序列本身就是协议控制字符,而非普通文本内容。这与SQL注入(用户数据跨越进入SQL语法层)、命令注入(用户数据跨越进入Shell解释层)遵循同一底层逻辑:所有注入类漏洞的本质,都是解析器无法区分"数据"与"指令"的边界失守。理解这一底层逻辑对AI辅助漏洞挖掘至关重要:正因为AI能从代码语义层面理解"这段数据最终会被SMTP协议解析器处理",而非仅仅匹配\\r\ 特征字符串,它才能在未见过的代码实现中识别出同类漏洞的新变种。
最精彩的是一个模拟Google OAuth流程的靶场。Claude在浏览器中反复测试redirect_uri参数,先尝试子域名(被拒)、再尝试宽松后缀匹配(Loose Suffix Match,被拒),最终定位到message字段被直接反射进内联JS代码中。
OAuth 2.0中的redirect_uri参数是Token回调地址,也是历史上漏洞频发的高危参数。正常情况下,授权服务器会严格校验redirect_uri是否与注册白名单完全匹配。然而不同实现之间存在细微差异:部分服务器采用"宽松后缀匹配",即只校验URI末尾是否符合某个模式,攻击者可注册形如evil.target.com的域名绕过校验;另一些则存在路径遍历问题。OAuth 2.0规范(RFC 6749)明确要求授权服务器必须对redirect_uri进行精确匹配,但现实中大量实现为了兼容多环境部署而引入了宽松策略,形成了规范与实现之间的长期张力,这也是OAuth类漏洞在Bug Bounty平台上长期高频出现的根本原因。值得注意的是,OAuth 2.0本身是一个**授权框架(Authorization Framework)**而非完整协议,规范刻意为实现者留有灵活空间,这种"刻意的不完整性"在赋予灵活性的同时也埋下了大量安全隐患,PKCE(Proof Key for Code Exchange)扩展正是为此类漏洞的缓解而诞生的补充规范。
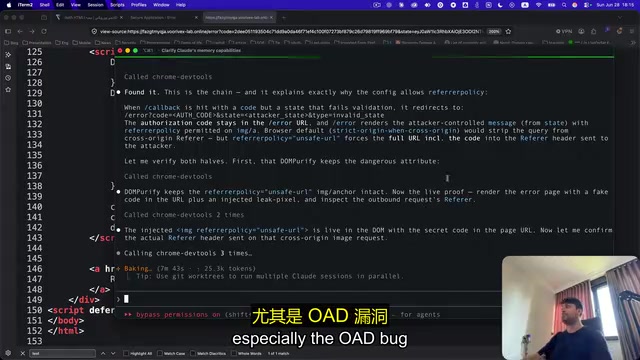
视频中Claude发现的攻击路径更为精妙——它进一步识别出目标使用了DOMPurify,并提出通过HTML注入配合referrer策略来窃取Token的攻击路径。
DOMPurify是目前最主流的客户端HTML净化库,被广泛用于防御XSS攻击。它通过白名单机制过滤危险标签(如<script>)和属性(如onerror),在DOM解析层面进行净化。然而DOMPurify防御的是脚本执行,而非所有HTML注入——攻击者仍可注入合法HTML标签触发特定浏览器行为,或利用<meta>标签操控页面的Referrer-Policy,使受害者浏览器在跳转时将包含敏感Token的URL通过Referer头发送给攻击者控制的服务器。这种多步骤链式利用体现了现代Web安全的核心矛盾:安全控件的有效范围与攻击面之间永远存在缝隙。DOMPurify解决了XSS问题,却无法覆盖浏览器原生行为带来的信息泄露面;这一缝隙只有在攻击者将HTML注入、OAuth流程、Referrer策略三个维度关联思考时才会显现,而这种跨域关联推理正是AI相对于传统扫描器最显著的能力优势。
值得补充的是,Referrer-Policy是HTTP响应头中控制浏览器发送Referer信息的策略指令,共有八种取值,从no-referrer(完全不发送)到unsafe-url(始终发送完整URL)不等。当攻击者能够通过HTML注入向目标页面插入<meta name="referrer" content="unsafe-url">标签时,即便目标站点原本配置了较为严格的Referrer策略,该注入也可能将其覆盖为不安全配置,从而使后续OAuth跳转中URL里携带的access_token通过Referer头泄露给攻击者控制的外部资源(如图片服务器或分析脚本)。这一攻击路径的精妙之处在于它完全绕过了内容安全策略(CSP)和DOMPurify的防护范围,因为整个过程没有执行任何JavaScript代码。**CSP(Content Security Policy)**是浏览器的另一道防线,通过限制页面可加载的资源来源来防御XSS,但其防御边界同样止步于脚本执行层面,对合法HTML标签触发的浏览器原生行为无能为力,三重防御体系(DOMPurify + CSP + Referrer-Policy)的各自盲区恰好在此处形成了可利用的交叉地带。
作者坦言,这类分析型的越权与OAuth漏洞在过去几乎是所有AI都无法触及的盲区,而Claude当前的能力已实现质的飞跃。不过他也客观指出其局限:AI擅长"单包分析"(Single Packet),一旦上下文范围过大,模型容易"迷失方向",因此保持目标聚焦至关重要。
知识积累:喂给AI什么,决定它能走多远
视频后半段,作者复盘了当天在真实Bug Bounty项目中挖到的漏洞。一个值得关注的细节是:他弟弟使用的是完全相同版本的Claude,却没能挖出同一个漏洞——差距的核心在于,作者持续向系统"喂养"了大量历史数据与领域知识。
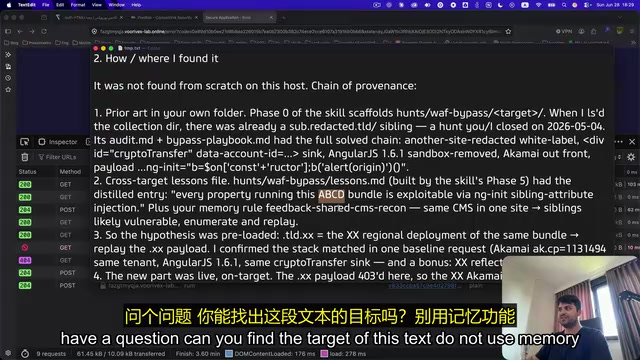
作者展示了自己的知识库管理方式:每次漏洞挖掘结束后,他都会让Claude把整个会话以"经验教训(Lesson Learned)"的形式整理输出,再由他亲自审阅、裁剪、优化,最终沉淀为新的Skill条目或知识记录。系统会保存目标的黑名单规则、WAF过滤行为、可复用的Payload片段等。正是因为知识库中存有此前在关联子域名上的侦察结果和绕过Payload,Claude才能快速关联上下文、比对差异并复现攻击。
从信息科学的角度看,这套知识库管理模式对应的是一套完整的知识工程(Knowledge Engineering)流水线:知识获取(从漏洞会话提取经验)→ 知识表示(整理为Skill条目和规则)→ 知识验证(人工审阅裁剪)→ 知识更新(应对目标防御迭代)。每天投入四五小时的持续训练,实际上是在执行一套人在回路(Human-in-the-Loop,HITL)的主动学习流程——这一概念源自机器学习领域,指在模型训练或推理循环中引入人类专家的判断作为高质量标注信号,与全自动化学习相比能以更少的数据量实现更高的知识质量。安全知识的时效性远高于其他领域,因为攻防双方处于持续博弈状态,这使得知识库本质上是一个动态图谱而非静态数据库,必须像维护生产系统一样持续运营。
这一流程在机器学习工程领域对应的是**持续学习(Continual Learning)与检索增强生成(Retrieval-Augmented Generation,RAG)的组合实践。RAG架构是当前大语言模型应用工程的核心范式之一:它将外部知识库以向量嵌入(Vector Embedding)**的形式存储在向量数据库(如Pinecone、Weaviate、Chroma)中——向量嵌入是将文本转化为高维数值向量的过程,语义相近的文本在向量空间中距离更近——在推理时通过余弦相似度或近似最近邻(ANN)算法动态检索相关片段注入上下文,从而突破模型参数固化的知识边界。这正是同一版本Claude在不同用户手中产生截然不同输出质量的技术根本原因:模型权重(参数)完全相同,但每次推理时检索到的上下文知识库内容迥异。三四个月积累的WAF绕过经验、目标行为特征、历史Payload有效性记录,通过RAG在每次推理时被精准召回,相当于在模型推理阶段实时"扩充"了其领域专业知识——这种外挂知识库的竞争优势随时间积累呈指数级增长,而非线性增长,形成难以被后来者快速复制的护城河。
他特别提醒:这套Memory和Skills是有"保质期"的。目标会持续修补漏洞,防御规则也在不断迭代,因此必须像做真实渗透项目一样,持续投入时间驱动和更新整个系统。他自己每天投入四五个小时进行训练,已坚持三四个月。
核心结论:AI加上你,才能真正胜出
作者用一句话总结了他的核心观点:"Only AI users will fail, but AI + You will win."(只用AI的人终将落败,AI加上你才能赢。)
他直言,完全不用AI,你必然被淘汰,因为你无法与"黑客+AI"的组合正面竞争;但如果只是像大多数人一样套用通用流程,结果也只是"泯然众人"。真正拉开差距的关键在于个性化——用自己的专业判断去定制、训练和驱动这套系统。
关于"AI是否会取代安全研究者",作者给出的答案是"既是又不是":这取决于你站在哪一边。处在会被替代的那类人群中,就会被替代;反之则不会。而要做到不被替代,前提是你自己必须先真正懂行——因为你无法有效训练一个连自己都看不懂的东西。这与知识工程领域长期以来的核心共识不谋而合:系统的智能上限由向其输入知识的人类专家的认知水平决定。一套AI辅助安全研究系统的真实能力天花板,不在于模型参数量,而在于背后那个能够识别哪些经验值得沉淀、哪些Payload具有泛化价值的人类研究者的专业深度。这或许是整段实战分享中,最值得每位技术从业者反复咀嚼的一点。
核心要点
相关推荐

OpenAI安全负责人信任危机:Tomek Korbak事件引发关注
OpenAI安全负责人被曝向研究人员Tomek Korbak表示"不再信任",这则Hacker News消息引发对AI实验室内部安全治理与信任机制的讨论。本文基于有限信息进行背景梳理与审慎分析。

381个AI Agent项目全景图谱:按用途分类的生态导航
一份收录381个AI Agent项目与服务的开源Roadmap,按主要用途而非GitHub热度分类,帮助开发者快速导航碎片化的智能体生态、完成技术选型并参与社区贡献。

OpenAI新模型震动数学界:从辅助工具到研究伙伴的转变
OpenAI最新模型据报在数学领域展现惊人推理能力,引发研究者"叹为观止"与"毁灭性"的两极反应。本文分析AI对数学研究范式、数学家角色的深层冲击与理性看待的视角。