用Cursor三分钟开发图片反推提示词功能实操教程

什么是图片反推提示词?
在AI绘画领域,有一个常见的痛点:我们看到一张精美的AI生成图片,想要画出类似的效果,却完全不知道该怎么写提示词。画面中的人物姿态、光影效果、环境构图、背景细节……这些视觉元素我们眼睛能看到,但要用文字精确描述出来,对大多数人来说几乎是不可能的任务。
这个痛点之所以如此普遍,与**提示词工程(Prompt Engineering)**在AI绘画中的核心地位密切相关。无论是Stable Diffusion、Midjourney还是DALL·E,生成图片的质量高度依赖于提示词的精确程度。一个专业的AI绘画提示词往往包含多个维度的描述:主体内容(subject)、艺术风格(style)、光照条件(lighting)、镜头参数(camera angle)、画面质量修饰词(如masterpiece、best quality)等。在Stable Diffusion中,用户甚至可以使用权重语法(如(keyword:1.5))来精确控制某个元素的影响强度,还需要配合负向提示词(Negative Prompt)来排除不想要的元素(如低质量、变形等)。这种复杂的提示词体系意味着,从一张图片反向还原出能复现效果的提示词,本身就是一项需要大量经验的专业技能。
图片反推提示词(也叫图片逆向提示词、Image to Prompt)就是解决这个问题的工具——让AI"长了眼睛",自动分析一张图片的内容,并生成对应的文字描述(Prompt)。拿到这些提示词后,再输入到AI绘画工具中,就能生成风格和内容高度相似的图片。
这项能力的底层依赖是近年来大模型领域最重要的突破之一——多模态理解能力。传统的语言模型(如早期的GPT-3)只能处理文本输入,而新一代多模态模型(如GPT-4V、Gemini、Claude 3等)能够同时理解图像、文本甚至音频信息。其核心原理是通过视觉编码器(Vision Encoder)将图像转换为模型可理解的向量表示,再与语言模型的文本理解能力融合,从而实现"看图说话"的能力。
具体来说,主流的视觉编码器大多基于**ViT(Vision Transformer)架构。ViT的工作方式是将一张图片切分为固定大小的小块(patch),例如将一张224×224的图片切分为196个16×16的patch,每个patch被线性映射为一个向量(类似于NLP中的token),然后送入Transformer架构进行自注意力计算。这一思路最早由Google在2020年提出,彻底改变了计算机视觉领域长期由CNN(卷积神经网络)主导的格局。而将视觉理解与语言生成能力对齐的关键技术,则源自OpenAI的CLIP(Contrastive Language-Image Pre-training)**模型——它通过在4亿组图文配对数据上进行对比学习训练,让模型学会了将图像和文本映射到同一个语义空间中。正是这种跨模态对齐能力的成熟,让图片反推提示词从一个技术难题变成了一个可以轻松调用的API服务。
本文将跟随一位B站UP主的实操教程,演示如何使用Cursor(AI编程工具)在几分钟内开发出属于自己的图片反推提示词功能。
图片反推提示词功能效果演示
在正式开发之前,先来看看最终效果。UP主随便找了一张AI绘画图片,上传后点击"反推"按钮,系统几乎秒出结果——人物特征、头发细节、环境背景等信息被AI描述得一清二楚。
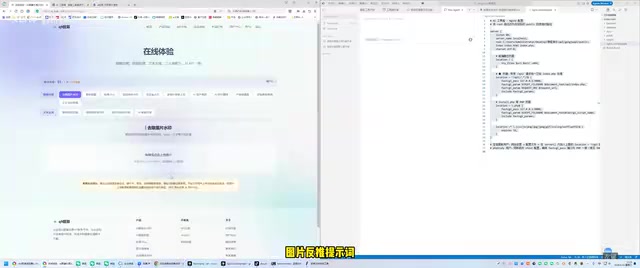
这些反推出来的提示词,无论是中文还是英文版本,直接拿去AI绘画工具中使用,大概率能生成与原图风格高度一致的作品。
关键在于:这个功能并不是什么高深的技术壁垒。市面上已经有不少网站提供类似服务,但如果我们自己能开发出来,就意味着完全掌握定价权和服务方式,可以集成到自己的产品中进行商业化。
用Cursor开发图片反推功能全流程
第一步:准备多模态API文档
图片反推提示词的核心能力来自于大模型的多模态理解能力。我们不需要自己训练模型,只需要调用现成的API接口即可。
这里所说的API(Application Programming Interface,应用程序编程接口)是软件系统之间通信的标准方式。在本场景中,我们调用的是基于RESTful架构的HTTP API——简单来说,就是我们的程序向云端服务器发送一个包含图片信息的HTTP POST请求,服务器处理后返回文字描述结果。图片的传递通常有两种方式:一种是将图片转换为Base64编码(一种将二进制数据转为纯文本的编码方式)直接嵌入请求体中;另一种是传递图片的URL链接,由服务端自行下载图片进行分析。两种方式各有优劣——Base64方式不依赖图片的外部可访问性,但会增大请求体积(Base64编码后数据量约增大33%);URL方式请求更轻量,但要求图片链接可被服务端访问。
具体操作:
- 找到提供图片反推提示词能力的API文档
- 将API文档的完整内容复制下来
- 不需要完全看懂文档的每个细节,Cursor会帮我们理解
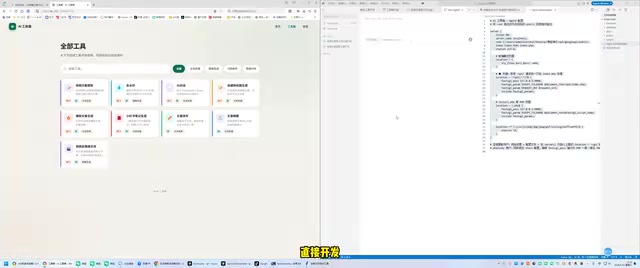
第二步:在Cursor中用自然语言提交需求
打开Cursor,直接用自然语言描述需求:"帮我开发一个功能叫图片反推提示词",然后把API文档一并粘贴给它。
这里有必要介绍一下Cursor这个工具。Cursor是基于VS Code深度改造的AI原生代码编辑器,由Anysphere公司开发。它内置了对GPT-4、Claude等大模型的深度集成,支持通过自然语言对话来生成代码、修复Bug、重构项目。与GitHub Copilot等代码补全工具不同,Cursor更强调"对话式开发"——开发者可以像和同事沟通一样描述需求,Cursor会理解上下文并生成完整的代码方案,甚至能直接修改项目中的多个文件。
Cursor的核心技术优势体现在几个层面:首先是Agent模式,在该模式下Cursor不仅能生成代码,还能自主执行终端命令、读取项目文件、分析报错日志,形成"理解需求→编写代码→运行测试→修复问题"的完整闭环;其次是多文件编辑能力,当一个功能涉及前端页面、后端接口、配置文件等多个文件的修改时,Cursor能在一次对话中同时生成所有相关文件的改动,而不是像传统代码补全工具那样只能在单个文件内工作;第三是深度上下文感知,Cursor会自动索引整个项目的代码库,理解文件之间的依赖关系、函数调用链和数据流向,从而生成与现有代码风格和架构一致的新代码。相比之下,GitHub Copilot更擅长行级和函数级的代码补全,而另一个竞品Windsurf(原Codeium)则在免费额度和轻量化方面有优势。Cursor的定位更偏向"AI全栈开发伙伴",这也是为什么整个开发过程中,UP主全程没有手写一行代码。
同时需要做两件事:
- 配置API密钥(Key):API密钥是开发者调用云端AI服务时的身份凭证和计费依据。每次调用多模态API分析图片时,服务商会根据输入的token数量(图片会被转换为等效token)和输出的文本token数量来计费。关于图片的token换算机制,不同服务商的计算方式略有差异:OpenAI的GPT-4V会根据图片分辨率将其切分为多个512×512的tile,每个tile消耗约170个token,一张1024×1024的图片大约消耗765个token;而一些国内服务商则采用固定token计费方式。以主流服务商为例,分析一张图片并生成详细描述的成本通常在几分钱到几毛钱之间,这意味着即使大规模商用,单次调用成本也极低,为个人开发者的商业化提供了可行的成本结构。
- 添加工具依赖:根据Cursor的提示,安装必要的工具包
配置完成后,在项目的工具箱中就能看到新功能已经被自动添加进去了。
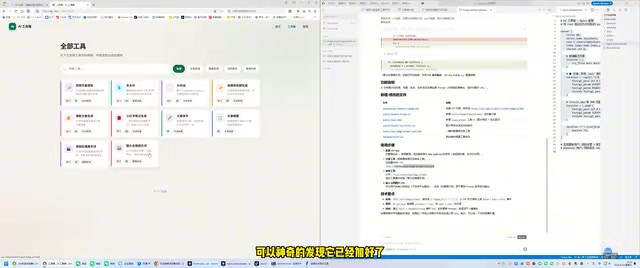
第三步:测试与调试反推结果
第一次测试时,UP主使用图片链接的方式来传入图片(因为项目还在本地运行,没有上线,所以暂时不支持直接上传图片——上线后只需几分钟就能接入对象存储来实现上传功能)。
找一张AI绘画图片,复制其链接,粘贴到输入框中,点击"反推"。
第一次运行时遇到了报错,这在开发中是完全正常的。
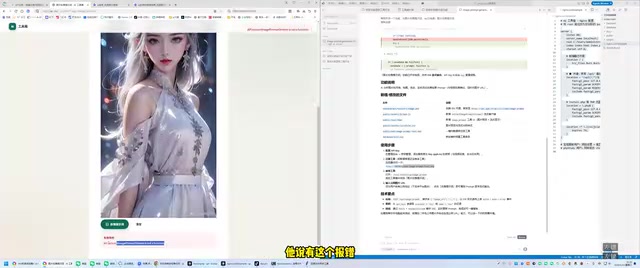
将报错信息反馈给Cursor,它会自动分析问题并修复代码。修复后重新测试,功能成功运行——详细的AI绘画提示词被完整输出,用户可以直接复制使用。
补充:如何添加图片上传功能
当前演示版本使用的是图片链接输入方式。等网站正式上线部署后,可以让Cursor帮忙添加图片上传功能,将图片存储到服务器或云端对象存储(如阿里云广告OSS、腾讯云广告COS等),同样只需几分钟即可完成。
这里提到的**对象存储(Object Storage)**是云计算基础设施中专门用于存储非结构化数据(如图片、视频、文件)的服务。与传统服务器本地存储相比,对象存储具有容量无限扩展、自动多副本备份、全球CDN加速分发等优势。在图片反推场景中,用户上传的图片会先存储到对象存储中生成一个可访问的URL,然后将该URL传递给多模态API进行分析——这是Web应用处理图片上传的标准架构模式,成本低廉且稳定可靠。
从技术实现角度看,对象存储的工作模式与我们熟悉的文件系统有本质区别。传统文件系统采用层级目录结构(文件夹套文件夹),而对象存储采用扁平化的键值对结构——每个文件(对象)由一个唯一的Key(通常是路径形式的字符串)和对应的数据内容组成,没有真正的目录层级。这种设计使其天然适合海量文件的存储和检索。以阿里云OSS为例,标准存储的价格约为0.12元/GB/月,即使存储10万张图片(按每张2MB计算,共约200GB),月成本也仅24元左右。配合生命周期管理策略(如自动将30天未访问的图片转为低频存储),成本还能进一步降低。
Cursor AI开发的核心优势
这个案例最值得关注的不是功能本身,而是它背后体现的AI开发范式变革:
开发效率实现质的飞跃
传统开发模式下,实现一个图片反推提示词功能,至少需要:
- 阅读并理解API文档
- 手写前后端代码
- 处理各种异常和边界情况
- 调试和优化
保守估计需要一周时间,如果外包则至少几千块成本。而使用Cursor,整个过程压缩到了几分钟,且不需要编写任何代码。
产品完全自主可控
自己开发意味着:
- 自主定价:想收多少钱就收多少钱
- 自由定制:功能名称、界面风格、交互方式完全自己说了算
- 数据安全:用户数据不经过第三方平台
- 快速迭代:想加新功能随时可以加
零基础也能开发可商用产品
这个教程中,开发者全程没有手写代码,也不需要完全看懂API文档。Cursor作为AI编程助手,承担了代码编写、错误修复、功能集成等所有技术工作。这意味着即使没有编程基础的人,也能开发出可商用的功能。
这种现象正在重塑整个软件行业的生产关系。据GitHub 2024年的调查数据,使用AI编程工具的开发者生产力平均提升55%以上。更深层的变化在于,软件开发的门槛正在从"必须掌握编程语言"降低到"能清晰描述需求"。
这一趋势并非凭空出现,而是No-Code/Low-Code(无代码/低代码)运动的最新演进。早在2010年代,Bubble、Webflow、Airtable等无代码平台就开始降低软件开发门槛,让非技术人员能通过拖拽组件搭建应用。但这些工具的局限性在于灵活性不足——一旦需求超出平台预设的模板和组件范围,就不得不回归传统编码。而以Cursor为代表的AI编程工具突破了这一瓶颈:它生成的是真正的源代码,具有完全的灵活性和可扩展性,同时又保持了无代码工具的低门槛特性。
这催生了一个新群体——"AI产品构建者"(AI Product Builder),他们不一定是传统程序员,但能借助AI工具将商业创意快速转化为可用产品。硅谷顶级孵化器Y Combinator(YC)的数据印证了这一趋势:在其2024年冬季批次中,solo founder(单人创始人)的比例创下历史新高,许多入选项目的创始人并非技术背景出身,而是借助AI工具独立完成了产品的MVP(最小可行产品)开发。与此同时,Indie Hacker(独立开发者)社区也在快速壮大,越来越多的个人开发者通过AI工具在几天内构建出SaaS产品并实现盈利。本文中UP主展示的开发方式,正是这一趋势的生动写照。
总结
图片反推提示词只是一个切入点,真正的价值在于这种AI辅助开发模式的可复制性。UP主展示的工具箱中还有多个类似功能,据称全部加起来也只需要几十分钟就能开发完成。
在AI时代,技术实现的成本正在趋近于零,真正的竞争力将转移到创意、运营和商业模式上。如果你有好的产品想法,现在就是最好的动手时机——Cursor这样的AI编程工具已经把"从想法到产品"的距离缩短到了前所未有的程度。
核心要点
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。