用Docker云沙箱打造自主A/B测试AI代理实战

用三类AI代理在Docker云沙箱中自动完成A/B测试全流程,从发现问题到写码修复再到评分选优。
本文介绍了一个运行在 Docker Cloud Sandboxes 上的自主 A/B 测试系统:购物者代理模拟真实用户体验并打分,分析师代理提炼修复方案,构建者代理在独立 microVM 中编写并部署代码,最后按平均分、完成率、操作步骤三级排序选出赢家。整个流程仅用约十个 SDK 调用串联,以 Promise.allSettled 确保单个版本失败不影响全局。云端一次性 microVM 提供了安全隔离、公网 HTTPS URL 和密钥保护,使运行未审查的 AI 生成代码成为可接受的工程实践。示例中,引入搜索筛选的赢家方案相较基线易用性提升 108%,而这套模式可泛化到任何「可扮演用户并评分」的优化场景。
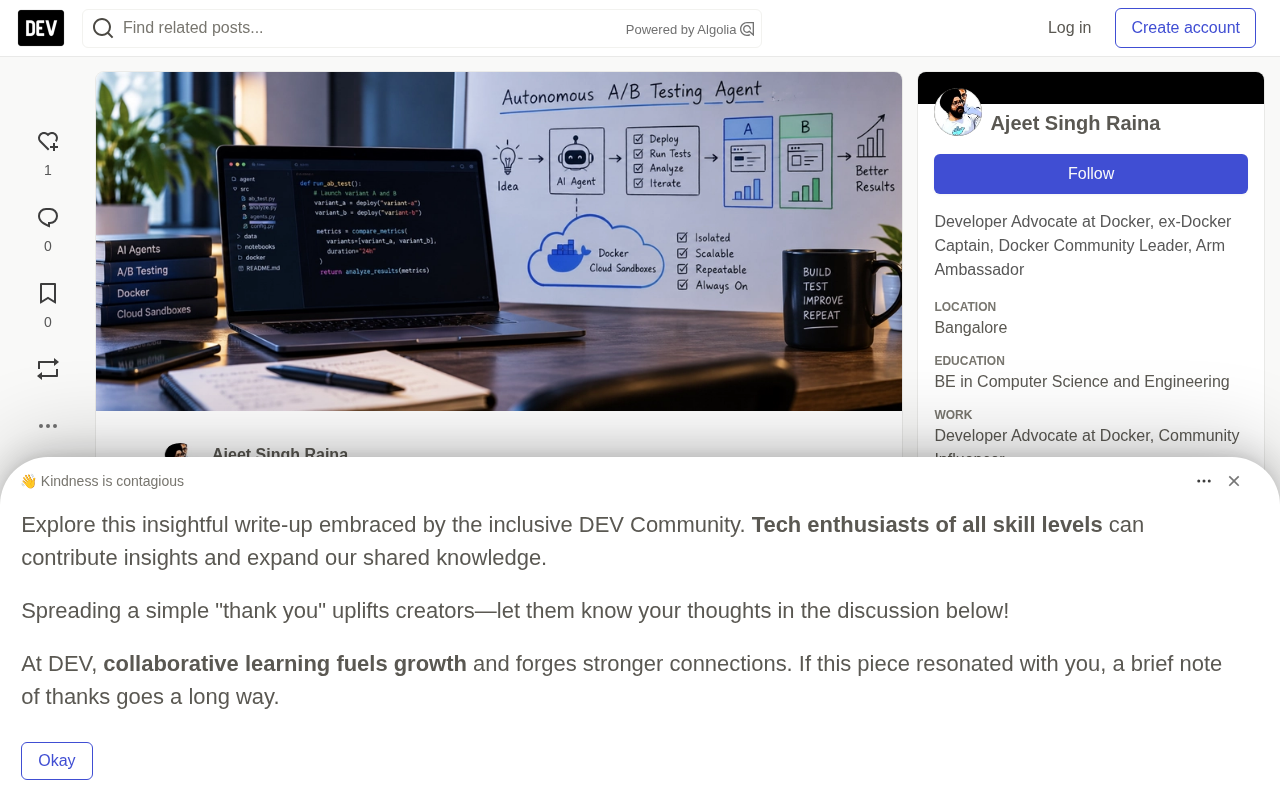
想象一下,一个AI代理能够独立完成整套A/B测试——从扮演用户体验产品、分析痛点、编写修复代码到最终评分选出赢家,全程无需人工干预。这正是本文要搭建的系统,它运行在Docker Cloud Sandboxes(云端一次性微型虚拟机)之上,通过约十个SDK调用就能把一套多代理协作流程跑起来。
完整代码已开源在 github.com/ajeetraina/sbx-ab-agent,下面拆解这个项目的设计思路与关键实现。
系统到底在做什么
设想一个简陋的在线商店:它只是把所有商品堆成一个长列表,没有搜索、没有筛选、也没有排序。这是故意设计的「问题」,等着AI代理去发现并修复。
整个自动化流程可以概括为六步:把商店部署到安全的云沙箱里;派出几位「假装的购物者」(AI代理)去体验并打分;让「分析师」代理阅读所有体验报告并提出几种修复方案;每个方案交给一个「构建者」代理在独立沙箱中写代码;用同样的购物者去测试每个新版本;最后挑出得分最高的版本,把代码拷回本地。
这就是A/B测试的本质——做几个版本,看哪个更好。原始商店是「A」,分析师提出的修复版本是「B」「C」。每个版本都是「同一个商店 + 一个小改动」,以此保证对比的公平性。
为什么必须用沙箱
构建者代理会编写并运行没人审查过的代码,你肯定不希望这种东西直接跑在自己的笔记本上。Docker Cloud Sandbox本质上是云端的一台用完即弃的微型虚拟机(microVM),它恰好提供了四样关键能力。
安全性是第一位的——即便代理干了蠢事,受影响的也只是沙箱本身。隔离性保证修复B和修复C各自拥有独立沙箱,彼此永不混淆。真实链接让每个沙箱都能分享一个公开的HTTPS URL,你可以在浏览器里打开每一个版本亲眼查看。密钥安全则意味着OpenAI密钥作为secret存储在Docker侧,沙箱在发出请求时才临时附加密钥,密钥本身从不落在沙箱内部。
所有这些都由一个使用 @docker/sandboxes SDK 的TypeScript小程序来掌控。
Docker Cloud Sandboxes 底层使用的 microVM(微型虚拟机)技术与普通容器有本质区别。普通 Docker 容器共享宿主机内核,一旦容器逃逸漏洞被利用,攻击者可能获得宿主机权限;而 microVM(如 Firecracker,由 AWS 开源)为每个实例运行一个独立的轻量级 Linux 内核,硬件级别的隔离使容器逃逸几乎不可能波及外部。这正是让 AI 代理运行未经审查代码的前提——即便代理写出恶意脚本或触发安全漏洞,损害也严格被限制在那一个 microVM 内部,用完即销毁不留痕迹。相比在本地开一个 Node.js 子进程执行 AI 生成代码,或者用共享内核的普通容器,这种隔离级别带来的安全边界差异是数量级的。
三个AI代理:角色相同,指令不同
项目里有三种角色,它们都调用同一个底层模型(OpenAI的Codex),唯一的区别是喂给它们的提示词(prompt)。
购物者:扮演真实用户
三位购物者各有简单的目标:budget-student是预算约20美元、想给开发者朋友买礼物的学生;hoodie-hunter是忙碌的工程师,要找所有L码卫衣里最便宜的;sticker-collector是贴纸爱好者,想看遍所有贴纸并比价。
购物者被明确告知「你是真人而不是开发者,不要编辑任何文件」。它通过 curl 查看页面,想象真实用户需要的点击和滚动。关键在于,它必须以JSON而非自然段落回答,这样程序才能轻松解析。返回的报告包含 score(1到10分,10分表示任务极其轻松)、friction(遇到的摩擦点)和一句用户视角的 quote。
分析师:提炼可执行的修复
分析师阅读所有购物者报告后提出若干修复方案,并被约束了严格规则:每个修复必须小而精、只能改动 index.html、app.js 和 styles.css、不引入新库、不改后端,且每个方案应是不同思路。它同样以JSON格式输出每个variant的标题、假设和规格说明。
构建者:真正动手写代码
构建者拿到一个具体修复(比如「按价格排序」)后编写代码,规则包括:只编辑那三个文件、纯HTML/CSS/JS不用框架、不重启服务器、完成后用 curl 验证页面仍能加载。这些约束确保每个版本都公平——同一个商店加一个小改动而已。
这种「同一模型、不同提示词」的多代理设计模式通常被称为「角色提示」(Role Prompting)或「代理分工」,是当前多代理系统的常见范式。其核心思想是:大语言模型具备通才能力,通过精心设计的系统提示(System Prompt)可以约束其行为边界,使同一个模型分别扮演批评者、实施者、评审者等不同角色。这种方式的优势在于避免了维护多个专用模型的成本,同时通过角色约束(如「你是真人不是开发者」「不要编辑文件」)人工引入了认知偏差,防止代理越权或混淆职责。在本项目中,购物者的约束确保评分视角保持用户侧,而非开发者视角,这一点对测试结果的有效性至关重要。
核心SDK操作串联
整个项目对SDK的使用面相当克制,大约只有十个调用。登录通过 oauth()(首次会打印链接和验证码,之后凭证存入本地文件)或 pat()(设置 DOCKER_USERNAME 和 DOCKER_PAT 免浏览器)完成。OpenAI密钥通过 client.secrets.create 存入Docker,而非沙箱内部——需要注意的是,SDK不会自动为你附加密钥,必须在创建沙箱时手动传入。
创建并启动沙箱使用 client.kits.launchAndWait('codex', ...),'codex' 是一个预装了Codex的现成kit,launchAndWait 会一直等到沙箱就绪。随后用 sandbox.files.mkdir 和 files.write 把商店文件拷进去,用 sandbox.processes.start 在后台跑起Node服务器,再通过轮询(最多30次、每秒一次)确认服务器能响应,最后 sandbox.ports.create({ number: 3000 }) 把端口开放到公网,返回真实的HTTPS URL。
让Codex执行任务则统一走一个 runAgent 函数,它用 codex exec 一次性运行、--ephemeral 临时模式、-o 把最终答案写入文件。其中 --dangerously-bypass-approvals-and-sandbox 关闭了Codex自带的安全盒——这在已经处于一次性沙箱内的前提下是可接受的。由于AI回答常被代码块或多余句子包裹,extractJson 辅助函数会找出第一个 { 和最后一个 } 之间的内容,简单却有效。
--dangerously-bypass-approvals-and-sandbox 这个参数值得单独解释。Codex CLI 默认运行在一个审批模式下,每次代理想执行写文件、运行命令等操作时都会暂停并等待人工确认,以防止 AI 误操作。这个设计对交互式使用场景是合理的,但在全自动流水线中会阻断整个流程。本项目的解法是把这一安全层「外包」给 Docker Sandbox——既然整个执行环境本身已经是一次性隔离的 microVM,Codex 内置的审批机制就成了多余的冗余而非必要保护。这体现了一个重要的安全工程思路:安全机制应当按层次叠加,当外层已提供足够保护时,内层的同类机制可以按需关闭以换取自动化效率。
主流程与赢家判定
主程序 ab.ts 按顺序串联上述helper。先启动原始商店作为基线A,用 simulate 配合 Promise.all 让三位购物者并发体验并返回JSON报告;接着让分析师给出修复方案;然后对每个方案调用 runVariant——它会开新沙箱、让构建者加修复、再派同样三位购物者测试。
这里有个值得学习的工程细节:批量执行用的是 Promise.allSettled 而非 Promise.all。区别在于,若某个修复失败,其他版本仍能跑完,一个坏版本不会毁掉整轮运行。
赢家判定逻辑清晰:先按平均分从高到低排序,平均分相同则看完成率,仍打平则比谁步骤更少。选出赢家后,程序把其文件从沙箱读回本地的 results/winner/,并生成 report.md 和 report.json 记录所有分数与用户原话。一条 diff -u app/app.js results/winner/app.js 就相当于你的pull request。
运行、观察与清理
配置好 .env 中的 OPENAI_API_KEY 后,npm start 即可启动。一轮典型运行(2个修复、3位购物者)会用到3个小沙箱、约12次Codex调用,耗时约5到10分钟。还支持 --variants、--personas、--goal、--cleanup、--no-dashboard 等参数灵活调整。
运行期间访问 http://localhost:4000 可看到实时仪表盘,A/B/C三个方框随进度点亮并实时显示分数。终端还会为每个版本打印公网链接,你能在三个标签页里同时观察B和C在构建者工作时的变化。一个示例结果中,基线A易用性4.0分、完成率67%、14步;而赢家B(搜索与筛选)达到8.3分、100%完成、仅4步,提升高达108%。用完 npm run cleanup 即可删除所有以 ab- 开头的沙箱。
局限与更大的启示
作者也坦诚了几点局限:购物者是用 curl 而非真实浏览器读页面,能判断搜索或筛选是否缺失,却无法评价页面的视觉观感;分数来自极少数购物者的AI判断,只能当作线索而非硬证据;此外Sandboxes SDK仍处实验阶段(项目基于0.53.0版本),部分命名未来可能变化。
但这个商店只是一个示例。同样的模式适用于测试提示词、调优参数、尝试不同文案——任何「你能扮演用户并给出评分」的场景都能套用这个循环。真正的核心洞见在于:当一台安全、用完即弃的计算机只需一次函数调用就能唤起时,让代理「试一试看结果」就不再是一件有风险的事。这或许正是自主代理工程落地的一个务实方向。
相关推荐

美国大学兄弟会该不该被禁?一位研究者的犀利观察
为什么不直接禁止美国大学兄弟会?一位研究者发现,关键阻力来自决策者自身的兄弟会身份认同,以及学校对兄弟会活动的"故意视而不见"。本文梳理禁令争议背后的结构性困境。

微软Discovery:用AI智能体加速科研发现
微软Discovery平台通过运行专用AI智能体,帮助科研人员从大量化合物和实验路径中筛选最有前景的候选方案并进行优先级排序,从而减少实验次数、加速科研发现。

剑桥重工秘密研发桌面级核聚变装置
Cambridge Heavy Industries正在秘密研发桌面级激光驱动核聚变装置,瞄准聚变发电厂的设备供应市场。本文分析其小型化技术路线、商业化逻辑及在聚变创业潮中的独特定位。