用Go从零构建AI Agent:架构、Agentic Loop与工具调用
用Go从零构建AI Agent Omega第一讲:架构决策、领域建模与Agentic Loop核心逻辑。
本文梳理了用Go从零构建AI Agent项目Omega第一讲的核心内容。文章指出LLM只是生成token的「大脑」,必须叠加工具层与自动化编排才能成为Agent,其精髓在于Agentic Loop。架构上强调「接口优先+适配器模式」,让Provider保持无状态、业务逻辑不依赖任何第三方API格式,从而做到可扩展、领域隔离。文章还速览了支撑循环的Go核心概念:struct/interface、goroutine/channel、context取消机制。随后用系统设计风格定义Omega的领域实体:Role、Message、ContentBlock、Completion Request/Response、Tool Definition、Usage、Budget与Agent Event。最后详解Agentic Loop七步流程,并说明其设计哲学。
用Go从零构建AI Agent:架构、Agentic Loop与工具调用
大模型本身只是一个「大脑」,它能理解语言、生成文本,却无法主动读取文件、执行命令或访问网络。真正让LLM具备行动能力的,是在其之上叠加的一层自动化编排——这就是AI Agent。一位YouTube技术创作者正在用Go语言从零构建这样一个Agent项目,代号Omega,并以系列课程的方式公开整个设计过程。本文梳理第一讲的核心内容:架构决策、领域实体建模,以及最关键的Agentic Loop设计。
LLM与Agent的本质区别
LLM是token生成模型,Claude Opus、Sonnet、GPT系列都属此类。它们能理解英语、印地语等自然语言,但仅此而已。当你让LLM读取一个文件,它自己做不到——它只能输出一段文字说「我想用file_read工具,参数是command/agent/main.go」。
把LLM的这类「意图」接到实际操作上,需要工具层。file_read负责读文件,list_directory负责列目录,run_shell负责执行命令,browser_use负责联网检索,MCP(Model Context Protocol)则用于连接外部服务。当这些工具被集成到LLM之上,形成自动化执行链路,产物就是Agent——它能读文件、跑命令、调API,表现得像拥有自主意识一样。
MCP(Model Context Protocol) 是Anthropic于2024年底开源的一项标准协议,用于让LLM应用以统一方式连接外部数据源与工具服务。在MCP出现之前,每个Agent项目都要为GitHub、数据库、文件系统等每个外部服务单独编写集成代码,格式各异、难以复用。MCP将这些集成抽象为「Server」——每个Server以声明式方式暴露自己的工具、资源和prompt模板,而Agent作为「Client」通过标准JSON-RPC协议与之通信。这意味着一个为Claude桌面端写好的MCP Server,可以被任何支持MCP的Agent直接复用。在Omega这类自建Agent中,MCP相当于把工具层的扩展从「硬编码」升级为「插件化」:无需改动核心循环,只要挂载新的MCP Server,Agent就自动获得了新能力。这也是「未来要加的东西必须能轻松加进来」这一设计原则在工具层面的具体落地。
核心设计原则:可扩展、领域隔离
这位创作者反复强调一个工程原则:未来要加的东西,必须能轻松加进来。今天接Anthropic的API,明天想换OpenAI或OpenRouter,不应该重写业务逻辑。
实现路径依赖两个设计模式:
接口优先(Interface First)。定义统一的LLM接口,Anthropic Provider实现它,OpenAI Provider也实现它。业务层永远只调接口,不关心底层是谁。
适配器模式(Adapter Pattern)。第三方API的请求/响应格式各不相同,适配器负责把中立的领域请求翻译成各家API的线格式(wire format),再把响应翻译回来。Provider是无状态的——它不知道当前是第10次还是第11次请求,不关心token预算是否快超了,只管「给我请求,还你响应」。
这个设计的价值在于:CLI、移动端App、桌面端都只是同一个事件流的不同消费者。今天用终端,明天想接Web端,基础设施不用动。
Go语言核心概念速览
课程用大量篇幅铺垫Go的基础概念,因为后面的Agentic Loop完全建立在它们之上。
Struct与Interface
Go没有类,只有struct和interface。Struct是持有数据变量的结构体,字段首字母大写表示公开(public),小写表示包内私有。Interface只定义方法签名,任何实现了这些方法的struct就自动满足该接口。Provider被定义为interface,包含complete和stream两个方法。
Goroutine与Channel
Goroutine是Go运行时管理的轻量级线程,运行在用户空间。Channel是goroutine之间通信的管道——本质是堆上的一块共享内存,且线程安全,读写不会导致数据竞争。Agent的事件流(文本增量、工具调用、工具结果、错误)正是通过channel从后台goroutine送回主程序。
Context与取消
Context是Go中传递取消信号的数据结构。主线程创建cancelContext并传给Agent的所有运行时。用户按下Ctrl+C,终端捕获信号,触发context取消,Agent Session以及其中所有打开的文件句柄、网络连接都会被干净地关闭。Context不能在原地被替换,派生新context必须创建子context。
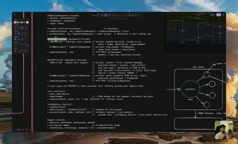
理解Context的关键在于它是一棵不可变的树,而非一个可变的全局状态。context.Background()是根,每一次WithCancel、WithTimeout、WithValue都派生出一个子节点,持有父节点的引用。当父节点被取消时,其所有子孙节点会级联收到取消信号;反之,取消一个子节点不会影响父节点或兄弟节点。这种单向传播机制正是Agent场景所需要的——当用户按下Ctrl+C,最顶层的Session context被取消,那么从它派生出的每一轮LLM HTTP请求、每一次工具调用、每一个打开的数据库连接,都能在各自的goroutine里通过监听ctx.Done()通道而立即退出。Context通常作为函数的第一个参数传递,且约定不要存入struct字段,因为它的生命周期应当严格跟随一次请求。在Agentic Loop中,每轮迭代往往从Session context派生出带超时的子context,用于约束单次工具调用的最大耗时——这正是Budget中max seconds的实现方式。
领域实体建模
创作者用类似Hello Interview的系统设计风格,先列需求、再定实体,最后画时序图。所有实体都是Omega的领域语言,与Anthropic、OpenAI无关。
Role:标识消息来源,user或assistant。
Message:由role和一个content block数组组成。用户消息和助手回复都是Message,只是role不同。
Content Block:可以是text(纯文本)、tool_use(工具调用请求)或tool_result(工具执行结果)。tool_use包含id、name和input(动态JSON);tool_result复用同一个id以便追踪。
Completion Request / Response:这是Omega的「中立请求」和「中立响应」。Request包含system prompt、消息历史数组和工具定义;Response是单个content block,不追加历史。
Tool Definition:每个工具有name、description和input_schema(结构化JSON),确保调用是确定性的。
Usage:记录input tokens、output tokens、cache read tokens。缓存读取之所以单独计量,是因为transformer的KV向量在相同前缀下可被缓存,价格更低。
Budget:限制max turns(如100轮)、max tokens(如500万)、max seconds(单次工具调用如60秒),并通过check函数在每个回合检查是否超限。
Agent Event:事件类型包括text_delta(逐token流式文本)、tool_call、tool_result、turn_end(回合结束)、error,通过channel传递给消费端。
KV缓存(Key-Value Cache) 是理解Usage中cache read tokens为何单独计价的关键。Transformer在生成每个token时,需要对此前所有token计算注意力,其中的Key和Value向量一旦算过,只要前缀不变就无需重算。Anthropic等厂商会把这部分向量缓存在服务端,后续请求若命中相同前缀,就跳过重算,直接复用。这对Agent至关重要:Agentic Loop每一轮都会把不断增长的消息历史重新发送,前缀高度重叠,缓存命中率极高。缓存写入通常比普通输入token贵约25%,但缓存读取便宜约90%,因此长对话中缓存能显著降低成本与延迟。这也解释了为什么在领域建模时,usage被拆成input、output、cache_read三类而非笼统的token总数——只有分开计量,才能真实反映成本,并为Compaction(上下文压缩)等后续优化提供数据依据。
Agentic Loop的核心逻辑
这是整个课程最重要的部分。Agent Session被创建后,run方法启动循环:
- 检查预算。每轮开始先验证turns、tokens、时间是否超限。
- 发起LLM调用。携带cancelContext、system prompt、消息历史、可用工具,调用provider的complete方法。
- 转换响应。Provider把Anthropic响应转成Omega统一的Completion Response。
- 追加消息。把助手回复追加到消息数组,形成不断增长的上下文。
- 判断stop reason。如果是end_turn,发出run_end事件,关闭channel,循环结束。如果是max_tokens,发出error,退出。如果是tool_use,进入下一步。
- 执行工具。遍历每个tool_use块,发出tool_call事件,通过tool registry调用对应工具,拿到结果后发出tool_result事件,并把tool_result追加为一条新消息。
- 回到第1步,继续循环。
这个循环的精髓在于:Agent拥有循环的控制权。它决定何时等待工具返回、何时继续下一轮、何时结束。Provider和工具都是无状态的服务提供者,状态全部集中在Agent Session里。
为什么这样设计
创作者提到自己被面试时的经验:LLD没有标准答案,但你的设计必须回答两个问题。其一,是否可扩展——未来加一个新provider或新工具,是否能不改动核心逻辑。其二,领域边界是否清晰——你的server是否只讲自己的领域语言,第三方格式被隔离在适配器内部。
「Omega是黑盒,LLM也是黑盒。我为Omega设计,由Omega实现。」这句话概括了整套架构哲学:用户发请求、收响应,不关心底层是Anthropic还是OpenAI;业务逻辑不关心技术细节,只依赖接口契约。
后续课程将进入流式响应(SSE、逐token推送)、MCP集成、Compaction(上下文压缩)以及多用户场景下的流隔离等话题。第一讲的价值不在于写了几行代码,而在于把地基打牢——如果不理解Agentic Loop和领域建模,后面的生产级问题根本无从下手。
适配器模式(Adapter Pattern)是GoF二十三种经典设计模式之一,其核心意图是「将一个类的接口转换成客户期望的另一个接口,使原本因接口不兼容而无法协作的类能够一起工作」。在Omega中,它体现为两层翻译:请求方向,把Omega中立领域模型(Completion Request)转换成Anthropic或OpenAI的线格式;响应方向,把厂商返回的原始JSON再翻译回Omega的Completion Response。Adapter通常是无状态、可互换的纯函数式组件,这与前面强调的「Provider无状态」正好呼应。与之互补的是接口优先原则:先定义消费者真正需要的抽象,让实现去适配抽象,而不是让抽象迁就某个具体厂商。二者结合带来的收益是依赖倒置——高层业务逻辑依赖稳定接口,底层实现可随时替换,因此切换API供应商、接入自研模型或添加Mock用于测试,都无需触碰Agentic Loop本身。
相关推荐

3分钟看懂DeepSeek:从量化私募到开源AI领跑者的崛起之路
3分钟看懂DeepSeek发展史:从幻方量化的算力积累,到V2的MLA推理降本、V3的557.6万美元训练账单、R1开源引爆全球,再到V4与70亿美元A轮融资,梳理深度求索的关键节点与技术路线。

本地文学创作模型PK:Qwen3.8 27B微调版胜出,DeepSeek v4.1表现平淡
B站UP主横向测评七款本地文学创作模型:海明威、HumanLike Chat基于Qwen3.8 27B微调表现最佳,DeepSeek v4.1叙事平淡,东方朔角色混乱垫底。附三道测试题评分与使用建议。

梁文锋的三次豪赌:DeepSeek为何将82%毛利开源?
DeepSeek为何把82%毛利的推理框架DeepInfer开源,又启动千亿融资?从技术路线、国产芯片到组织纯粹性,解析梁文锋的三次豪赌与开源战略背后的商业与理想逻辑。