用GPT-6生成可编辑论文框架图:10分钟搞定手绘两天的活
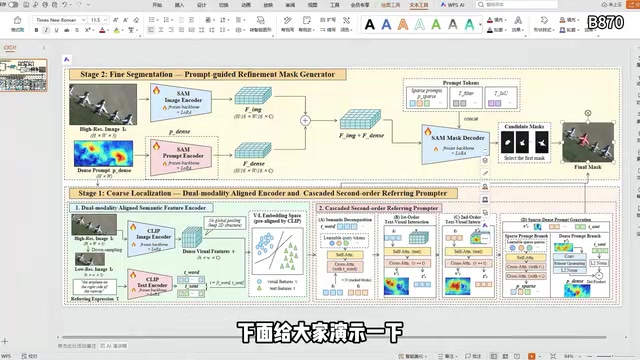
用GPT-6 Astra两步工作流,将论文框架图直接生成为可编辑PPTX文件,省去手动排版的繁琐。
本文介绍了一套借助GPT-6 Astra大幅提升科研配图效率的两步工作流。第一步在ChatGPT网页版调用「架构图Skill」,输入风格参考图和架构描述,生成初版框架图(静态图片);第二步追加关键提示词,要求模型「不用任何Skill、照着图在PPT里重画」,让模型以编程方式输出真实的PPTX文件。整个过程约15分钟,最终产出的文字、箭头、色块均可在PowerPoint中自由修改。相比手动排版动辄耗费一两天,这套流程将AI的视觉理解能力与文档生成能力串联起来,让AI扮演「搭好可编辑骨架」的协作者,而非输出一张改不动的图片的黑箱。
科研工作者对配图的痛苦深有体会——一张结构清晰的论文框架图,手动在PPT里对齐箭头、调整文字框、配色排版,往往要耗上一两天。而借助最新的GPT-6 Astra,这个过程被压缩到了十分钟量级,且产出的还是可编辑的PPTX文件,而非一张无法二次修改的图片。这篇文章拆解这套工作流的具体做法。
从「生成图片」到「可编辑文件」的关键跳跃
以往用AI生成科研图有个致命短板:模型吐出来的是一张静态图片,文字、箭头、色块全都焊死在像素里,想改一个标签都得重画。这次演示的核心突破,正是解决了这个问题。
整个流程分两步走。第一步是在网页版ChatGPT上调用「架构图Skill」,喂给它一张风格参考图,再补上自己的架构文字描述,模型就会按要求先生成一张框架图。
但这张图此刻仍然是不可编辑的图片格式,只能看不能改。
让GPT在PPT里「重画一遍」
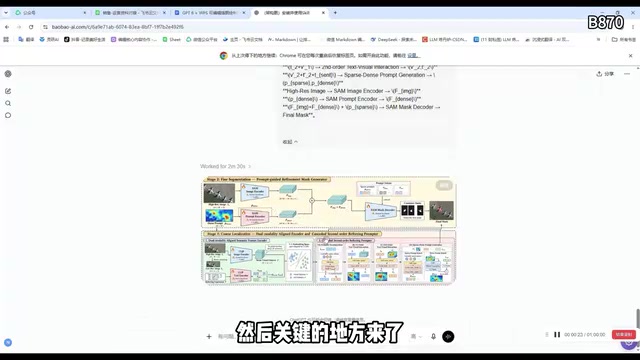
真正的技巧在第二步:不满足于一张图片,而是让GPT把这张图在PowerPoint里重新绘制一遍,直接输出成PPTX文件。
提示词的关键点是明确要求模型**「不要使用任何Skill,直接照着这张图在PPT里画」**。这句指令很重要——绕开Skill的图片生成能力,转而调用模型对办公文档结构的理解,让它用真实的PPT元素(文本框、形状、连接线)去还原画面。
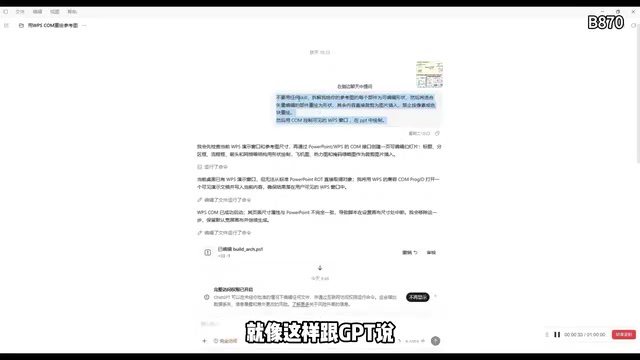
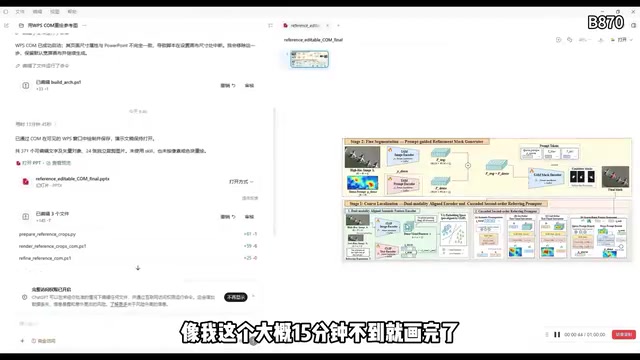
作者实测整个绘制过程大约15分钟不到就完成了,速度相当可观。更重要的是最终的还原度很高,视觉效果几乎与原图一致。
这里有必要解释一下「Skill」在GPT-6 Astra中的含义。Skill是ChatGPT平台内置或扩展的专项能力模块,类似插件,架构图Skill专门负责调用图像生成管线来输出一张渲染好的图片。而当你明确要求「不用任何Skill」时,模型会退回到纯文本与代码推理路径,转而用Python的python-pptx库(或类似的文档生成库)编写代码,以编程方式创建真实的PPT元素——包括Shape(形状)、TextBox(文本框)、Connector(连接线)等对象,最终输出结构化的PPTX文件。这两条路径的本质区别在于:前者生成的是位图像素,后者生成的是可被PowerPoint解析的XML结构,因此才具备后续可编辑的能力。
为什么这套流程对科研党有价值
生成出来的PPT文件里,文字、框、箭头这些元素全都可以单独修改,配色、位置、措辞都能随手调整。对写论文的人来说,这意味着可以拿AI给的框架当作起点,再快速套用到自己的具体研究内容上,省去从零对齐排版的繁琐劳动。
换句话说,AI在这里扮演的不是「一键出图」的黑箱,而是「先给你搭好骨架,剩下的你自己精修」的协作者。这种「可编辑产物」的定位,比单纯生成一张漂亮但改不动的图片,实用性要高出许多。
在学术论文(尤其是计算机、生物信息、系统科学等领域)中,框架图(Architecture Diagram / Framework Figure)通常出现在摘要之后或方法章节开头,承担「一图胜千言」的作用,帮助审稿人在细读正文前快速理解研究的整体逻辑和模块关系。正因如此,这类图对视觉精度和可修改性要求都很高——投稿修改时往往需要根据审稿意见反复调整标签措辞、模块划分或颜色语义。以往科研人员常用的工具有Visio、Lucidchart、draw.io或直接在PowerPoint手动拼接,耗时且对齐繁琐。AI生成可编辑PPTX的意义,正是将「从零搭建」这一最费时的环节自动化,让研究者的精力集中在内容准确性的精修上,而非排版本身。
操作要点小结
梳理一下这套方法的核心步骤:
- 在网页版ChatGPT调用「架构图Skill」,提供风格参考图 + 架构文字描述
- 让模型先生成初版框架图(此时仍是不可编辑图片)
- 追加指令:明确要求「不用任何Skill,照着图在PPT里重画」
- 等待约15分钟,获得可编辑的PPTX文件
- 在PPT中自由修改文字、箭头、色块,适配自己的论文
需要说明的是,本文内容基于B站UP主的单一演示来源,实际效果可能因参考图复杂度、架构描述清晰度而有所差异。对于结构特别复杂的框架图,还原度和耗时也可能不同,建议感兴趣的同学按提示词自行验证。
写在最后
AI辅助科研作图正在从「玩具」走向「工具」。当模型不仅能生成图像,还能理解并操作办公文档的底层结构时,它才真正嵌入了研究者的实际工作流。这套「生成图片→PPT重绘→可编辑输出」的思路,把AI的视觉能力和文档处理能力串了起来,值得一试。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。