Fable AI编程实战:推理档位优化与多模型协同省钱指南

本文基于知名科技UP主Theo(T3)的YouTube实战视频整理,聚焦他围绕Anthropic新模型「Fable」建立的完整AI编程工作流。
一位资深开发者用一句话概括了他对新模型的震撼:「说Fable一击命中了我,都算是严重的低估。」在重新拿回这个模型的第一天,他完成的工作量超过了此前整整一个月。这背后不是简单的「模型更聪明了」,而是一整套工作方式的重构。
Fable不是「更好的Opus」:认清这个最大误区
很多人误以为Fable只是Anthropic Opus系列的升级版,于是把过去为Opus写的提示词原封不动搬过来,结果自然大失所望。Theo反复强调:这是理解这个模型最致命的误区。
要理解为什么旧提示词无法迁移,需要先了解Anthropic的技术演进脉络。Anthropic是由前OpenAI研究副总裁Dario Amodei和Daniela Amodei兄妹于2021年创立的AI安全公司,其Claude系列模型以「Constitutional AI」(宪法式AI)训练方法著称——通过让模型依据一套价值原则进行自我批评与修正,提升输出的安全性和可靠性,这与OpenAI的RLHF(人类反馈强化学习)路线形成了显著的方法论差异。Constitutional AI的核心创新在于引入了「AI反馈(AI Feedback,AIF)」环节:模型不仅接受人类标注者的偏好信号,还会在监督下对自己的输出进行基于原则的批判与修正,形成一个自我精炼的闭环。这种方法论上的差异不只影响模型的安全性表现,更深刻塑造了模型理解任务、分解目标、以及在多步骤执行中进行自我校正的底层机制——这正是为什么针对其他模型设计的提示词策略,在Claude系列上往往需要重新校准的深层原因。
Claude的命名体系经历了多次演变:早期的Claude 1、2,到后来形成的Haiku(轻量快速)、Sonnet(均衡)、Opus(顶级智能)三档产品矩阵,覆盖从边缘计算到复杂推理的全场景需求。而「Fable」的出现,代表的不是Opus的线性迭代,而是模型架构和任务执行机制的根本性重构——其推理结构、上下文利用方式和多步骤规划能力均有本质变化,这才是旧提示词策略完全失效的深层原因,而非仅仅是「参数更多了」。
Fable真正的差异不在于「代码写得更好」,而在于它能「走得更远」——不仅能处理更难的代码任务,更能完成端到端的实现、测试、验证等完整软件开发链路。尤其当任务需要拆解成小块、再分发给子代理(sub-agents)执行时,Fable展现出了此前模型无法企及的能力。
换句话说,Fable标志着一种范式转变:模型从「代码补全助手」进化为「能够自主编排复杂工程流程的执行者」。如果你还用旧思路驾驭它,就享受不到这种红利。
AI编程成本优化第一课:别开最高推理档位
Theo坦言,前三天放开手脚使用Fable,按实际用量折算下来花费高达数千美元。而当他优化工作流后,同样的工作量——包括五个半小时循环运行、修复合并十几个PR——总成本只有约150美元。
最关键、也最出人意料的省钱建议是:推理档位不要超过「high」。
X、high、max这几个看起来诱人的高档位,就像「求你再投一枚硬币的老虎机」。它们会让模型陷入过度推理的循环:反复自我怀疑、越想越久,最终产出的往往是「改动过多、过度设计」的糟糕代码,成本却高得离谱。
推理档位的真相:影响深度,不影响步数
推理档位本质上是对模型「思维链(Chain-of-Thought,CoT)」token数量的预算控制。CoT技术最早由Google Brain团队于2022年系统性提出,其核心发现是:让模型在给出最终答案前先生成中间推理步骤,可以显著提升复杂任务的准确率。这一机制的有效性根植于Transformer架构的序列生成本质——模型通过逐token预测工作,每个新生成的token都能成为后续推理的「锚点」,中间步骤的显式化实质上是在利用模型自身的输出空间扩展有效上下文。然而,这也意味着推理token与输出token一样消耗计算资源和费用配额。在支持扩展推理的模型(如Anthropic的Claude Thinking模式、OpenAI的o系列)中,模型会在正式回答前生成大量内部「草稿」token——这些token对用户不可见,但会被计入计费,且消耗往往远超最终输出本身。档位越高,允许模型消耗的内部推理token上限越大,意味着每次工具调用的实际费用可能呈指数级增长。
问题在于,对于大多数日常编程任务,过长的推理链会导致认知科学中所说的「分析瘫痪」(analysis paralysis):模型反复权衡边缘情况,在多条等价路径间无法决断,最终生成过度防御性的复杂代码,反而偏离了简洁有效的解法。这与人类专家的决策模式高度吻合——真正的高手往往依靠模式识别快速给出简单直接的方案,而非调用大量认知资源进行穷举推理。研究表明,噪音干扰下的过度思考(overthinking)不仅不能提升决策质量,反而会系统性地降低它。
很多人误以为max能解决更难的问题、让模型工作更久,但实际上:推理档位只影响单次工具调用的思考深度,不决定模型能执行多少步骤。一个需要500步的任务,max不会多做任何步骤,只会在每一步想得更多——而大多数步骤根本不需要那么深的思考。
更有说服力的是:所谓「ultra code」模式,底层其实就是用high档位并发拉起更多实例。「连Anthropic自己都认为high才是性价比之王,它是默认值是有原因的。」建议老老实实用low到high,固定在high不再纠结。仅这一个改动,就能把账单砍掉一半以上。
让Claude调用Codex:多模型协同降低Token消耗
第二个核心技巧,是教会Claude Code去调用OpenAI的Codex(GPT-5.5)。这看似矛盾——既然Fable这么强,为什么还要用别的模型?答案在于成本与专长的合理分工。
将不同AI模型用于不同任务类型——即「模型路由(Model Routing)」——已成为AI成本工程(AI Cost Engineering)的核心实践。这一领域借鉴了云计算中「右型选择(Right-sizing)」的思想:不同工作负载应匹配不同规格的计算资源,而非一律使用最高配置。AWS、GCP等云厂商多年来积累的FinOps(云财务运营)方法论,如今正被系统性地移植到AI推理层:成本可见性、用量分级、按需伸缩、持续优化,这些原则在AI编程场景中同样适用。值得注意的是,模型路由的工程挑战不只在于「选哪个模型」,更在于如何在运行时动态判断任务的智能密度需求。这催生了一类新兴的「路由层」工具(如LiteLLM、OpenRouter),它们在调用方与模型提供商之间建立了一个可编程的智能分发层,允许开发者用统一API实现跨模型的成本感知路由——这与Theo在Claude.md中手工定义路由规则的思路互为补充,前者适合高频标准化场景,后者适合需要深度项目上下文的复杂任务。
在具体的任务分级上,可以按「智能密度」粗略划分:简单的日志解析、文档阅读等任务对深度推理要求低但token消耗大,适合用价格低廉或配额充裕的模型处理;需要深度代码理解、跨文件架构判断和边界条件推理的任务,才值得调用顶级模型。这种分级思维的极端形式是「Mixture of Experts(专家混合)」架构——在模型内部根据输入特征动态路由到不同专家网络,而模型路由将这一思想扩展到了系统架构层面。OpenAI的Codex配合其订阅制的周期额度,天然适合作为「重活苦活」的承担者,与Fable形成互补的成本结构。这种混合模型架构预计将成为未来AI工程的标准范式。
Codex订阅的额度「慷慨得离谱」,重度使用一整周也只消耗了约15%的周限额。因此,那些消耗大量token但不需要顶级智能的任务,应该交给Codex处理,比如:
- 翻查海量日志
- 阅读巨型PDF和实现规格文档
- 计算机操作(computer use)——OpenAI在这方面表现明显更强
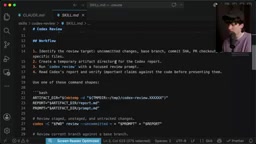
Codex桌面应用能真正操控整台Mac:配置Xcode、在复杂应用间导航拉取数据、完成后录一段视频发给你。只需花约一小时,在全局Claude.md里教会Fable识别哪些任务该「shell out」给GPT-5.5。
用「术语表」对齐多模型的判断标准
在配置文件中,可以从智能(intelligence)、品味(taste)、**成本(cost)**三个维度为不同模型建立评分体系。比如GPT-5.5智能高、成本低,但「品味」不足——「它写TypeScript像个Python开发者,写Rust像个极度偏执的C++开发者」,产出风格未必符合预期。而Fable在智能和品味上都是同类最佳,只是成本较高。
关键实践:在你的Claude.md里定义一个「术语表」,写清楚你用「intelligence」「taste」这些词具体指代什么。
Claude.md是Claude Code工具链中用于持久化项目上下文的核心配置文件,其设计理念来自「系统提示词(System Prompt)」的工程化实践。与一次性的对话提示不同,Claude.md在每次会话启动时自动注入,确保模型始终持有项目的技术栈偏好、代码风格规范、架构约束、团队术语表等关键信息。这从根本上解决了大语言模型的一个固有局限:无状态性(statelessness)——Transformer架构的模型本身不具备跨会话记忆能力,每次对话都从零开始,必须通过外部文件显式传递上下文。Claude.md的出现,本质上是将「提示词工程」从艺术升级为工程规范:它有版本控制、可以团队共享、随代码库一起演进,而非散落在每个开发者的对话历史中。在多模型协同场景中,Claude.md还承担着「元编排」职责:告知主模型何时应将任务委派给其他模型,以及如何评判不同模型的适用边界。更进一步,Claude.md中的术语表解决了一个微妙但关键的问题——「语义漂移」:当你对不同模型说「帮我审查代码质量」时,各模型基于训练数据形成的「质量」概念可能大相径庭。显式定义术语,等于为整个多模型系统建立了一套共同语言,确保每个执行者对任务目标的理解对齐。这使得配置文件从简单的提示词模板升级为整个AI工作流的「宪法文件」,其重要性不亚于代码本身。
这既帮助模型理解任务描述,也让它在自主选择调用哪个模型时能做出符合你意图的判断。
Sub-agents与Workflows:Fable的真正杀手锏
理解这两个概念的区别,是掌握Fable高级用法的关键:
- Sub-agents(子代理):主代理调用工具生成另一个代理去执行任务,适合并行分析多个文件。
- Workflows(工作流):以编程方式定义子代理的多阶段协作——比如第一阶段遍历所有文件,第二阶段对被标记的项目再派两个审查员处理。它本质上是模型自己生成的一个JavaScript编排文件,用来动态管理长时间任务。
多智能体(Multi-agent)架构的思想根源可以追溯到1986年Marvin Minsky在《心智的社会》(The Society of Mind)中提出的核心命题:复杂智能涌现自大量简单个体的协作,而非来自单一全能实体。这一思路与软件工程中的「分治(Divide and Conquer)」原则高度吻合,并在近年来随着大模型能力的提升获得了前所未有的工程可行性。值得注意的是,早期的多智能体系统(如1990年代的AutoGen前身研究)受限于通信开销和单体模型能力瓶颈,协作收益往往被协调成本所抵消。大模型时代的突破在于:每个子代理本身就具备足够强的语言理解与生成能力,使得代理间的自然语言协议成为可行的接口标准,从而大幅降低了多智能体系统的设计复杂度。在实践层面,子代理架构能同时解决三个关键瓶颈:首先是突破单一上下文窗口的长度限制——即使是百万token的上下文也有物理边界,将任务拆分给多个代理可以绕过这一限制;其次是实现真正的并行处理,将串行的工作流压缩为并发执行,大幅缩短端到端时间;第三是允许不同代理调用不同模型,在整体架构中实现精细化的成本优化。Fable在这一领域的真正突破在于:模型本身能够根据当前任务的特性动态设计子代理的角色原型与协作协议,而非依赖开发者预先硬编码每种代理类型。这意味着编排智能从「工具层」提升到了「模型层」,开发者从定义「怎么分工」转变为描述「要达成什么目标」。

最令人惊叹的突破是:过去开发者要在工具里手动定义各种「审查子代理」「对抗性审查子代理」「探索性子代理」的原型,既繁琐又僵化。而Fable现在能根据具体任务需求,自行发明这些代理原型。「每次我要模型审查东西,需求都略有不同,而模型现在足够聪明,能自己定义。」
实战案例:用Fable清理16个僵尸PR
Theo用他的项目Lakebed做了完整演示。失去Fable期间,他积累了16个「半成品」PR——完成度50%到80%,但SDK改动不满意、实现没把握,清理起来又费劲,整个项目停滞了整整一个月。
Pull Request(PR)是现代软件协作开发的基础单元,起源于Linus Torvalds为管理Linux内核贡献而设计的补丁邮件工作流,GitHub于2008年将其图形化并推广为行业标准流程。健康的PR工作流通常包括:功能分支开发(feature branch)、自动化CI/CD流水线触发、静态代码分析、人工Code Review、以及最终合并到主干(main/master)并触发部署流水线等环节。「僵尸PR」现象的成因往往不是单纯的技术问题,而是反映了工程团队的认知负担与决策摩擦:当开发者需要同时在脑中维护多个半完成分支的状态、依赖关系和潜在冲突时,切换成本会随积压数量非线性增长——这正是「在制品(Work In Progress,WIP)限制」成为看板方法核心实践的根本原因。AI代理在清理僵尸PR上的独特价值,恰在于它能无状态、无切换成本地同时审视所有悬挂分支,用并行分析替代人类的串行认知负担。「staging环境」是生产前的最后一道验证屏障,与生产环境架构相同但流量完全隔离,允许在真实基础设施上验证变更而不影响真实用户。AI代理被严格限制在staging边界内操作,体现了信息安全领域「最小权限原则(Principle of Least Privilege)」在AI系统设计中的创造性应用:即使代理行为出现意外偏差,其影响范围也被硬性限定在可恢复的沙箱内,从而在「自主性」与「安全性」之间找到了可接受的工程平衡点。
他分几步推进,每一步的提示词都体现了「Fable时代」的新思路:
- 先审查分类:让Fable用workflow把16个PR分成「可直接合并」「需小修」「已被取代」「有好想法但该重写」四类。它派出48个代理(每PR一个调查员+压力测试),14/16达成一致意见。
- 清理与重新规划:关闭无用PR,为保留的功能写出新的HTML实现计划,并要求链接回启发它的原PR。
- 设定Goal自主执行:最后设置一个「goal」——让模型持续运行直到满足条件:创建工作树、rebase、合并、关闭PR,直到
todo.md里所有项目完成。
结果,模型连续运行了五个小时,每次刷新GitHub都有新代码落地。一个月的路线图就此完成,项目从落后一个月变成了领先一个月。
为什么敢让AI直接合并到main?
这听起来激进,但安全边界很清晰:生产部署始终有人类把关,AI只能触碰staging环境。合并到main只会触发staging部署,模型碰不到prod。加上配置了bug bot、Macroscope、CodeRab三个自动代码审查器把关,代码在合并前会经历大量反馈与简化。
事后他还专门花了比生成代码更多的token去验证成果——派其他代理测试新旧功能、检查prod与main的差异、补充测试用例。结论是「几乎没什么需要改的」。
用「任务耗时」判断代码库健康度
一个值得借鉴的思维框架:根据模型完成任务所需的时间和改动量,来评估代码库质量。
- 3分钟内搞定 → 简单修复,可放心提PR
- 15分钟 → 稍需关注
- 1小时以上 → 「架构可能有问题,需要深入排查」
比如一个「移动端滚动跳动」的修复耗时超过一个半小时,让Theo警觉不敢盲目合并;而另一个更烦人的「返回滑动」问题却在2分20秒内解决。任务耗时本身,就是暴露代码库薄弱环节的绝佳指标。
这一框架的深层逻辑在于:AI模型的推理时间与任务的「本质复杂度」高度相关。当一个看似简单的UI修复需要模型在代码库中大量跳转、反复尝试不同修复路径时,往往意味着底层抽象不清晰、关注点没有有效分离,或者存在深层的技术债。这与软件工程领域的「圈复杂度(Cyclomatic Complexity)」和「认知复杂度(Cognitive Complexity)」等静态分析指标所捕捉的信号高度吻合——圈复杂度衡量代码控制流图中独立路径的数量,认知复杂度则试图量化人类理解代码时的心理负担,两者都是SonarQube等代码质量平台的核心度量维度。但AI耗时提供了一种更直觉、更动态的测量方式——它不是分析代码结构的抽象度量,而是在真实任务压力下涌现出的系统性表现。尤其值得关注的是,静态复杂度指标只能捕捉局部代码单元的复杂性,而AI的耗时反映的是跨文件、跨模块的「系统性理解成本」,这是静态分析工具几乎无法测量的维度。换言之,AI的「困惑程度」是代码库健康度的一面镜子,它用计算时间量化了人类开发者用直觉感知但难以表达的「代码质量」,将过去只能主观判断的技术债问题转化为可观测、可对比的工程指标。
工具链与心态:驾驭AI编程的底层逻辑
辅助工具层面:用开源的T3 Code在手机、Mac Mini、Linux机器间灵活切换控制代理;通过tailscale实现远程连接;用vibe proxy在多账户间自动分流以规避额度限制。大量工作甚至可以在参加会议期间用手机完成。
但更重要的是心态转变:别害怕修改配置文件。Theo刻意不公开自己的skills和Claude.md原文,「我要你们从中学习,而不是复制粘贴后因为怕改坏而不敢动手」。真正的收益来自不断试验、调整,把它变成适合自己的系统。
这种「系统思维」的本质,是将AI工具的使用从「技巧积累」升级为「工程设计」:像设计软件架构一样设计你的AI工作流,明确每个组件的职责边界、数据流向和故障处理机制。当你的Claude.md开始像一份严肃的技术规范文档而非随手记录的提示词时,你就真正进入了AI编程的新范式。
总结:AI编程新范式的核心经验
Fable带来的不只是能力提升,而是工作方式的根本性重塑。核心经验可以浓缩为几点:
- 放弃「更好的Opus」的思维定式,用全新范式驾驭Fable
- 推理档位控制在high以内,砍掉超过一半的不必要成本
- 用Codex分担高消耗、低智能要求的任务,多模型协同提效
- 善用workflows让模型自主编排复杂流程
- 始终保持人类对生产环境的最终把关
正如Theo所说,这是一个「新时代」——开发者的角色正从「写代码」转向「设计系统、编排代理、做架构判断」。懂得如何驾驭这些模型的人,正在以前所未有的速度构建产品。
核心要点
相关推荐
B站最细Codex保姆级攻略:从安装到实战全解析
B站最细Codex保姆级攻略:从应用商店安装到日常工作模式配置,用真实咖啡馆项目演示文件整理、数据提取、仪表盘制作等实战任务,教你用计划模式和桌面宠物高效使用Codex。

体渲染中的外观补偿:为何RGB准确无法保证密度正确
体渲染研究揭示:完美复现外部RGB视图的体数据仍可能存在密度错误。外观补偿机制使中心密度翻倍、L2误差超14.52%时外部射线仍不变,密度恢复依赖外观容量、空间分辨率与测量设计。

TMLE与AIPW的样本分割选择:交叉拟合与重复分割的影响
一项TMLE与AIPW模拟研究发现,样本分割方式显著影响区间覆盖率:样本内拟合倾向得分可使覆盖率跌至0.12-0.48,双nuisance交叉拟合则恢复至0.91-1.00;近正性下AIPW优于未加权TMLE,重复划分降低划分依赖但使区间更保守。