用 HPA 扩展 Agent Substrate 中的 Actor 与 Worker

Agent Substrate 通过 Actor 挂起机制与 HPA 驱动的 Worker 按需扩展,解决 Agent 并发调度中的内存瓶颈。
Agent Substrate 将 Agent 运行环境抽象为 Actor,由 WorkerPool 统一管理 Worker 节点。Actor 默认处于挂起状态,仅在会话请求到达时被唤醒并尝试调度到有足够内存的 Worker 上,这种暖状态机制避免了冷启动延迟。由于每个 Worker 内存上限为 1Gi 而每个 Actor 需要 768Mi,单个 Worker 只能容纳一个 Actor,多余的 Actor 必须排队等待。手动挂起已调度的 Actor 可以临时释放内存,但批量场景下仍需自动化方案。文章展示了通过 HPA 将 WorkerPool 从 2 个副本扩展到 6 个副本后,六个排队 Actor 全部成功调度并返回 200,过程无需人工干预。这套方案实现了 Actor 层面的内存调度与 Worker 层面的副本扩展之间的职责分离,将扩展策略从预先分配大量资源转向按需动态伸缩,显著降低资源浪费并保证 Agent 的响应速度。
Agent 工作负载的扩展问题正变得愈发棘手——当多个 Agent 同时需要运行时,底层 Worker 的内存是否足够?如何在不浪费资源的前提下动态调度 Actor?Agent Substrate 给出的答案是把 HPA(Horizontal Pod Autoscaler)引入 WorkerPool 层面,让 Worker 按需扩缩。
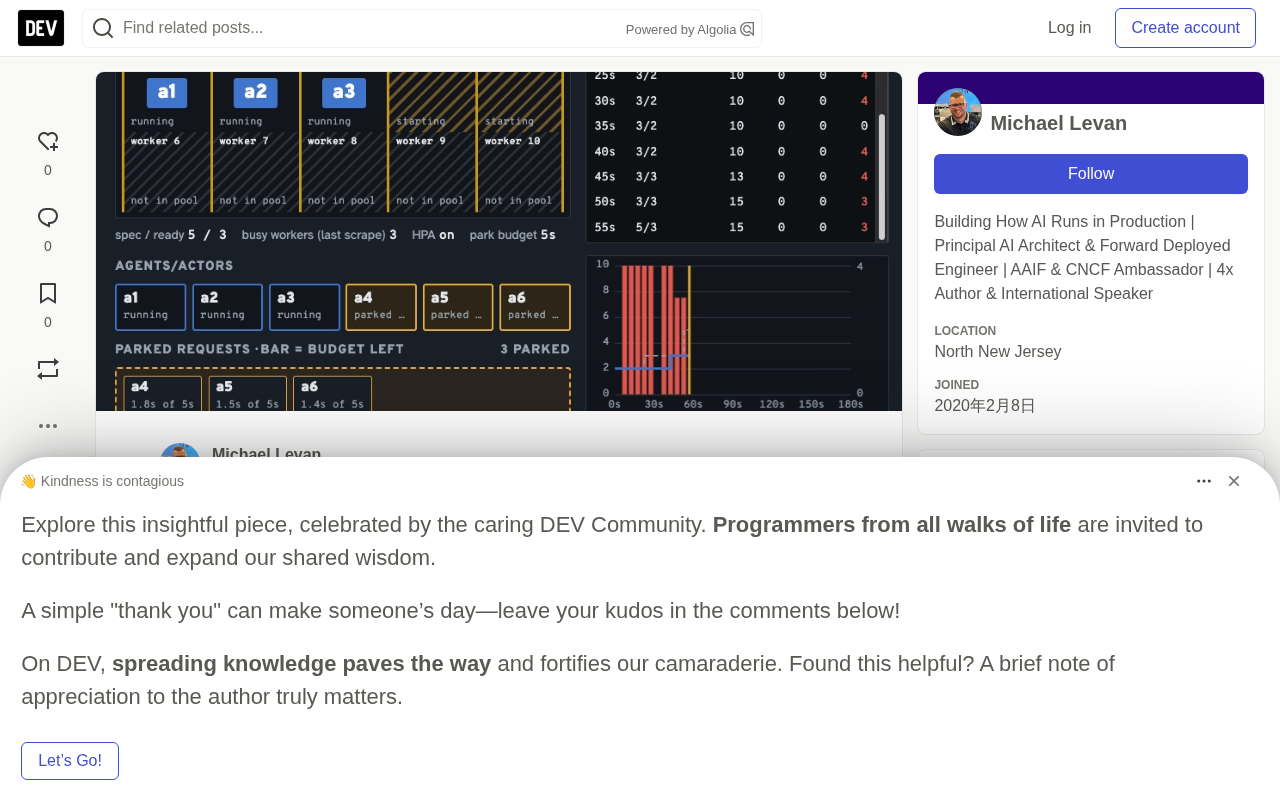
Agent Substrate 的调度模型
Agent Substrate 将 Agent 的运行环境抽象为 Actor,Actor 运行在 Worker 之上,而 Worker 由 WorkerPool 统一管理。这套层级结构的核心设计意图是:Actor 在未被调度时处于"挂起"(suspended)状态,仅作为记录存在,不消耗 CPU 或内存。只有当会话请求到达时,Actor 才被唤醒并尝试调度到有空闲内存的 Worker 上。
这种"暖状态"(warm state)机制避免了冷启动的数秒延迟。Actor 被唤醒后不会经历漫长的恢复过程,请求能够快速得到响应。对于需要频繁调用 Agent 的场景来说,这个设计直接决定了用户体验的好坏。
关键约束在于内存。WorkerPool 配置中每个 Worker 的内存上限为 1Gi,而每个 Actor 的模板要求 768Mi。这意味着一个 Worker 只能容纳一个 Actor——第二个 Actor 需要 1536Mi,超出上限后被调度器拒绝。
Actor 模型源于 1973 年 Carl Hewitt 提出的并发计算理论,其核心思想是:计算的基本单元是 Actor,每个 Actor 拥有独立的私有状态,Actor 之间仅通过异步消息传递进行通信,不共享内存。这一模型天然避免了锁竞争和共享状态带来的复杂性。在 Agent Substrate 中,Actor 被用来抽象一个 Agent 的运行环境——它包含了 Agent 所需的代码、依赖和运行时状态。之所以选择 Actor 抽象而非进程或容器,是因为 Agent 的调用模式具有明显的间歇性:会话到来时需要快速响应,会话结束后则长时间空闲。Actor 的挂起机制正好匹配这种模式——挂起时 Actor 仅保留状态快照而不占用计算资源,唤醒时则从快照恢复,省去了从头初始化的开销。
部署与挂起:Actor 的生命周期
部署 Actor 的过程很直接。通过以下命令可批量创建六个 Actor:
for i in 1 2 3 4 5 6; do
  kubectl ate create actor "a$i" -a ate-lab-burst --template burst
done
创建完成后,所有 Actor 初始状态均为 ACTOR_STATE_SUSPENDED,它们仅仅是一条记录加上 GCS 中的快照。六个 Actor 对应两个 Worker,形成了 3:1 的比例——两个 Actor 可以调度,剩余四个必须等待 Worker 释放内存后才能被唤醒。
用 curl 请求 Actor a1 和 a2 后,两个 Worker 被占满,每个 Worker 显示 768Mi/1Gi 的内存占用。此时再请求 a3,会收到 504 超时——没有足够的空闲内存来调度第三个 Actor。手动挂起 a1 释放内存后,a3 便能成功调度。这个手动过程验证了 Actor 调度对内存的强依赖。
HPA 如何解决 Worker 扩展问题
手动挂起 Actor 只是权宜之计。真正的问题在于:当多个 Actor 排队等待调度时,如何自动增加 Worker 数量?
HPA 配置允许 WorkerPool 扩展到最多 10 个副本。当六个 Actor 同时被唤醒(通过 ./scripts/burst.sh -m hold -d 120),前两个快速调度成功,其余四个因内存不足收到 504。此时将 WorkerPool 扩展到 6 个副本:
kubectl -n ate-lab-burst scale workerpool burst --replicas=6
Worker 从 2/2 扩展到 6/6,六个 Actor 全部获得调度,请求返回 200。整个过程无需手动干预 Actor 的挂起或恢复——HPA 感知到调度压力后自动增加 Worker 副本,队列中等待的 Actor 随即被分配。
这套机制的巧妙之处在于职责分离:Actor 层面只关心"有没有足够的 Worker 内存可调度",Worker 层面通过 HPA 响应负载信号来决定"是否需要更多副本"。两者互不干扰,但协同工作。
HPA(Horizontal Pod Autoscaler,水平 Pod 自动扩缩器)是 Kubernetes 原生提供的一种工作负载扩缩机制。它通过周期性地采集目标资源的度量指标(如 CPU 利用率、内存占用或自定义指标),将其与用户设定的目标阈值进行比较,然后按比例调整 Deployment、ReplicaSet 或 StatefulSet 等控制器所管理的 Pod 副本数量,使实际负载趋近于期望值。HPA 支持设置 minReplicas 与 maxReplicas 来限定扩缩边界,避免无限增长或缩容至零。在 Agent Substrate 的场景中,WorkerPool 被配置为 HPA 的扩缩目标,调度压力(即排队等待内存的 Actor 数量)成为触发扩容的信号。需要区分的是,HPA 处理的是横向副本数量的增减,而 VPA(Vertical Pod Autoscaler)调整的是单个 Pod 的资源配额。本文选择 HPA 而非 VPA,是因为单个 Worker 的内存上限决定了它只能容纳固定数量的 Actor,扩大单 Worker 内存无法解决调度瓶颈,增加 Worker 数量才是正确的扩展方向。
为什么 Agent 场景需要这种扩展能力
文章结尾提出了一个值得思考的观点:Agent 的可用性影响范围远超传统应用。一个普通应用宕机可能只影响某个部门或某项功能,但如果 Agent 不可用,整个组织的多个团队(工程、市场、HR)都可能受到波及。
Agent 正在被嵌入越来越多的日常工作流中,其扩展能力不再只是技术团队关心的问题。当一个组织有数十甚至上百个 Agent 同时运行时,底层 Worker 的调度效率直接决定了这些 Agent 能否可靠地响应请求。Agent Substrate 通过挂起-唤醒机制和 HPA 驱动的 Worker 扩展,试图在这两者之间找到平衡——既不让闲置 Actor 白白占用资源,也不让排队 Actor 无限等待。
从实践角度看,这套方案的核心价值在于把扩展策略从"预先分配大量资源"转向"按实际调度需求动态伸缩"。对于 Agent 密集型的部署环境,这种模式能显著降低资源浪费,同时保证响应速度。
相关推荐

Claude Code免费不限量方案:Agnes AI+CC Switch配置指南
无需付费订阅,用免费AI平台Agnes AI配合开源工具CC Switch为Claude Code提供后端,实现文本、图片、视频模型不限量免费调用。本文梳理安装配置全流程、实测效果与使用边界,帮助开发者低成本上手Claude Code。

国内新手零成本上手Claude Code完整指南
面向国内新手的 Claude Code 入门指南:两种安装方式(命令行与 IDE 插件)、用国产免费模型 LongCat 替代官方 API 的完整配置步骤,以及用自然语言开发小工具的实操演示与技巧。

当NSA都介入:开源CVE与API密钥劫持背后的AI供应链危机
一天内多个开源项目曝出严重CVE,PHP漏洞惊动FBI,Railway与OpenCode遭入侵致API密钥被窃。本文拆解漏洞窗口、AI加速利用与API密钥黑市背后的AI供应链危机,并给出开发者防御清单。