用Hugging Face Buckets与Webhooks自动转换CSV为Parquet

用 Hugging Face Buckets、Webhooks 与 Jobs 在云端自动把 CSV 转成 Parquet。
文章介绍如何用 Hugging Face 的 Buckets、Webhooks 和 Jobs 搭建一条全云端数据管道:新 CSV 文件落入输入桶后,Webhook 监听到变更并触发预先定义的 Job,由脚本把 CSV 转换成优化后的 Parquet 写入输出桶,全程无需把大文件下载到本地再上传。演示以 NYC Taxi 数据为例,先创建输入桶和私有的输出桶,再运行 Job 取得 Job ID,用该 ID 和登录 token 创建 Webhook。实测上传 10,000 行新文件后约 8 秒完成转换,日志和递归列桶均确认产出。作者指出该模式适合日志归档等事件驱动场景,但演示规模小,落地还需补充错误处理、资源配额与并发命名冲突等考量。
Hugging Face 的 Buckets、Webhooks 和 Jobs 三项功能组合起来,可以搭建一条完全在云端运行的数据管道:新 CSV 文件落入存储桶后,Webhook 自动触发 Job,把文件转换成优化后的 Parquet 格式。整个过程不需要把大文件下载到本地再上传回去,对经常处理时序数据文件的团队来说,这套方案值得了解。
为什么需要自动化转换
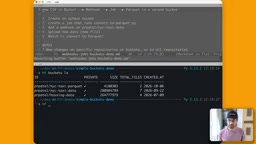
Buckets 适合存放随时间陆续到达的文件,例如日志、扫描件和新的数据文件。文件进入桶之后,通常还要做清洗、转换等数据工程任务。视频中用纽约出租车(NYC Taxi)数据做演示,输入桶存放 CSV,输出桶接收 Parquet,两个桶各司其职。
如果每次都手动操作,文件的搬运和格式转换会消耗大量时间。Webhooks 与 Jobs 的价值在于:文件一到,事件触发,计算自动开始,结果直接写入指定位置。这在小规模试用时看不出优势,但文件持续到达时,人工流程很容易成为瓶颈。
Parquet 是一种面向分析场景的列式存储格式,与 CSV 这类按行组织的文本格式不同,它按列存储数据并附带 schema、压缩编码和统计信息。对时序数据而言,列式布局让查询只需读取涉及的列,压缩率也通常显著高于文本 CSV,因此在大文件反复扫描的场景下 I/O 成本更低。把原始 CSV 转成优化后的 Parquet,本质上是在数据进入分析流程前完成一次物化,后续读取不必再解析文本、推断类型。
准备两个存储桶
演示中通过命令行创建桶,命令形如 hf buckets create,后面跟桶的位置,用户名要放在桶名前面。创建 Parquet 输出桶时加了 private 标志,使桶仅自己可见;不加这个标志,桶就是公开的。
可以用 hf buckets ls 查看账号下已有的桶。作者账号里当时有三个桶,演示使用 nyc-taxi-data 作为输入桶、nyc-taxi-parquet 作为输出桶。把输入和输出分开的做法,方便后续对结果文件单独做权限控制和生命周期管理。
创建可被 Webhook 调用的 Job
Job 的定义指向一个脚本,演示中叫 optimized_parquet.py,负责读入 CSV 并生成优化后的 Parquet 文件。这里有个关键细节:直接在 Hub 上运行 Job 时,它只会执行一次;该脚本会查找一个 Webhook ID,因此在 Webhook 尚未创建时运行,脚本实际上什么也不做。
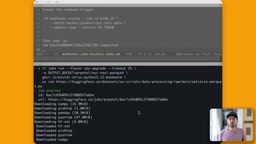
运行后会得到一个 Job ID。这个 ID 是下一步创建 Webhook 的输入参数,作者把它放进环境变量,再传给创建 Webhook 的命令。
Webhook 是一种由事件驱动的回调机制:当被监听对象发生指定变更时,平台会向预先注册的接收方发起一次调用,而不是由使用方定时轮询。本文中“监听桶变更”意味着每当输入桶出现新文件,平台就触发与之绑定的 Job,把事件负载传给脚本。与轮询相比,事件驱动的延迟更低、空转更少;代价是需要处理好重复投递、调用失败等边界情况,这也是脚本必须先拿到 Webhook ID 才能确定自身触发上下文的原因。
用 Webhook 监听文件变化
Webhook 用来监听特定用户或组织下某个仓库或桶的变更。它不只服务于 Webhook 的所有者,Hugging Face 上的其他用户同样可以使用这一机制。
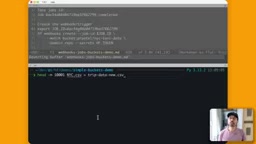
创建命令形如 hf webhooks create,需要提供 Job ID、要监听的桶(这里是输入桶 nyc-taxi-data),以及当前登录用户的 Hugging Face token。执行成功后,Webhook 就建立起来了,之后输入桶里出现新文件时会自动触发对应的 Job。
实测:从上传到产出 Parquet
为了验证链路,作者从原始数据中取前 10,000 行,生成新文件 tripdata_new.csv,再用 hf sync 把这个目录同步到 hf://buckets/<用户名>/nyc-taxi-data。同步过程很快,底层使用了去重机制。
文件同步完成后,Webhook 触发 Job。用 hf jobs ps -a 查看状态,可以看到该 Job 状态为 completed,耗时约 8 秒。
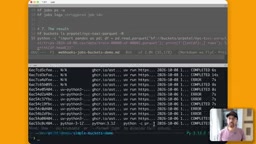
用 hf jobs logs <job-id> 可以查看 Job 日志,输出信息显示文件已写入 buckets/<用户名>/nyc-taxi-parquet/tripdata_new.csv。再用 hf buckets ls <用户名>/nyc-taxi-parquet -R 递归列出输出桶内容,可以看到新生成的 Parquet 文件。至此,从 CSV 落桶到 Parquet 产出的整条链路跑通。
hf sync 是 Hugging Face 命令行工具中用于本地目录与远程仓库或桶之间双向同步的命令,它只传输有差异的文件,而不是每次全量覆盖。这种增量同步依赖对文件内容或元信息的比对来实现去重,因此重复同步同一目录时耗时很短。对数据管道而言,增量同步意味着新文件落桶的开销与已有数据量基本无关,适合文件持续累积、单次只新增少量文件的场景。
这套方案适合什么场景
从演示看,这套组合的优势集中在三点:文件在云端流转,省去大文件上下行;事件驱动,无需轮询;Job 定义一次后可重复使用。对于日志归档、定期到达的数据集等场景,这种模式比手工脚本更省心。
不过演示规模很小,单文件 10,000 行、处理耗时 8 秒。真实业务中文件更大、并发更多时,需要额外考虑 Job 的资源配置、失败重试和输出文件命名冲突等问题。视频本身也没有覆盖错误处理和权限边界,这些是落地前需要自己补齐的部分。
作者在视频描述中提供了包含笔记和演示代码的仓库链接,以及 Webhooks 的完整教程,适合想动手实验的读者进一步参考。
相关推荐

开源多Agent模拟经营项目实战评测
基于B站UP主开源的多Agent沙盘经营项目实测,拆解其规划、记忆、多Agent通信、HITL与评估机制,对比大模型自主决策与固定规则引擎在不同场景下的收益差异,为Agent开发者提供选型与工程实践参考。
AI工程化实战:Claude Code与Agent Skill开发全流程
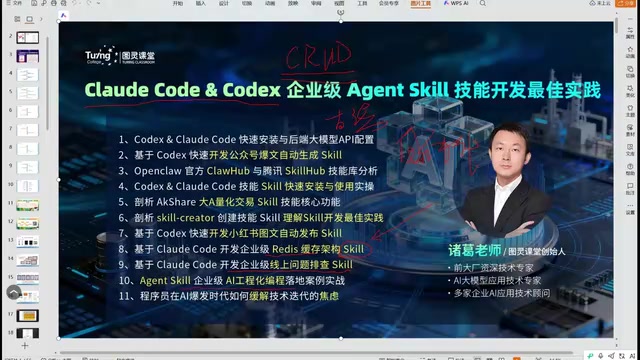
B站实战课解析AI工程化:用Claude Code、Codex、WorkBuddy开发企业级Agent Skill,涵盖公众号报文、量化分析、小红书自动发布等案例,讲透Skill驱动开发的范式转移与工具选型。
LangChain零基础入门:结构化输出与Agent实战指南
从LangChain零基础讲起,厘清低代码平台与大模型应用开发的本质区别,覆盖结构化输出、工具调用、Agent实战与多租户RAG企业项目落地四大模块,适合有开发基础想转型AI应用开发的工程师。