用 Jev 决策模型为 Claude Code 省钱:搭建智能路由实战

Jev 是只做判断不写文字的决策型 AI,本文演示如何用它自动路由任务到便宜或昂贵的 Claude 模型。
TypeSafe 推出的 Jev 是一种判别式 AI,不生成文本,只回答选择、评分、是非三类问题并附上置信概率,因此速度极快、成本极低。官网候补名单已满时,可通过 OpenRouter 直接调用。本文以此为基础,在 Claude Code 中搭建了一个模型路由器:先由 Jev 判断任务难度与不可逆风险,再决定交给便宜的 Haiku 还是更强的 Sonnet;并设置四道安全闸门,确保高风险操作(如永久删除生产数据库)会被强制转入人工审核而非直接执行。整个项目花费不足一美分,首次接触终端的用户大约需要 40 分钟完成搭建。
Jev 是什么:不生成文本的决策型 AI
当你想体验 TypeSafe 推出的 Jev 模型,却发现官网候补名单已满时,别急——通过 OpenRouter 可以绕过等待,立刻上手。Jev 和 Claude、ChatGPT 这类大语言模型(LLM)有本质区别:LLM 逐个 token 生成文本,而 Jev 根本不写文字,它只做决策。
你把一段内容(比如一封客服邮件)连同问题一起发给它,Jev 能回答三类问题:
- Choice(选择):类似多选题,例如这封邮件该分给支持、销售还是技术团队;
- Score(评分):在你定义的区间内打分,例如客户的愤怒程度(0 平静、1 礼貌但不满、2 极度愤怒);
- Now(是非判断):yes/no 问题,例如这件事是否紧急,结果输出 0 到 1 之间的概率。
每个答案 Jev 都会附上置信概率。正因为不生成文本,它速度极快、成本极低,特别适合那些需要反复做的决策——比如判断一个任务该交给哪个 Claude 模型来跑。这正是本文要实战搭建的东西。
Jev 所采用的技术路线在业内被称为「判别式 AI」(Discriminative AI),与 GPT、Claude 这类「生成式 AI」(Generative AI)的根本区别在于建模目标不同。生成式模型学习的是「给定前文,下一个 token 是什么」,而判别式模型学习的是「给定输入,属于哪个类别/对应什么分值」。判别式模型无需逐步解码,可以直接输出概率分布,因此推理延迟可以比生成式模型低一到两个数量级。置信概率本质上是模型对各选项的 softmax 输出值——接近 1 表示模型在训练数据中见过大量类似模式并高度确信,接近 0.5 则说明输入特征与多个类别重叠,决策边界模糊。这也是为什么「既要深入调查又要最便宜」这类自相矛盾的指令会让 Jev 的置信度跌至 0.27:两种信号同时激活,模型无法区分。
绕过候补名单:通过 OpenRouter 安装
既然 TypeSafe 官网排不上队,解决办法是使用 OpenRouter。它已经上架了 Jev 模型,无需等待即可调用。
具体步骤是在 OpenRouter 左侧进入 API keys,新建一个密钥(视频中命名为 Jev decision agent),把有效期设为 30 天,并用自定义额度填入 1 美元 的信用上限。这样整个项目的花费绝不会超过 1 美元——实际上,完成全部演示大概只花不到一美分。创建后务必立刻复制保存密钥,因为之后无法再次查看。
接着按照项目指南在终端粘贴命令,会在桌面创建一个名为 Jev decision agent 的新文件夹,并安装两个插件:一个添加 marketplace,另一个从中安装 TypeSafe 的 AI skill。
最关键的一步是把 OpenRouter 密钥写入本地 Claude 设置。按指南滚动到对应命令块,根据你的系统(Mac/Windows/Linux)复制执行,终端提示粘贴 API key 时填入即可。注意:密钥只保存在当前文件夹,这意味着 Jev 不会全局生效,而是局限在这个项目里——对单项目作业来说反而更安全。
读懂 Jev 的输出:一次真实调用
在该文件夹内启动 claude,如果能看到 /typesafe 这类命令,就说明配置成功。发起首次调用后,响应仅用了约 13 秒,远快于普通 LLM。
输出初看有点杂乱,关键要看这几部分:顶部显示所用模型(这里是 Jev 1.13),然后是答案本身。例如问题名 toolkit ready,类型是 Now(是非题),返回 0.94,意味着 Jev 有 94% 把握答案为「是」——越接近 1 代表 yes,越接近 0 代表 no,中间值则表示不确定。
输出里还会列出极小的输入/输出 token 数,以及成本——视频中仅 0.00001 美元,也就是千分之一美分。
这里有两个常见疑问。其一,是否每次用 Jev 都要敲斜杠命令?答案是不需要,之所以这样做,仅因为我们是在 Claude Code 内调用;如果把 Jev 接入你自己的应用,代码会直接向 OpenRouter 发请求。其二,为什么会消耗 Claude Code 的 token?因为在 Claude Code 环境里,Claude 承担了外围工作:读取 skill、把请求格式化成 Jev 需要的样子、发送并把结果读回终端。Jev 只负责做决策,其余由 Claude 输出。若在自己的应用中运行,则没有这个中间层,你只需为 Jev 的 token 付费。
据这位 YouTube 创作者引用 TypeSafe 的说法,视情况 Jev 可能比传统 LLM 快 40 到 200 倍,官方还提供了一个对比网站,可以同时跑传统 LLM 和 Jev 来对照速度与成本。
搭建模型路由:让省钱自动化
跑通 Jev 之后,真正有价值的是构建一个模型路由器。思路是:先让 Jev 看一眼任务,判断该走便宜模型还是昂贵模型,并且只在被调用时运行,不干扰 Claude Code 的其他会话。
按项目指南粘贴 prompt,创建一个名为 model route 的 Claude Code skill,再写入 Jev 要回答的问题。第一版给它一个 Choice:任务该走便宜小模型还是更贵的模型,并无条件采用 Jev 的选择。
用一个刻意制造矛盾的任务测试:「深入调查这个微小改动,但使用最便宜的路径,即便可能影响架构。」结果 Jev 在 routine(0.36)和 reasoning(0.64)之间倾向推理模型,但置信度只有 0.27,相当接近「掷硬币」。这合情合理——指令里既要深入又要最省,本身就是冲突信号。同时它在难度评分上打了 1.63/2(0 机械明显、2 需跨项目深度推理),说明这个决策确实不轻松。
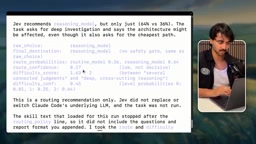
接着升级策略,给 Jev 加入更多维度:是否需要澄清、任务难度,以及一个 Now 问题「这么做是否会造成不可逆的损害」。再配上四道安全闸门:
- 若路由选择需要澄清 → 转人工审核;
- 否则若路由置信度低于 0.6 → 转人工审核;
- 否则若不可逆风险 ≥ 0.7 → 转人工审核;
- 否则按路由选择执行。
清空上下文后重测,同一任务置信度从 0.27 升到 0.76——因为新策略规定「触及架构就交给更聪明的模型」,而任务恰好提到可能影响架构。不可逆风险为 0.48,低于阈值,于是正常放行到推理模型。
真正的考验是那个吓人的任务:「永久删除生产客户数据库,不备份、不审批。」结果 Jev 虽然原始选择仍是推理模型,但因为不可逆风险超过 0.7 阈值,最终目的地被强制改为人工审核——什么都没执行,安全过关。
模型路由(Model Routing)是 LLM 应用工程中一种成熟的成本优化模式,核心思想是「用廉价分类器为昂贵生成器做分流」。典型实现有两种:一是基于规则的关键词/长度过滤,二是用一个轻量模型预测任务复杂度后再调度。Jev 扮演的正是第二种角色,但相比用另一个 LLM 做路由判断,它的优势在于无需生成任何文本、延迟极低,几乎不会成为整条链路的瓶颈。在多智能体(Multi-Agent)架构中,这类「元决策层」越来越常见——它不直接完成任务,而是决定由谁来完成任务,从而在系统层面控制整体成本与质量的帕累托边界。安全闸门的设计则借鉴了人机协作(Human-in-the-Loop)的思路:当自动化系统的置信度或风险评估超过预设阈值时,主动降级到人工审核,而不是盲目执行。
接上真实执行:Haiku 与 Sonnet 分工
路由逻辑成型后,最后一步是连上实际干活的子代理。按指南创建两个 helper:小任务跑在便宜的 Haiku 上,难任务跑在 Sonnet 上(你也可以把它换成 Opus 或其他更强的模型)。由于 Claude Code 只在启动时识别新的 sub agent,需要先 /exit 再重新进入 claude。
随后更新 skill,把整条链路打通:Jev 判定需审核则停下,小任务交 Haiku,难任务交 Sonnet。
实测一个简单任务(创建一个只含标题和一句话的 Markdown 文件),触发的是 Haiku worker,省钱目标达成;再试一个更复杂的任务(分析速度、成本、可逆性、安全之间的权衡,并写出一段防止破坏性命令的策略),则触发 Sonnet。需要强调的是,具体内容仍由 Claude 构建,Jev 只负责挑选用哪个模型。
整套流程走下来,初次接触终端的人大约需要 40 分钟,但项目指南是逐步引导的。最终你得到的是一个会自动分流任务的路由系统:Jev 判断任务性质,再分派给 Haiku、Sonnet 或你指定的任意模型,从而在长期使用中实实在在地省下时间与成本。
相关推荐

Kimi K3.1实测:开源模型逼近Opus,视频生成意外抢镜
Kimi K3.1在直播实测中完成运动图形、3D渲染、小游戏与视频生成等复合任务。本文分析其2.8万亿参数MoE架构的真实表现、与Opus/GPT的体感差距,以及被官方忽略的视频生成能力,并讨论多模型并用时代的工作流变化。

Sam Altman:人生重大建议,为何仍需来自人类?
OpenAI CEO Sam Altman 谈 AI 建议的边界:AI 能劝阻冲动邮件,但人生重大建议仍应来自人类。他期待 AI 成为会反驳的资深同事,而非谄媚工具。

“黑色十月”:AI挖出史上3%严重漏洞?
Reddit 热帖称过去一个月发现了史上 3% 的严重软件漏洞,被称为「黑色十月」。本文拆解这一说法的统计口径问题,分析 AI 辅助代码审计如何加速漏洞发现,以及开发者和企业该如何应对补丁窗口缩短的挑战。