用Jev加速Hermes智能体:快慢模型分工的工程实践

用轻量模型Jev做前置分类,将智能体简单请求响应从秒级降至百毫秒级。
文章介绍了如何通过分层决策架构加速AI智能体:Hermes执行框架依赖复杂推理模型(如GPT、Claude),导致简单请求也需数秒响应。解决方案是引入极快的Jev模型作为前置分类器,在约100-200毫秒内完成用户意图判断,随后硬编码执行固定命令,省去推理开销。对比显示,简单请求响应从2-5秒降至数百毫秒;任务越复杂,时间差越明显。该方案适用于意图类别可枚举的场景,为运维助手、客服分流等工具提供了快慢分层的工程启示。
在构建AI智能体时,响应速度往往是用户体验的关键瓶颈。一个复杂的推理模型虽然能处理棘手问题,但面对简单请求时却显得笨重迟缓。如何在不牺牲智能的前提下大幅提速?一种思路是把"快速决策"和"深度推理"拆开,交给不同的模型分工处理。来自YouTube的一段技术分享,详细演示了如何用轻量级的Jev模型来加速Hermes智能体框架的执行流程。
Hermes智能体框架与推理模型的瓶颈
据视频讲解,Hermes本质上是一个"harness"(执行框架/外壳),它本身并不生产智能,而是负责组织与模型交互的完整闭环——包括循环逻辑、技能调用、系统提示词、工具调用等。Hermes的特点是具备自我改进能力,而它背后实际调用的是某个复杂推理模型,比如GPT系列、Claude系列或某个开源权重模型。
问题在于,即便底层模型本身速度很快,它在做决策时依然需要"思考"。对于一个简单的判断——用户到底想要什么——推理模型也要经历完整的推理链条,这在时间上并不划算。讲解者指出,这种结构决定了响应时间往往停留在秒级,而非毫秒级。
智能体框架(Agent Harness) 是连接大语言模型与外部环境的中间层,负责管理对话循环、调用工具、拼接上下文、维护状态等。它本身不产生智能,而是将模型的原生能力组织成可执行的流程。常见的开源框架如LangChain、AutoGPT、CrewAI等都属于此类。Hermes的特殊之处在于强调“自我改进”——它可能根据执行反馈自动优化提示词或工具选择策略,但底层仍需依赖外部推理模型完成核心决策。这种分离设计使得框架的响应速度受限于所调用模型,而非框架自身的调度效率。
核心思路:用Jev处理简单决策
视频提出的解决方案是引入Jev作为"前置分类器"。Jev的特点是极快,在做出简单判断时延迟极低。具体做法是:将用户的prompt先交给Jev,让它根据预设的几个类别快速归类。
讲解者举了一个服务器运维的场景:假设用户的提问只可能落在三种意图上——查询磁盘使用情况、查询CPU使用情况、或查看内核级错误日志。把用户prompt输入Jev后,它可以在约100毫秒内(加上服务器延迟约200毫秒)给出分类结果。
一旦分类确定,后续动作就可以硬编码:如果判断为"磁盘使用",直接执行对应命令并返回输出。整条路径几乎无需推理,响应时间被压缩到数百毫秒。
前置分类器(Pre-classifier) 是一种轻量级模型,专门用于对用户输入进行快速意图识别或路由。它通常比通用推理模型小得多,推理延迟可控制在百毫秒以内。在智能体架构中,前置分类器将开放的自然语言请求映射到预定义的有限类别,从而让后续流程可以走硬编码的快速路径。这种设计借鉴了传统软件工程中的“路由”模式,但用机器学习模型替代了规则匹配,以处理一定的语言多样性。Jev作为此类模型的一个实例,其分类能力依赖于训练时覆盖的意图范围,因此适用场景需提前定义好类别边界。
快慢路径的对比:200毫秒 vs 数秒
讲解者做了直接的对比。同样一条"查询磁盘使用情况"的请求,如果交给Claude或GPT等推理模型,模型需要先理解意图、再决定调用工具、再执行命令、最后返回结果。即便模型速度不错,这一链条通常也要2秒、甚至5秒才能完成——因为推理本身需要时间。
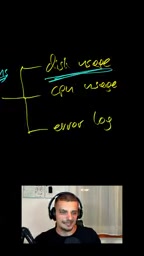
而Jev路径把这些"理解意图"的工作前置并简化,后续动作因为类别有限而可以直接映射到固定命令,省去了推理开销。对于只需要一个简单命令就能回答的请求,这个差距非常明显。
推理延迟(Inference Latency) 指模型从接收输入到生成输出所需的时间,通常受模型参数量、生成长度、硬件算力等因素影响。复杂推理模型(如GPT-4、Claude 3)由于需要进行多步思维链(Chain-of-Thought)推理,延迟常在秒级;而轻量级模型(如Jev)通过减少参数量和优化架构,可将单次前向传播延迟压缩到毫秒级。在智能体场景中,延迟不仅来自模型本身,还包括工具调用、网络往返等开销。因此,将简单决策卸载到轻量模型,能显著降低端到端响应时间,提升用户体验。
复杂场景下优势更明显
更关键的是,当任务不是单一命令、而是一组命令或更复杂的决策链时,推理模型的耗时还会进一步拉长。讲解者指出,这类任务在推理模型上会"更慢",而Jev依然能以极快速度完成分类判断,之后再按预设路径执行。
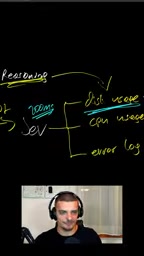
这意味着Jev的加速效果并非只体现在单一场景,而是随着决策复杂度上升,快慢两条路径的时间差会被进一步放大。对于自动化流程来说,这种差距直接影响吞吐量和用户等待感受。
工程启示:分层决策的智能体架构
这段分享的价值不在于某个具体模型,而在于一种架构思路:把智能体的决策拆成"快判断"和"慢推理"两层。Jev负责高频、低复杂度的意图识别与路由,推理模型只在真正需要深度思考时才介入。
这种分工带来几个实际好处。延迟上,常见请求走快路径,响应从秒级降到百毫秒级。成本上,简单请求不必消耗昂贵的推理模型算力。可靠性上,硬编码的执行路径比模型自由发挥更可控。当然,这套方案也有适用边界——它依赖于意图类别可枚举、可预定义;如果用户请求高度开放,Jev的分类能力可能不足以覆盖,仍需要推理模型兜底。
对于正在构建运维助手、客服分流或命令自动化工具的开发者,这种快慢分层值得借鉴:先用轻量模型做路由,把复杂推理留给真正需要的环节。
相关推荐

FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。

前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。