用集合级强化学习训练LLM生成多样化科研想法

论文用集合级强化学习训练LLM批量生成扎根文档、彼此互异且可执行的高质量科研想法。
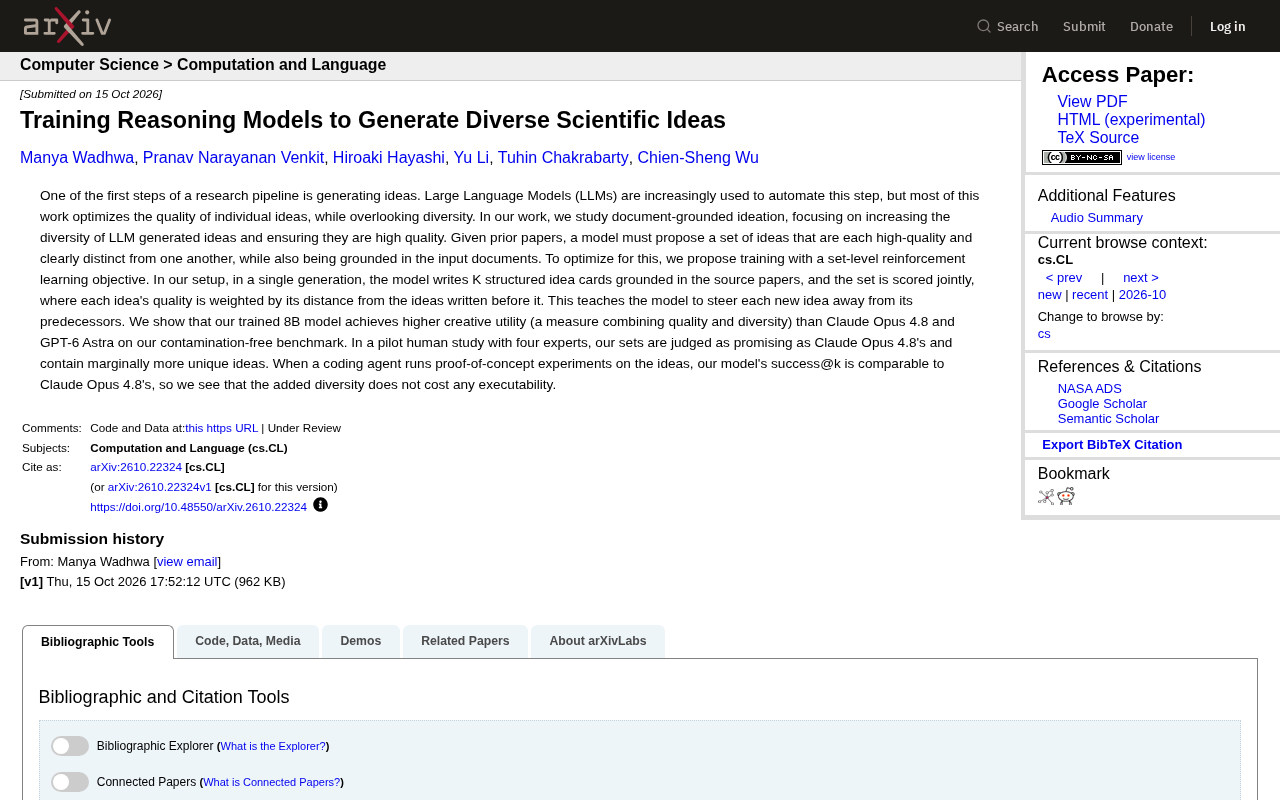
本文介绍一项将多样性从评估指标升级为训练信号的工作。针对文档锚定想法生成中"单个想法质量高但彼此雷同"的问题,论文提出集合级强化学习目标:模型单次生成 K 张以源论文为锚点的想法卡片,整组联合打分,每个想法的质量分数按其与前面已生成想法的距离加权,越近权重越低,从而在生成过程中而非后处理阶段实现自我去重。结果显示,训练后的 8B 模型在无污染基准上的创意效用超过 Claude Opus 4.8 与 GPT-6 Astra;四位专家的人类研究中其想法集合被认为同样有前景且独特想法略多;编码智能体执行概念验证实验时 success@k 也相当,说明多样性没有牺牲可执行性。作者同时指出人类研究样本有限,结论仍需更多复现。
用集合级强化学习训练LLM生成多样化科研想法
科研流程的第一步往往是"提出想法"。LLM 正在被越来越多地用于自动化这一步,但现有工作大多只优化单个想法的质量,忽略了多样性。一篇新论文提出了文档锚定的想法生成任务,目标不仅是让模型产生高质量的想法,还要让同一批想法之间彼此足够不同。
问题:想法质量高,但全都"长一个样"
在文档锚定的想法生成场景中,模型需要基于给定论文提出一组想法,每个想法都要满足两个条件:本身质量足够高,且与其他想法明显区分。同时,所有想法都必须扎根于输入文档,不能凭空发挥。
这里有一个被此前研究忽视的张力:如果只按"单个想法好不好"来训练或评估模型,模型会倾向于收敛到某种最安全的表达模式,生成的想法虽然平均质量不差,但彼此高度雷同。而科研的价值恰恰在于探索不同方向,一组同质化的想法对研究者的参考意义有限。
**文档锚定(document-grounded)**指的是生成内容必须以给定输入文档为事实与语境基础,而不是依赖模型自身的参数记忆自由发挥。在这类任务中,输入通常是一篇论文的标题、摘要或全文,模型提出的每个想法都需要能够溯源到文档中的问题设定、方法或局限,例如针对论文未解决的某个假设提出验证方案。文档锚定的意义在于抑制幻觉:没有锚点的想法生成容易产出听起来合理、实则与源论文无关的内容,也会让不同想法之间失去可比性。它同时约束了多样性的边界——想法可以彼此不同,但都要落在同一篇论文所划定的问题空间内,这使得"多样性"与"相关性"需要被同时优化,而不是二选一。
方法:集合级强化学习,让新想法"远离"旧想法
论文提出的核心方案是集合级(set-level)强化学习目标。具体做法是:在单次生成中,模型一次性写出 K 张结构化的"想法卡片",这些卡片都以源论文为锚点。
关键在于评分方式——整个集合被联合打分,而不是每张卡片独立打分。每个想法的质量分数会根据它与前面已生成想法的距离进行加权:越靠近前文的想法的权重被压低,越远则保留更多权重。这种设计在训练中教模型主动把每个新想法推离前面的想法,形成一种"自我去重"的生成策略。
这一机制与常见的"先生成再筛选"不同。它不是靠后处理过滤掉重复项,而是把多样性直接编织进生成过程中,让模型在写下一个想法时就意识到前文已经占据的方向。
**强化学习(RL)**用于训练语言模型时,通常需要一个可自动计算的奖励信号来替代人工逐条标注。模型对同一提示采样多条输出,按奖励高低调整各条输出被选中的概率:奖励高的轨迹被强化,奖励低的被抑制。奖励可以来自可验证的答案、规则打分,或另一个模型给出的评判。相比监督微调,RL 的优势在于能优化那些难以用标准答案直接监督的目标——例如"一组输出之间的差异程度",这类目标没有唯一正确答案,只能通过打分函数间接刻画。本文的集合级目标正是把整个 K 张卡片的集合作为一条待评分的轨迹,奖励由质量与集合内距离共同决定,因此模型在采样阶段就能感知前文已生成的内容,而非事后过滤。
结果:8B 模型在创意效用上超过更大模型
论文报告了几个值得关注的结果:
- 在无污染基准上,经过训练的 8B 模型在"创意效用"(creative utility,一个结合质量与多样性的指标)上超过了 Claude Opus 4.8 和 GPT-6 Astra。
- 在四位专家参与的初步人类研究中,该模型生成的想法集合被评价为与 Claude Opus 4.8 同样有前景,并且在独特想法数量上略多。
- 当编码智能体对这些想法执行概念验证实验时,该模型的 success@k 与 Claude Opus 4.8 相当,说明提升多样性没有以牺牲可执行性为代价。
最后一点尤其关键。多样性与可执行性常被认为存在取舍:想法越天马行空,越难落地。但在这项工作中,两者并未冲突。
**无污染基准(contamination-free benchmark)**指评测数据未被纳入模型训练语料,或至少能证明模型在训练时未见过其答案。大模型评测中一个常见隐患是数据泄漏:若测试集的题目或答案曾出现在预训练数据里,模型可能靠记忆而非推理得分,导致结果虚高。对于想法生成这类任务,污染还表现为模型"回忆"起某篇论文的相关讨论而非真正基于输入文档推理。因此在无污染基准上比较,才能较可信地反映模型的实际生成与泛化能力。本文强调这一点,意在说明 8B 模型超过更大模型的结果并非测试集泄漏所致。
success@k 是一种批量评估指标:给定 k 个候选想法,若其中至少有若干个被下游实验或人工判定为成功(例如概念验证实验跑通、结论成立),就记为一次命中。它衡量的是"一组输出中能否找到可行方案",而非单个输出的平均表现。当候选想法由编码智能体自动执行时,success@k 能同时反映想法的可执行性与集合覆盖度:只要集合中有一个想法能被实现并验证,研究者就有继续投入的价值。这与创意效用形成互补——创意效用考察质量与多样性的平衡,success@k 则检验这种多样性是否仍停留在可落地范围内,两者共同支撑本文"多样性未牺牲可执行性"的结论。
几点观察
这套方法把"多样性"从评估指标提升为训练信号,思路有借鉴价值。集合级评分的设计可以迁移到其他需要批量生成且要求互异的场景,比如营销文案、测试用例、竞品分析维度等。
另一方面,人类研究只有四位专家,样本规模有限,结论更适合作为方向性证据而非定论。8B 模型在创意效用上超过更大模型的结论,也需要在更多基准和任务上复现。
总体而言,这项工作提醒我们:当 LLM 被用于"批量产出"时,评估和训练的单位也许不该是单个输出,而是整个输出集合。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。