用激活引导改进思维模型在线自蒸馏
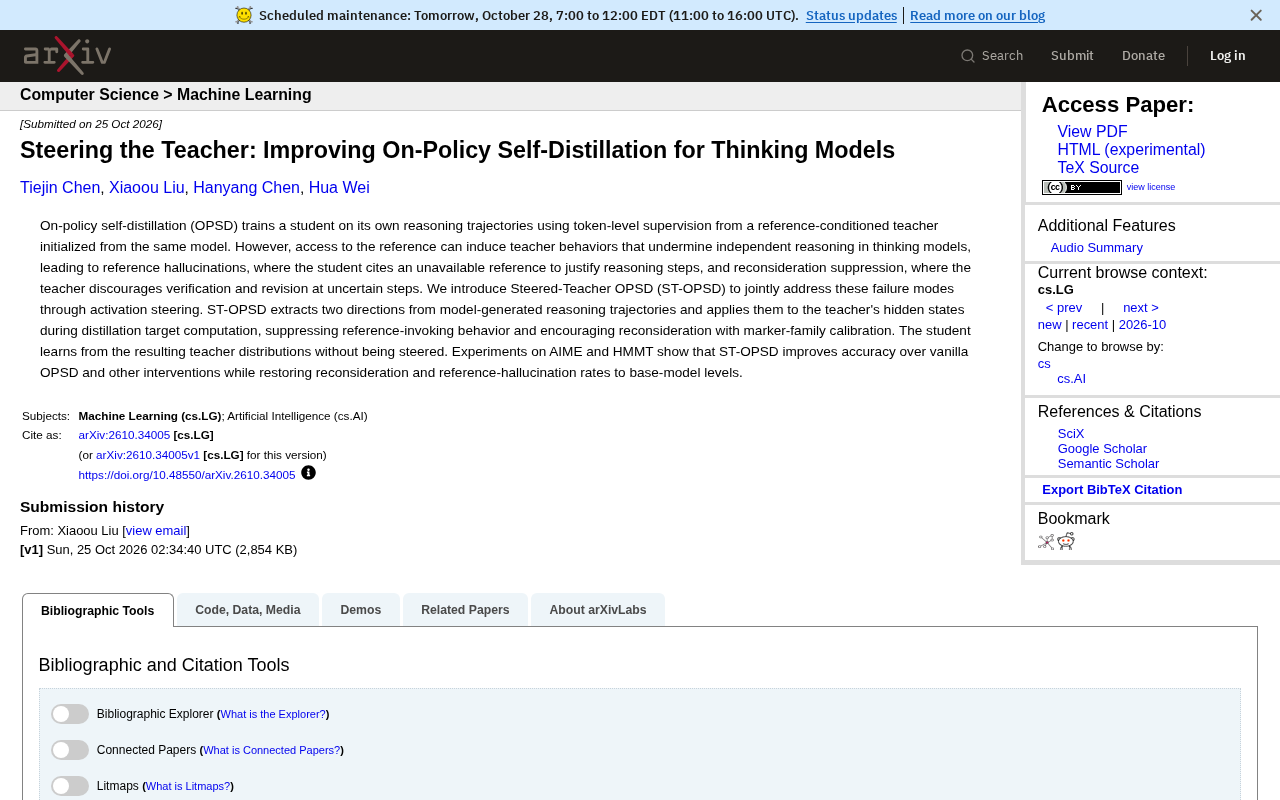
ST-OPSD 用激活引导修正教师模型,解决在线自蒸馏中的参考幻觉与 reconsideration 抑制。
本文介绍 Steered-Teacher OPSD(ST-OPSD),一种改进在线自蒸馏(OPSD)训练思维模型的方法。OPSD 中教师模型因访问参考条件,可能产生参考幻觉和 reconsideration 抑制两种失败模式,并将有害行为传递给学生。ST-OPSD 的核心是仅引导教师模型:从推理轨迹中提取抑制参考调用和鼓励 reconsideration 的方向向量,在计算蒸馏目标时施加到教师隐藏状态上,并引入 marker-family 校准增强效果。学生模型不被引导,仍按自身策略生成轨迹,从被修正的教师分布中学习。在 AIME 和 HMMT 数学推理基准上,ST-OPSD 相比原始 OPSD 提升了准确率,并将 reconsideration 和参考幻觉率恢复到基础模型水平,在提高任务性能的同时修复了行为偏差。
引言
在线自蒸馏(On-policy Self-Distillation, OPSD)是训练思维模型(Thinking Models)的一种有效方法:学生模型在自己的推理轨迹上接受 token 级监督,而监督信号来自一个以参考条件初始化的教师模型——该教师模型与学生模型同源。然而,这种参考条件的存在可能诱发教师模型产生不利于独立推理的行为,进而传递给学生。近期一篇研究提出了 Steered-Teacher OPSD(ST-OPSD),通过激活引导(activation steering)技术,同时缓解两种关键失败模式:参考幻觉与 reconsideration 抑制。
在线自蒸馏(On-policy Self-Distillation, OPSD) 与传统的离线知识蒸馏不同,它强调学生模型使用自己生成的轨迹(on-policy)进行学习,而非固定数据集上的轨迹。在思维模型的训练中,OPSD 通常设置一个与学生同源的教师模型,该教师模型能够访问额外的参考信息(如标准答案或解题提示),并在学生自己探索出的推理路径上提供 token 级软标签。这种同源教师避免了模型容量差异带来的分布不匹配,同时利用参考信息提升监督质量,但参考条件的存在也引入了教师行为偏离的风险,这正是本文讨论的出发点。
问题:参考条件带来的两种失败模式
OPSD 的核心在于教师模型能够访问参考信息(reference),从而为学生提供更准确的 token 级分布。但问题也源于此:教师模型可能过度依赖参考,表现出两种有害行为。
参考幻觉
学生模型在推理时引用一个 不可用的参考 来佐证推理步骤,即“参考幻觉”(reference hallucination)。这破坏了推理的独立性,学生可能编造参考内容来支持自己的结论,而非真正基于问题本身进行推导。
参考幻觉(reference hallucination) 与常说的“事实幻觉”有所不同。事实幻觉指模型生成与事实不符的内容,而参考幻觉特指模型在推理中虚构或错误引用一个外部参考来源(例如声称“根据参考答案……”或“题目提示指出……”),即使该参考在推理时并不可用或并不存在。在 OPSD 中,教师模型因训练时习惯依赖参考条件,可能将这种依赖模式传递给学生,导致学生在独立推理时也编造参考依据,从而削弱基于问题本身的逻辑推导。检测参考幻觉通常需要识别推理轨迹中对参考的显式或隐式调用,并判断其是否可验证。
Reconsideration 抑制
在不确定的步骤上,教师模型可能 discourages 验证和修正行为,即“reconsideration 抑制”。思维模型本应能够回溯、验证和修正推理,但教师的监督信号可能压制了这种能力,导致学生模型在应该重新考虑时选择继续向前。
这两种失败模式都削弱了学生模型的独立推理能力,与 OPSD 的初衷背道而驰。
方法:ST-OPSD 如何引导教师模型
ST-OPSD 的核心思路是:只引导教师模型,不引导学生模型。具体而言,它从模型生成的推理轨迹中提取两个方向向量,在蒸馏目标计算时将这些方向应用到教师模型的隐藏状态上,从而抑制参考调用行为,并鼓励 reconsideration。
激活引导与方向提取
研究团队从模型生成的推理轨迹中提取两个方向:一个用于抑制 reference-invoking 行为,另一个用于鼓励 reconsideration。这些方向被施加到教师模型的隐藏状态上,而学生模型本身不被引导。学生从经过引导的教师分布中学习,从而间接获得更合理的监督信号。
激活引导(activation steering) 是一种无需微调模型参数即可控制模型行为的技术。其基本做法是在模型前向传播过程中,向特定层的隐藏状态向量加上一个方向向量(steering vector),从而增强或抑制某种语义属性。方向向量通常通过对比不同行为下的隐藏状态均值(例如正例与负例的差值)来提取,也可借助线性探针或主成分分析获得。由于只干预推理时的激活值,激活引导具有轻量、可解释和可逆的特点,适合在蒸馏过程中对教师模型进行临时性行为修正,而不改变其权重。
Marker-family 校准
ST-OPSD 还引入了 marker-family 校准(marker-family calibration),用于增强 reconsideration 的鼓励效果。具体实现细节在原文中未详细展开,但该方法旨在确保引导信号在不同标记(marker)家族间保持一致和有效。
一个关键设计是:学生模型在学习过程中不被引导。这意味着学生仍然按照自己的策略生成轨迹,而教师模型提供的监督信号经过引导后更加合理。这种非对称设计避免了在推理时对学生模型进行干预,保持了推理的独立性。
实验结果
研究在 AIME 和 HMMT 两个数学推理基准上进行了实验。结果表明,ST-OPSD 相比原始 OPSD 和其他干预方法,在准确率上有所提升,同时将 reconsideration 和参考幻觉率恢复到基础模型水平。
这意味着 ST-OPSD 不仅提高了任务性能,还修复了 OPSD 带来的行为偏差,使学生模型的推理行为更接近未经蒸馏的基础模型。
AIME(American Invitational Mathematics Examination)和 HMMT(Harvard-MIT Mathematics Tournament)是数学推理评测中常用的高难度竞赛基准。AIME 包含 15 道答案为整数的题目,强调代数、几何、数论与组合的综合运用;HMMT 则包含团队赛、个人赛等多种形式,题目难度和风格更多样。两者常被用于评估思维模型在复杂多步推理上的能力,因为它们要求模型不仅给出最终答案,还需保持推理链的连贯性和可验证性,因而也适合观察 reconsideration 和参考幻觉等行为指标。
分析与启示
ST-OPSD 的价值在于它揭示了一个重要问题:蒸馏过程中的教师信号可能被参考条件“污染”,而简单的 token 级监督不足以解决这个问题。通过激活引导直接干预教师的隐藏状态,ST-OPSD 提供了一种轻量级的解决方案,无需修改学生模型架构或推理流程。
这项研究也提示我们,在训练思维模型时,需要关注教师模型的行为质量,而不仅仅是最终的准确率。参考幻觉和 reconsideration 抑制是两种隐蔽但影响深远的失败模式,它们可能在不影响训练损失的情况下悄然降低模型的推理可靠性。
未来的工作可以进一步探索:如何自动化地发现和提取更多有害行为的方向?如何将这种方法推广到更多类型的参考条件任务中?以及,marker-family 校准的具体机制能否被更广泛地应用?
结论
ST-OPSD 通过激活引导改进在线自蒸馏,针对性地解决了参考幻觉和 reconsideration 抑制两大问题。实验表明,该方法在提升准确率的同时,恢复了模型的独立推理行为。这一工作为思维模型的蒸馏训练提供了新的视角和实用工具。
相关推荐
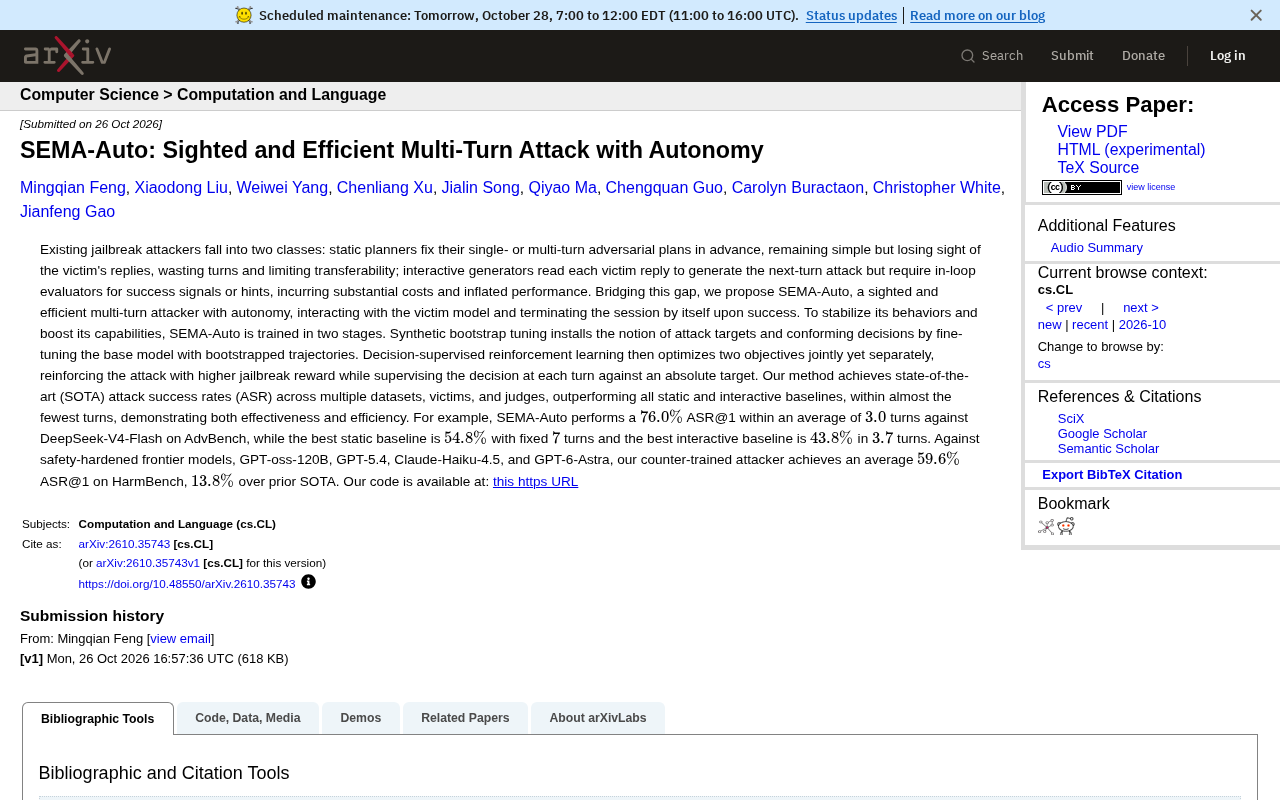
SEMA-Auto:自主多轮越狱攻击效率与成功率双突破
微软提出 SEMA-Auto 自主多轮越狱攻击方法,通过两阶段训练实现自主终止与高效攻击,在 AdvBench 上以 3 回合达 76% 成功率,超越静态与交互式基线。
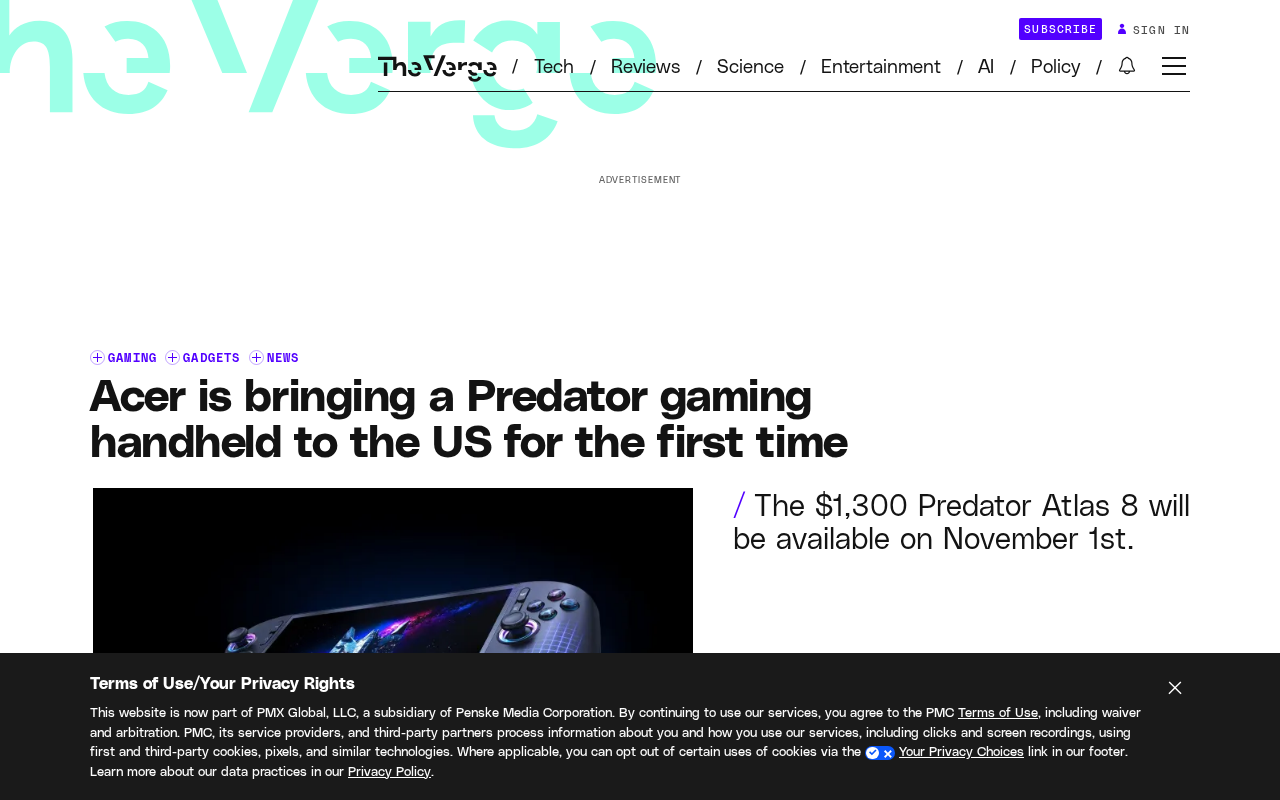
宏碁Predator Atlas 8游戏掌机首次登陆美国,独家首发Best Buy
宏碁Predator Atlas 8游戏掌机首次登陆美国市场,Intel Arc G3 Extreme版本将在Best Buy独家销售。本文梳理型号选择、渠道策略与市场竞争格局。
WorkBuddy怎么用?本地AI智能体安装与工作台搭建指南
WorkBuddy是什么?本文整理B站保姆级教程要点,讲清这款本地AI智能体的完整工作流:从官网下载安装、连接器绑定办公软件,到多智能体并行处理文档与数据分析,并对比Codex说明新手选它的理由。