用领英帖子打造AI分身,靠谱吗?

用领英帖子做知识库型AI分身可行,但需解决过时与信任问题。
文章从Reddit上一则讨论出发,探讨能否把多年积累的领英帖子变成真正有用的AI分身。发帖人关注的不是模仿文风的聊天机器人,而是能引用原始帖子作为依据的“知识库型”助手,这类助手对咨询顾问、教练等靠专业判断吃饭的人更有价值,能提升回复一致性和效率。但文章指出两个核心挑战:一是领英帖子是时间切片,观点会过时,AI不会自动识别废弃内容,需要定期人工审核或让引用附带时间信息;二是信任问题,是否让AI完全代答取决于场景风险,分级授权是折中方案。最后强调数据质量比数量重要、引用机制是信任基础、更新机制需提前规划、边界要事先设定。
从“模仿文风”到“引用原始内容”
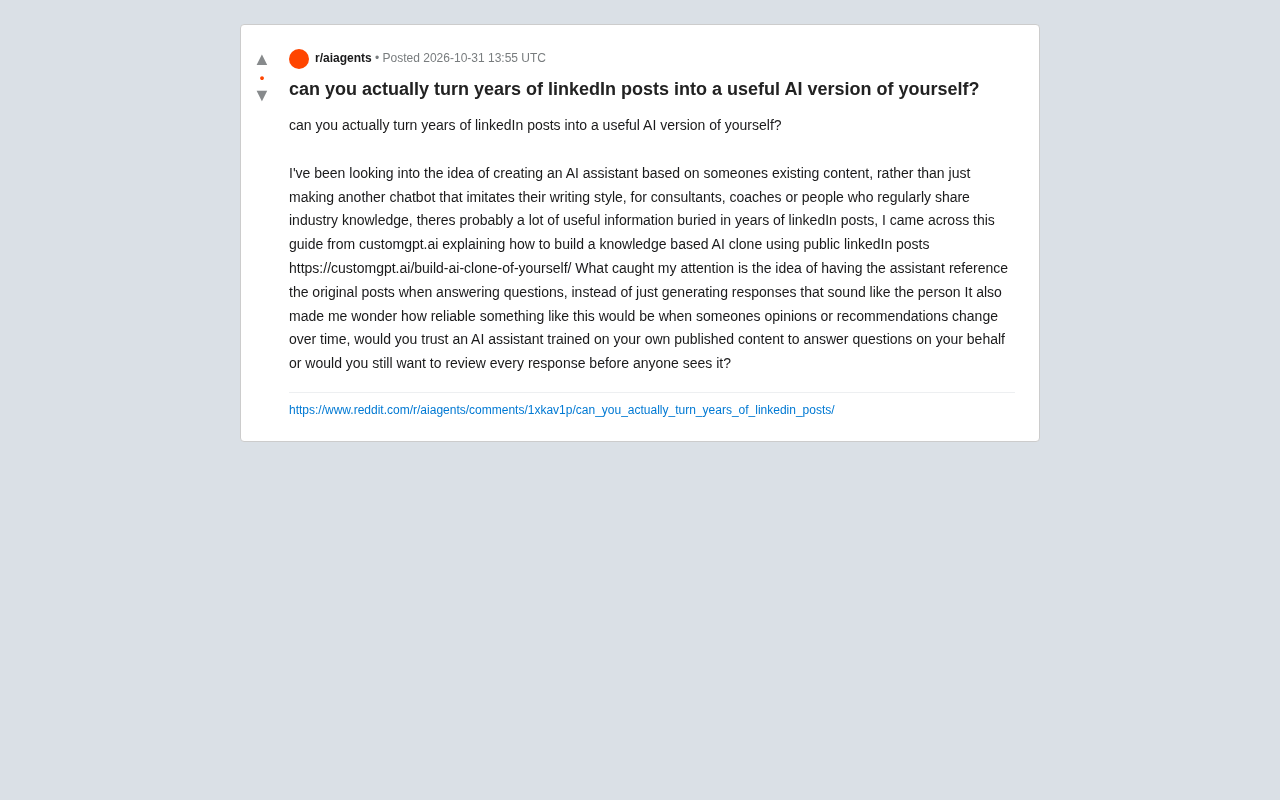
最近在Reddit上看到一个有意思的讨论:能不能把多年积累的领英帖子,变成一个真正有用的AI分身?发帖人并非想做一个只会模仿自己写作风格的聊天机器人,而是希望AI能基于自己公开发布的内容,为咨询顾问、教练或行业知识分享者提供一个“知识库型”的助手。
他提到customgpt.ai的一份指南,教人如何用公开的领英帖子构建AI克隆。真正吸引他的是:这个助手在回答问题时,会引用原始帖子作为依据,而不是凭空生成听起来像本人的回复。
这个思路的转变很关键。大多数“AI分身”停留在风格模仿层面,生成的内容形似而神不似,缺乏可信度。而基于知识库的克隆,试图把每一条帖子当作可追溯的信息源,回答时能指向具体出处,这对需要专业背书的场景更有价值。
CustomGPT.ai 是一个面向企业的无代码 RAG(检索增强生成)平台,用户上传文档、网页或帖子后,平台会自动切分内容、生成向量索引,并在问答时检索相关片段交由大模型组织答案。它的关键设计是“基于检索的回答”,即模型被约束为优先依据索引中的原文作答,并返回来源链接。这与纯微调式的风格克隆不同:微调把内容“压”进模型权重,难以追溯出处;而 RAG 把知识留在外部库中,可随时增删改,天然支持引用原始内容。发帖人引用的那份指南,正是利用这一机制把领英帖子变成可检索的知识源,因此回答能指向具体帖子。
知识库型AI分身的价值在哪里
对于咨询顾问、教练这类靠专业判断吃饭的人来说,多年领英帖子实际上是一份未经整理的个人知识资产。里面有行业观察、方法论、案例点评,甚至是对某些趋势的早期判断。把这些内容结构化后交给AI,理论上可以快速响应常见问题,把重复性咨询解放出来。
更实际的价值在于一致性。人工回复难免有状态起伏,而AI可以稳定地按照既定知识库输出。对于个人品牌而言,这意味着对外沟通的基线质量有了保障。
但这里有个前提:帖子内容本身得足够扎实、成体系。如果多年发帖只是碎片化的感想,那AI能提取的价值也有限。
意见会过时,AI分身怎么跟上
发帖人提出了一个尖锐的问题:当一个人的观点或建议随时间变化时,这样的AI助手还可靠吗?
这确实是知识库型克隆的软肋。领英帖子是时间切片,五年前的建议可能今天已经不适用,但AI不会自动知道哪条该废弃。如果用户提问正好触及这些过时内容,AI可能一本正经地给出旧答案。
解决思路大致有两种:一是定期人工审核和更新知识库,把过时内容标注或移除;二是让AI在引用时附带时间信息,让提问者自行判断时效性。无论哪种,都意味着“建好就扔那不管”是不现实的。
RAG 系统对“知识时效性”本身没有内建判断力。检索环节通常按语义相似度召回片段,并不会因为某条帖子发布已久就自动降低其权重;生成环节也倾向于把召回内容当作事实陈述。因此,时间感知需要在工程层面额外注入,常见做法包括:为每个知识片段附加发布时间、来源等元数据,在提示词中要求模型引用时标注日期,以及在检索时按时间过滤或加权。部分系统还会引入“过期标记”字段,人工审核后把旧内容降权或隔离。理解这一点,就能明白为什么原文强调“更新机制要提前规划”——它并非运营上的锦上添花,而是弥补 RAG 技术短板的必要设计。
信任问题:没人盯着能行吗
讨论的最后,发帖人问:你会信任一个基于自己公开内容训练的AI助手,让它代你回答问题吗?还是仍然希望每条回复都经过人工审核?
这个问题没有标准答案,取决于场景风险。如果是低风险的常见问题解答,比如“你的咨询流程是怎样的”,AI自动回复问题不大。但涉及具体建议、报价或敏感判断时,人工审核几乎是必须的。
一个折中方案是分级授权:AI处理事实性、流程性问题,复杂或高价值问题转交本人。这样既利用了AI的效率,又保留了关键环节的控制权。
从社区讨论的氛围看,多数人对“完全放手”持谨慎态度。毕竟个人品牌的核心是信任,一次不准确的自动回复可能抵消多年积累。
“分级授权”在工程上对应的是置信度阈值与转人工流程。系统可以为每个回答计算一个置信度分数(比如检索片段与问题的相关度、模型自评的确定性),高于阈值时自动回复,低于阈值或命中敏感意图(报价、合同、具体建议)时转交本人。另一种做法是意图分类:把问题预先划分为事实性、流程性、判断性三类,只有前两类走自动通道。无论哪种实现,都需要在部署前明确“转人工”的触发条件和提示语,避免用户误以为在与本人对话。这也是原文说“规则最好在部署前定清楚”的技术含义——它不是一句管理口号,而是需要写进系统逻辑的具体配置。
落地前要想清楚的事
如果你认真考虑用领英帖子做AI分身,有几个实际问题值得先想明白。
数据质量比数量重要。几百条高质量、成体系的帖子,可能比几千条零散感想更有用。整理阶段的工作量往往被低估。
引用机制是信任的基础。能指向原始出处的回答,比流畅但无出处的生成内容更可信。这也是customgpt.ai指南里最值得关注的设计。
更新机制要提前规划。观点会变,行业会变,知识库得有定期维护的流程,否则AI分身会慢慢变成“过去的你”。
最后是边界设定。哪些问题AI可以代答,哪些必须本人处理,这个规则最好在部署前就定清楚,而不是等出了问题再补。
总的来说,用领英帖子打造AI分身技术上可行,也有真实需求支撑,但它更像一个需要持续运营的知识产品,而非一次性的技术玩具。值不值得做,取决于你对效率提升和品牌风险的权衡。
相关推荐

本地模型为何在Doom游戏决策中击败Jev AI API?
YouTube视频对比显示,本地模型GLiNER在Doom游戏中以12毫秒响应和8.8次/秒决策频率,大幅超越Jev AI API的2.5次/秒,得分翻倍。

Screen Studio 4.0 发布:玻璃放大镜、摄像头抠像与文本式剪辑
Screen Studio 4.0 发布,带来玻璃放大镜、文本式剪辑、摄像头抠像等新功能,并提升导出性能。这款 Mac 屏幕录制工具在 Product Hunt 排名第一,致力于简化视频制作流程。

ClawsGO Science:自带云端实验室的AI科研智能体
ClawsGO Science 是 Product Hunt 上线的 AI 科研智能体,自带云端实验室,集成 500+ 工具和 90+ 数据集,可调度 Claude 与 GPT 智能体集群连续运行数天,从提问自动生成带引用的论文。