用LLM读懂68000汇编:复活1993年Amiga游戏的实战经验

开发者用LLM阅读30年前的68000汇编代码,将1993年Amiga游戏成功移植至Godot引擎。
一位开发者将1993年的Amiga游戏移植到现代游戏引擎Godot,核心方法是让大语言模型直接阅读和理解68000汇编代码,重建游戏逻辑。这个任务的难点在于原始源码丢失、老代码与Amiga定制硬件深度耦合,手工逆向极为耗时。LLM在此并非"一键转换"工具,而是充当理解汇编语义的助手——将底层机器指令的意图翻译为可读逻辑,再由人工主导在新平台实现。这一实践的意义超出个人怀旧项目本身:它提示了一条用AI复活遗留代码、保护数字文化遗产的可行路径,同时也揭示了模型在涉及硬件时序等复杂场景下仍需人工校验的局限。
一场跨越三十年的代码考古
1993年,Amiga平台上诞生了无数经典游戏。它们运行在摩托罗拉68000处理器之上,用当时主流的68000汇编语言编写。三十多年过去,这些代码大多沉睡在软盘镜像与二进制文件之中,成为难以辨认的技术遗迹。
近日,一位开发者在Hacker News上分享了他的项目:将自己在1993年编写的Amiga游戏移植到现代游戏引擎Godot上。这个项目之所以引发广泛讨论(获得157个点赞、54条评论),关键并不在于"移植老游戏"这件事——而在于他的移植方法:让大语言模型(LLM)直接阅读并理解68000汇编代码,从而重建游戏逻辑。
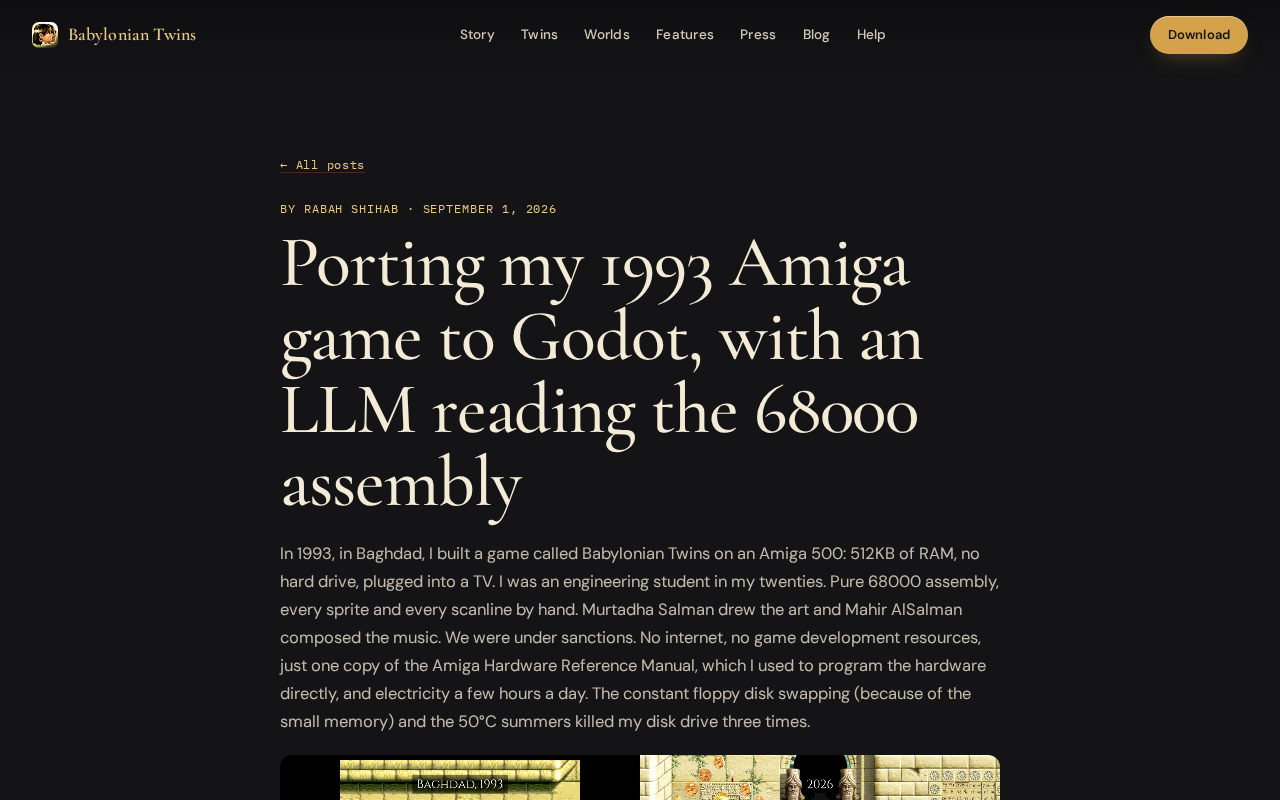
对任何有逆向工程经验的人来说,这都是一个极具想象力的思路。手工阅读汇编代码耗时、枯燥且极易出错,而将其交给AI处理,代表了一种全新的代码理解范式。
为什么68000汇编是块硬骨头
要理解这个项目的价值,先要弄清移植老游戏的真正难点在哪里。
源码丢失与文档缺失
对于三十年前的个人项目,原始高级语言源码往往早已丢失,甚至当年可能就是直接用汇编手写的。开发者手上剩下的,可能只有可运行的二进制文件,或者一堆晦涩的汇编源文件。
68000汇编是一种相对"优雅"的CISC指令集,寄存器命名规整(D0-D7数据寄存器、A0-A7地址寄存器),但即便如此,一段几千行的汇编代码要还原出"这段逻辑到底在做什么",仍然需要在寄存器状态、内存地址、跳转标签之间反复推演。
Amiga硬件的强耦合问题
更棘手的是,Amiga游戏与其独特的定制芯片组(如负责图形的Denise、负责声音和DMA的Agnus/Paula)深度绑定。代码里充斥着对特定硬件寄存器地址的直接读写、精灵(sprite)与位图(bitplane)操作,以及依赖硬件时序的编程技巧。这些内容无法简单"翻译",必须理解其意图,再用Godot的现代API重新实现。
这正是LLM可能发挥价值的地方——它不只是逐行翻译指令,而是尝试理解代码段的高层语义。
LLM读懂汇编代码:为什么可行
将LLM用于汇编代码理解,在近两年逐渐成为逆向工程社区探索的热点方向。它的可行性建立在几个基础之上。
从逐行翻译到语义重建
汇编代码本质上是一种极度形式化的"语言"。现代大模型在训练过程中接触过大量代码,包括各种汇编与反汇编输出。它们不仅能识别指令含义,还能推断出常见的编程模式——比如识别一段代码是循环结构、查表操作、精灵坐标更新,还是碰撞检测逻辑。
作者的做法,正是利用LLM把底层的"机器意图"翻译成人类可读的逻辑描述,再据此在Godot中用GDScript重写。这比人工逐行反推效率高出许多。
人机协作模式而非全自动转换
从项目讨论来看,这并非一个"一键移植"的魔法工具。LLM在这里更像是一个不知疲倦的助手:它负责消化大段汇编、给出解释、提出重构建议,开发者则负责校验、纠错,并把逻辑落地到新引擎中。
这种协作模式恰恰是当前AI辅助编程最务实的形态——AI承担认知负担最重的"理解"环节,人类保留最终的判断与创造权。
这个项目的更大意义
保护数字文化遗产
大量早期游戏和软件正面临永久失传的风险。仿真器(emulator)能让老游戏"跑起来",但无法让它们演进——不能移植到新平台、不能修复bug、不能加入现代特性。而基于LLM的汇编理解,为"真正复活"这些作品提供了一条可行路径:把死代码重新变成活代码。
降低逆向工程门槛
过去,读懂一个陌生平台的汇编需要多年经验积累。如今借助LLM,一个熟悉现代开发但不精通68000的开发者,也有机会切入这类项目。这可能会激发更多的老游戏移植、老软件维护乃至安全研究工作。
对AI代码理解能力的一次检验
值得冷静看待的是,汇编理解对LLM仍然是高难度任务。模型可能"自信地"给出错误解释,尤其在涉及硬件时序、自修改代码或精巧优化技巧时。因此人工验证不可或缺。这个项目的成功,一定程度上也依赖开发者本人对代码的原始记忆与直觉。
给开发者的实用建议
对于想尝试类似工作的开发者,这个案例提供了几点实用参考:
- 分块喂给模型:不要指望一次性丢入整个二进制,把代码按功能模块切分,逐段让LLM解释。
- 保留验证环节:以原始仿真器运行结果为"标准答案",逐步比对移植版本的行为。
- 让LLM解释而非直接生成:先获得高层逻辑理解,再由人主导目标平台的实现,可控性更高。
- 重视硬件语义:对涉及硬件寄存器的操作要格外小心,这是模型最容易"想当然"的部分。
结语
将1993年的Amiga游戏移植到Godot,本身是一个充满怀旧情怀的个人项目;但用LLM去阅读68000汇编,让它超越了怀旧,成为一次关于"AI如何理解遗留代码"的生动实验。
随着大模型代码能力持续增强,我们或许正站在一个转折点上:那些曾经被视为不可维护的"技术黑洞"——老旧汇编、失传源码、无人看懂的遗留系统——正逐渐变得可解读、可迁移、可重生。这不仅关乎游戏,也关乎整个软件行业如何对待自己的历史。
相关推荐
本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。