用LLM审查遗留ColdFusion代码:能否抓住CFML安全漏洞

LLM 可作遗留 CFML 代码安全审查的初筛工具,但需分而治之并辅以人工复核。
遗留 ColdFusion(CFML)代码普遍存在字符串拼接 SQL 和未转义输出等安全隐患,手动审查耗时数周。LLM 辅助审查看似捷径,但 CFML 属小众语言,训练语料少,直接审查整文件效果有限。更可行的定位是将 LLM 作为初筛工具,标记高风险模式(如变量直入查询、用户输入未转义输出),而非替代人工判断。实践中应采取分而治之策略:按数据流追踪分批提问、提供完整上下文(含 Application.cfc 等)、要求模型给出推理链,并对标为安全的高风险文件抽样人工复核。LLM 能压缩排查时间,但团队仍需懂 CFML 安全模型的工程师做最终确认与修复。
遗留CFML代码的安全困境
几乎每一家长期运行的 ColdFusion 技术团队,代码库里都躺着类似的"定时炸弹":一个早在 2000 年代初期写成的 2,000 行 .cfm 页面,用 #url.id# 字符串拼接生成 SQL,把表单字段原样回显进 HTML,没人敢动它。
对这样的代码库做一次完整的手动安全审查,往往要花上数周时间。正因如此,越来越多团队开始把目光投向大语言模型(LLM),希望它能成为一条捷径——用 AI 辅助的代码审查来快速定位 CFML 中的安全隐患。
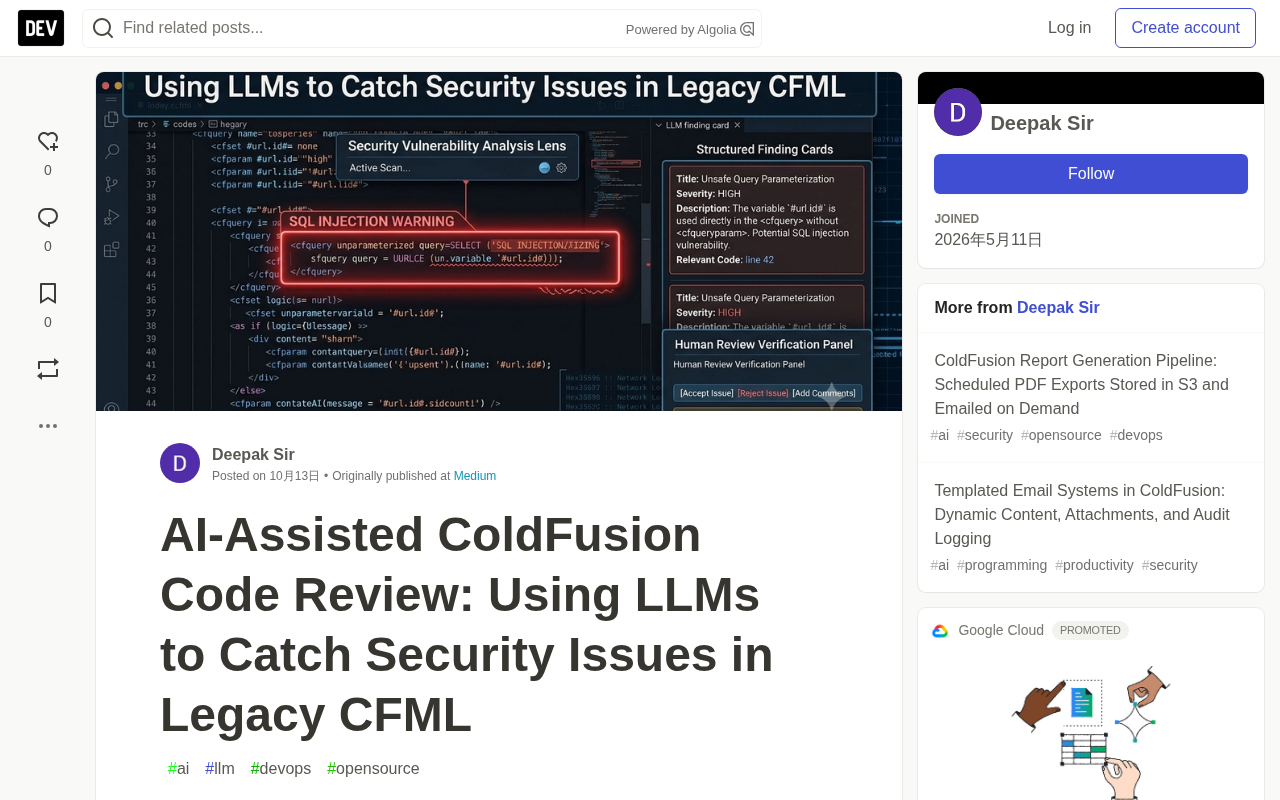
这条捷径真的走得通吗?答案取决于你怎么用。
为什么ColdFusion的安全问题格外棘手
ColdFusion 的历史包袱与其他老牌 Web 技术不同。它诞生于快速建站的年代,语言本身对开发者极度"宽容":<cfquery> 标签允许直接把变量插进 SQL 字符串,<cfoutput> 会把任何内容原样吐给浏览器。这种便利性在当年的开发节奏下是优点,在今天则是 SQL 注入和 XSS 的温床。
更麻烦的是,很多 CFML 代码没有统一的框架约束。同一家公司里,可能同时存在标签式写法、<cfscript> 脚本写法,以及两者混合的"缝合怪"文件。安全审查者不仅要判断漏洞是否存在,还要先理解这段代码到底在做什么——这恰恰是最耗时的部分。
CFML 与 ColdFusion 的关系:ColdFusion 是 Adobe(最初为 Allaire)推出的商业应用服务器,而 CFML(ColdFusion Markup Language)是它使用的编程语言。CFML 采用标签式语法(如 <cfquery>、<cfoutput>)与脚本语法(<cfscript>)混合的设计,语法风格接近 HTML,这降低了入门门槛,也让非科班出身的开发者容易上手。由于 ColdFusion 服务器需要商业授权,其生态规模远小于 PHP、Java 等开源技术,第三方安全工具、静态分析器和公开漏洞样本都相对稀少,这正是 LLM 对其"直觉"较弱的根本原因之一。
LLM在CFML审查中的实际定位
把 LLM 直接丢给一个 2,000 行的文件,让它"找出所有安全问题",效果通常不理想。模型的上下文窗口、对冷门语言的训练语料密度,都会限制它的判断质量。CFML 本身属于小众语言,公开的高质量安全样本远少于 PHP 或 Java,模型对它的"直觉"也更弱。
更现实的做法是把 LLM 当作初筛工具:让它先标记出高风险模式——例如变量直接进入 query 字符串、用户输入未经转义进入输出、文件路径由请求参数拼接等。这些模式识别正是 LLM 擅长的部分,而最终的确认和修复方案,仍然需要懂 ColdFusion 的工程师来判断。
换句话说,LLM 压缩的是"找可疑点"的时间,而不是"做决定"的时间。
上下文窗口与代码审查的关系:上下文窗口指 LLM 单次能处理的 token 总量(通常为数千到数十万 token)。一个 2000 行的 CFML 文件加上相关包含文件,很容易触及窗口上限,导致模型"遗忘"文件开头的内容或遗漏跨文件的变量流向。即便窗口足够大,模型对长上下文中部的信息召回率也会下降,这就是"直接丢整文件"效果差的技术原因。实践中可将文件按功能模块切分,每次只送相关片段,并显式提供跨文件的接口说明,以弥补窗口限制。
分而治之:让LLM审查更可靠
既然整文件丢给模型效果差,就该拆分任务。几个在实践中更可行的策略:
按风险模式分批提问。 不要问"这段代码安全吗",而是问"这段代码中哪些变量来自用户输入,它们最终流向哪里"。把审查拆解成数据流追踪,模型的回答会更聚焦、更可验证。
提供上下文而非孤立片段。 CFML 的变量作用域复杂(variables、request、session、application),孤立看一个函数很容易误判。把相关的包含文件、Application.cfc 配置一并提供给模型,能显著降低假阳性。
要求模型给出推理链。 让模型说明"为什么认为这里是注入点",工程师可以快速验证推理是否成立,而不是盲目相信结论。
人工复核不可省略。 模型漏报的漏洞往往比误报更危险。对 LLM 标记为"安全"的高风险文件,仍应抽样人工检查。
CFML 变量作用域的复杂性:CFML 的作用域分为 variables(当前页面/组件私有)、request(单次请求内共享)、session(单用户会话)、application(全应用共享)、cgi、form、url 等。同名变量在不同作用域中可能指向完全不同的值,且作用域优先级有隐式规则。例如,一个未加作用域前缀的变量可能先查 variables 再查 cgi,这种"隐式查找"容易让审查者误判数据来源。给 LLM 提供 Application.cfc 中的 this 作用域设置和 onRequestStart 逻辑,能帮助它正确追踪用户输入的实际流向,减少假阳性。
遗留代码审查的现实取舍
对于维护遗留 ColdFusion 系统的团队来说,LLM 辅助审查的价值不在于"全自动",而在于把数周的人工排查压缩到数天,并让工程师的注意力集中在真正需要判断的地方。
这也意味着一个前提:团队里必须有人真正懂 CFML 和它的安全模型。如果完全依赖模型输出,很可能既修不好漏洞,又把能跑的代码改坏。LLM 是放大镜,不是替身。
相关推荐
投票权失守之后:美国民主的隐性代价
探讨美国民主党未能通过《约翰·刘易斯投票权促进法案》和《自由投票法案》后,各州限制性投票立法、最高法院削弱《投票权法案》以及党派杰利蝾螈对选民参与和公平代表性的影响。

AI编程Agent最难的不是写代码,而是知道何时该动手
一位开发者分享构建AI编程Agent的经验:最难的不是让模型更聪明,而是让它知道何时直接动手、何时询问确认、何时完全不碰,配合自检沙箱与模型路由实现可控行为。

陶哲轩:AI正将优美数学变成训练废料
陶哲轩批评硅谷用AI强攻数学难题,将优美数学降格为原始训练材料,产生大量缺乏结构美感的证明。本文解析其“有毒废料”比喻背后的数学审美与激励冲突。