用n8n+Vertex AI+Gemini搭建LinkedIn内容自动发布工作流
用 n8n 串起 Vertex AI 与 LinkedIn,打造每日定时、人工一键审批的内容流水线。
文章把 LinkedIn 内容运营拆成研究选题、生成文案、配图、人工审批、自动发布五个环节,用 n8n 编排成一条每天定时运行的工作流。研究节点通过 HTTP Request 调用 Vertex AI 的 Gemini 模型,并挂载 Google Search 工具让选题基于真实搜索结果;第二个 AI 节点以「社交媒体创意策略师」角色做结构化输出,一次生成文案与图像提示词;图像由 nano banana Pro 生成,Base64 结果经 Limit 与 Convert to File 节点解码为二进制。发布前用 Gmail 双邮件机制插入人工审批,通过后再调用 LinkedIn API 发布。作者重点提示了 Service Account 认证、二进制数据传递、binary 显式 fetch 与 Continue on Errors 等实操坑点。
把LinkedIn内容运营拆成「研究选题→生成文案→配图→人工审批→自动发布」五个环节,再用n8n串起来,整套流程可以做到每天定时跑,你只需要在邮箱里点一下「同意」。
整体架构:五个节点串起一条内容流水线
这条工作流的核心思路并不复杂,但节点之间的衔接有不少细节值得拆解。
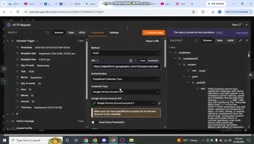
起点是 Schedule Trigger,设置每天固定时间触发(演示中设为早上6点)。接着进入 Vertex AI 研究节点,通过 HTTP Request 调用 Google 的 Gemini 模型,配合 Google Search 工具,让 AI 去搜索引擎里找真实存在的问题。
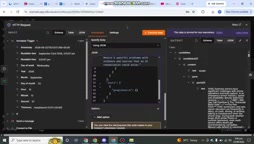
研究结果交给第二个 AI 节点,由它扮演「社交媒体创意策略师」,把问题转化成符合 LinkedIn 调性的帖子,输出结构化内容:钩子(Hook)、解决方案、行动号召(CTA),以及给图像生成模型的视觉提示词和版式说明。
拿到文案后调用 Vertex AI 的图像生成模型(演示中用的是 nano banana Pro)生成配图,Base64 编码的返回结果需要解码并转成文件。最后一环是 Gmail 审批节点——先把图片单独发一封邮件,再发一封带审批按钮的邮件,等你点了「Approve」,才真正调用 LinkedIn API 发布。
Vertex AI 配置:Service Account 是关键
作者在视频里花了相当篇幅讲认证配置,因为这是整条链路最容易卡住的地方。
在 Google Cloud 的控制台里,需要先拿到免费额度(申请后约 $300 credits),然后进入 API 与服务 → Agent Platform,在模型列表里选择要用的 Gemini 模型。点击「查看代码」可以直接拿到调用代码,把它丢给 ChatGPT 格式化一下,就能适配 n8n 的 HTTP Request 节点。
认证走的是 Service Account 路线:创建服务账号后,会得到一份包含邮箱和私钥的文件。在 n8n 里选择「预定义凭证 → Google Cloud API」,填入区域和服务账号邮箱,并设置 scope URL,让服务账号有权访问 Cloud API。
请求头设为 Content-Type: application/json,body 里用 role: user 加 prompt 的结构。作者以 HVAC(暖通空调)行业为例,让 AI 搜索并列出该行业的五个具体痛点。
你可能没注意到,research 节点里专门挂了一个 Google Search 工具,这让模型能拿到搜索引擎的实时结果,而不是仅凭训练数据「编」问题——这是内容选题真实性的保障。
Service Account(服务账号) 是 Google Cloud 中一种用于机器对机器(M2M)认证的身份类型,区别于普通用户账号,它没有密码,而是通过一对密钥(包含一个唯一邮箱地址和一段私钥)来证明身份。在自动化工作流中调用 Vertex AI 这类受保护的 API 时,通常无法使用个人账号做交互式授权,服务账号就成了标准方案:调用方用私钥对请求做签名,Google 验证签名后确认是哪个服务账号在访问,再依据其绑定的 IAM 权限决定是否放行。
Scope(授权范围) 则是 OAuth 2.0 体系里的概念,用来限定一份凭证能访问哪些 API 或读写范围。在 n8n 的「预定义凭证 → Google Cloud API」里填写 scope URL,本质上是告诉 Google:这次拿到的令牌具体想去访问哪些资源(例如 Cloud Platform 的 API)。如果 scope 没配或配错,即便服务账号本身拥有 IAM 权限,请求也会因为「令牌权限不足」被拒。这也是为什么作者说这处最容易卡壳——认证是 IAM 权限与 OAuth scope 双重校验,两个环节缺一不可。
内容生成:结构化输出让下游节点能接住
研究节点的输出直接喂给下一个 AI 节点。这里的 prompt 设计有两个要点。
一是角色设定:system message 中明确「你是社交媒体创意策略师」,并要求帖子必须包含 hook、solution、CTA 三要素。二是强制结构化输出:在 prompt 里要求模型按指定格式返回,这样 n8n 后续节点才能稳定地取出 headline、supporting text、CTA,以及用于图像生成的 visual content 和 layout 字段。
这一步做得好不好,直接决定后面图像节点能不能跑通。如果 AI 返回的是自由文本,下游解析就会失败。作者的做法是让模型同时输出文案和「给图像模型的提示词」,一次调用解决两个需求,减少了工作流的分支。
图像生成:从模型选择到 Base64 解码
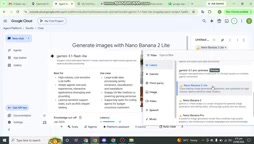
图像生成同样走 Vertex AI。作者的操作路径是:进入 Vertex AI Studio,在模型列表里找到图像生成模型,展开后进入代码区,把语言切到 cURL,复制 URL、headers 和 endpoint,再让 ChatGPT 转成 HTTP Request 节点能用的格式。
演示中选用的是 nano banana Pro。请求体结构是 content → role: user → parts → text,把上一步生成的视觉提示词填进 text 字段。作者提到这里踩过一个坑:引号和空格会导致报错,转成 JSON 后问题才解决。
返回的是 Base64 编码的图片数据,需要经过两个处理步骤:先用 Limit 节点限制为一条(因为返回了两条 item,会导致后续处理出错),再用 Convert to File 节点把 Base64 解码并转成二进制文件。下载验证后,图片里确实包含了文案中的标题、解释性副标题和 CTA 文字。
Base64 是一种把任意二进制数据(例如一张 PNG 或 JPEG 图片)编码成纯文本字符串的方案,它用 64 个可打印字符表示字节内容,让图片能安全地塞进 JSON、HTTP body 这类只接受文本的载体里传输。图像生成模型返回的并不是文件本身,而是一串很长的 Base64 字符串,所以 n8n 接下来必须把它还原成真正的二进制文件才能发邮件或上传到 LinkedIn。
Limit 节点在这里解决的是 item 数量问题:n8n 以「item 数组」的方式在节点之间传递数据,一次 API 调用若返回两条 item,下游像文件转换、LinkedIn 上传这类「期望单一输入」的节点就容易出问题或产生重复。Limit 节点把数据裁剪为一条,保证后续链路拿到的是确定的一份结果。
Convert to File 节点则负责把 Base64 文本解码为二进制(binary)数据,并挂到 item 的 binary 属性上,后续 Gmail 附件和 LinkedIn 的 binary file 上传才能引用它。这也解释了为什么 LinkedIn 发布环节要「显式 fetch 二进制数据」——节点默认不会自动把上游的 binary 属性带上,需要手动把它取出来传给发布节点。
人工审批:Gmail 双邮件机制
全自动发布有风险,所以作者在发布前插入了一道人工关卡。
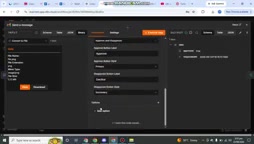
这里用了两个 Gmail 节点。第一个节点负责发送附件——也就是生成的图片,因为 n8n 的 Gmail 审批节点本身没有附件字段,只能拆成两步走。第二个节点用 Send and Wait for Response 操作,response type 设为 approval,提供 Approve / Disapprove 两个选项,邮件发出后会一直等待你的点击。
拿到审批结果后用条件节点判断:如果为 true,走 LinkedIn 发布分支;如果为 false,则回到 research → 生成文案 → 生成图片 → 转文件 → 发邮件 的循环重新来一遍。
这个设计思路很实用:AI 负责批量产出,人只负责最后一道「是/否」的决策,既保留了自动化效率,又避免了未经审核的内容直接发到公开平台。
Send and Wait for Response 是 n8n 中一种「阻塞式」的人工介入节点:工作流执行到这一步会挂起,等到收件人在邮件里点击响应按钮(这里配置为 approval 类型,即 Approve / Disapprove)后,才带着用户的选择继续往下跑。它把邮箱变成了工作流的人机交互界面,非常适合审批、确认这类需要人来拍板的场景。
为什么非要拆成两封邮件?原因是该审批节点本身只负责「展示问题 + 收集选择」,并不提供附件字段,无法在同一封邮件里同时携带图片。于是作者的方案是:第一封用普通 Gmail 节点发送图片附件,让人先看到最终效果;第二封用审批节点发出带按钮的确认邮件。这样审批人拿到的信息是完整的(图 + 选择按钮),而不是对着纯文字盲批。理解这一点,就能明白「双邮件」不是冗余设计,而是被节点能力边界逼出来的合理绕行。
LinkedIn 发布:凭证与二进制的两个坑
审批通过后调用 LinkedIn 节点发布。需要先在 n8n 里连接 LinkedIn 账号凭证,source 选 post,operation 选 create,因为发的是图片,media category 设为 image,输入字段名用 data,对应前面 Convert to File 节点的输出。
作者在演示中提到了两个实操问题。一是 binary file 默认不会上传到 LinkedIn,需要显式 fetch 这行数据让 LinkedIn 节点能访问到。二是在节点设置里需要开启 Continue on Errors,否则一旦某一步报错整个工作流就断了。
解决这两点后,审批通过即可在 LinkedIn 上看到发布的帖子,图文完整。
OAuth 凭证是连接第三方平台(如 LinkedIn)的标准授权方式:你在 n8n 里点击连接账号,走一遍授权页面同意后,平台会下发一个可刷新、可撤销的令牌,n8n 用它代表你发帖,而不必把账号密码写进节点。相比手填 API Key,OAuth 更安全也更符合平台规范,但代价是授权流程较长、scope 需要逐项确认,这也是自动化中仅次于服务账号认证的另一处常见「卡点」。
Continue on Errors 是 n8n 节点级的一个容错开关。默认情况下,任何一步抛错都会终止整条工作流;开启后,即便该节点失败,工作流仍会继续执行后面的节点。作者之所以要在 LinkedIn 发布节点上开启它,是因为发布环节涉及凭证、二进制文件、API 限流等多个不确定因素,一旦中途报错,整条链路断开会导致当天内容彻底作废。开启后至少能让工作流走完剩余步骤,便于排查问题或触发后续补偿逻辑。
这条工作流值得借鉴的地方
抛开具体的 n8n 节点配置,这套方案有三个思路值得迁移到其他场景。
用真实搜索替代模型臆想。 在 research 节点挂载 Google Search 工具,让内容选题基于搜索引擎的实际结果,而不是模型的训练数据。这个做法可以套用到任何需要「找真实痛点」的内容场景。
一次 AI 调用产出文案 + 图像提示词。 强制结构化输出,让一个节点同时服务下游两个分支,减少调用次数和解析复杂度。
人工审批放在发布前而非生成后。 审批邮件里带图片,决策者看到的就是最终效果,而不是半成品。这个位置的选择比审批本身更重要。
整条链路的技术栈不算复杂——n8n 负责编排,Vertex AI 提供 Gemini 文本和图像能力,Gmail 承担人机交互界面,LinkedIn API 完成最终分发。真正的门槛在于 OAuth 认证和二进制数据在节点间的传递,这两处需要多调试几次。
相关推荐
Gemini 4 维护 Chromium:两周完成数月代码量
开发者利用 Gemini 4 Argon 维护 Chromium 代码库,两周完成过去数月工作。AI 代理同时发起 20 个变更,全部通过数十万次测试,突破大型代码库的维护瓶颈。
Codex保姆级攻略:从安装到实战,一期精通AI桌面助手
基于B站热门教程,详解Codex从安装到实战的完整流程:与豆包的本质区别、项目概念、文件整理与仪表板生成两大实战案例,以及计划模式和桌面宠物等特色功能,帮你快速上手这款能直接操作电脑的AI助手。
EduRAG智慧问答系统:黑马AI智能体项目实战解析
黑马EduRAG智慧问答系统实战课程解析:涵盖LangChain、Milvus向量数据库、混合检索与重排序,解决IT领域事实性幻觉,附就业行情与学习路径。