用n8n从Google Sheets抓取数据:AI自动化社媒发布完整教程
用n8n读取Google Sheets内容表,经Filter筛选未发布项后发布并回写状态,形成自动化发布闭环。
文章基于一档孟加拉语教学视频,讲解如何用 n8n 搭建一条由 Google Sheets 驱动的社媒内容发布流水线。整体思路是把表格同时当作内容源和状态机:先用 Google Sheets 节点批量或单行读取发布计划表,再用 Filter 节点按「状态」列为空筛出未发布内容,随后生成配文并把字段映射到下游发布节点,最后通过 Update Row 把状态回写为「已发布」,使工作流可重复运行而不重复发布。文中还提示了凭据授权后列表为空、字段名大小写敏感、更新行匹配错误等常见坑,并分析了该方案在中等内容量场景下的适用性与边界。
本教程讲解如何用 n8n 从 Google Sheets 读取数据,并搭建一条自动化的社媒内容发布流水线。内容基于一档孟加拉语 YouTube 教学视频整理,原视频以「社交媒体自动化」为真实场景,演示了从表格取数、筛选待发布内容,到回写状态标记的完整闭环。
场景设定:用表格驱动社媒发布计划
教程开始先明确了业务目标:为多个目标地区制作社交媒体内容,需要自动化发布「互动型内容」。为此,作者在 Google Sheets 中建立了一张发布计划表,字段包括标题、内容类型、内容、分发渠道(有机流量)等,形成一张待发布内容的「内容日历」。
这张表既是内容源,也是状态机——每一行代表一条待发布的帖子,后续所有自动化节点都围绕它读写。这种「表格即数据库」的做法,对轻量级内容团队来说成本极低,也便于人工随时补充和修改素材。
第一步:从 Google Sheets 拉取多行数据
核心操作是在 n8n 中添加 Google Sheets 节点,选择读取操作。教程演示了两种取数方式:一种是批量读取多行数据,适合一次性拉取整张内容表;另一种是读取单行数据,适合按条件精确获取某一条记录。
节点配置时需要先完成凭据授权,再选择目标表格和工作表。视频中强调了一个容易踩坑的细节:首次进入节点时列表可能为空,需要通过手动点击刷新或重新选择来加载表格与工作表列表;如果目标表是新建的,还需要先在表格端确认工作表名称与节点中显示的一致。
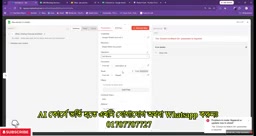
取数完成后,节点会以数组形式返回所有行。教程指出,后续要在执行步骤中预览数据,确认字段名与表格列名完全对应,这是后续筛选和回写不出错的前提。
n8n 的 Google Sheets 节点通过 Google Sheets API v4 与表格通信,因此凭据授权本质上是创建 OAuth2 客户端或使用服务账号,并授予 https://www.googleapis.com/auth/spreadsheets 范围的访问权限。节点中「表格」与「工作表」两个下拉框是级联加载的:选择表格后才会请求该表格下的工作表列表,这也是首次进入节点时列表可能为空的原因——请求尚未完成或凭据尚未生效。若使用服务账号,还需要把目标表格共享给该服务账号的邮箱,否则节点会返回 403 权限错误。理解这层 API 调用关系,有助于在列表加载失败时快速判断是凭据、共享权限还是缓存问题。
第二步:用 Filter 节点筛出未发布内容
拿到全量数据后,并不是每一行都该立刻发布。教程的做法是给表格加一个「状态」列,通过 Filter 节点只保留状态为空的行,也就是尚未发布的帖子。
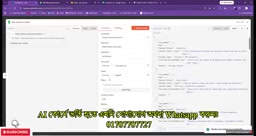
演示过程中出现了一个典型错误:筛选条件里的字段名大小写写错,导致条件不生效、返回结果异常。修正后,节点正确输出了一条未发布记录。这个小插曲说明,Google Sheets 节点返回的字段名区分大小写,配置筛选条件时最好从下拉列表中选择字段,而不是手打。
作者还补充了一个实用设计:如果希望每次只发一条、按顺序逐条推进,可以在节点参数中启用「每次执行只返回一条」之类的选项,让工作流像队列一样一条一条消化内容,而不是一次性全部发出。
Filter 节点是 n8n 内置的条件过滤节点,它接收上游传入的条目数组,逐条评估条件表达式,只把结果为真的条目传递到下游。与 IF 节点不同,Filter 节点不会把数据分成 true/false 两路输出,而是直接丢弃不满足条件的条目,因此更适合「只保留符合条件的数据」这类清洗场景。它的条件支持字符串、数字、日期、布尔和数组等多种类型,并可组合 AND/OR 逻辑。需要注意,Filter 节点对字段的引用基于上游条目的 JSON 结构,字段路径必须与上游输出完全一致;当上游是 Google Sheets 返回的数组时,条件里引用的应是每一行对象的属性名,而非表格的显示列标题。
第三步:生成文案并在后续节点中发布
筛选出的记录会进入内容处理环节。教程提到要为内容生成配文(caption),并把标题、正文、渠道等字段映射到下游发布节点。
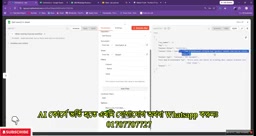
这一步的关键是字段映射要准确:上游表格的列名、Filter 节点输出的字段名、下游发布节点所需的参数名,三者必须对齐。视频中没有深入展开具体的发布平台配置,而是把重点放在「如何把表格数据正确传递到下一个节点」这一通用能力上,因此这套思路可以迁移到任意支持 API 的社媒平台。
第四步:回写状态,形成自动化闭环
发布完成后,工作流需要更新表格,避免同一条内容被重复发布。教程使用 Google Sheets 的更新行(Update Row)操作,把状态列改为「已发布」,其余字段保持不变。
作者特别提醒,更新操作要定位到正确的行,通常用行号或唯一标识来匹配;如果匹配字段选错,可能覆盖掉其他行的数据。完成回写后重新运行整个流程,可以看到之前已发布的行被 Filter 节点自动跳过,工作流进入下一条待发布内容——一个可持续运转的发布队列就此形成。
Update Row 操作依赖一个「匹配列」(Key Column)来定位要更新的行,通常选择行号或某个唯一字段(如 ID、标题)。n8n 会先按该列的值在目标工作表中查找对应行,再写入新值;如果匹配列存在重复值,可能只更新第一条匹配项,甚至覆盖非预期行。因此内容表最好保证每行有一个稳定且唯一的标识。另外,Google Sheets 节点默认只更新显式指定的列,未指定的列保持原值,这一点与「整行覆盖」不同,配置时可以放心只传状态字段。若工作流被并发触发,两个执行可能同时读到同一未发布行并各自回写,建议配合定时触发或加锁机制控制执行频率。
实践建议与适用边界
这套方案的优点是结构简单、可维护性强:内容团队只需维护一张表格,技术侧只需维护一条工作流,双方职责清晰。适合内容量中等、发布节奏固定的场景,比如每日或每周定时发布若干条社媒帖子。
需要注意的边界也很明显。表格作为状态存储,在高并发或多工作流同时读写时容易出现竞争问题;筛选和回写依赖字段名精确匹配,表格结构一改,工作流就可能静默失败。建议在正式使用前加一个错误处理分支,并在每次表格结构调整后做一次端到端测试。原视频为孟加拉语讲解,部分节点细节以屏幕操作为主,若需复现,建议对照 n8n 官方文档确认各节点的最新参数名称。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。