用n8n搭建带记忆的Gemini AI智能体:Postgres全程实战

用n8n + Google Gemini + Postgres,在Docker双容器上搭建具备持久化记忆的AI对话智能体。
本文拆解了一套基于n8n低代码平台的AI智能体搭建方案:以Google Gemini作为对话模型,以Postgres数据库持久化保存聊天历史,整体运行在Docker双容器架构之上——n8n服务与Postgres各自独立部署。方案的核心难点在于打通容器间的数据库连接,需要修改`postgresql.conf`开放监听地址,并在`pg_hba.conf`中添加子网授权规则。测试验证了对话历史确实实时落入`n8n_chat_histories`表,使智能体具备跨轮次的上下文感知能力。教程同时演示了不同Gemini模型版本在时效性问题上的表现差异,提示选型时需关注知识截止时间。该方案适合快速搭建有状态的AI问答机器人,但生产环境还需在安全配置和访问控制上做进一步加固。
为什么要给AI智能体加上「记忆」
大多数人用n8n搭建AI工作流时,往往只做到了「问一句、答一句」的简单对话。但真正的智能体(Agent)需要具备上下文记忆能力——能记住此前的交流内容,才能进行连贯的多轮对话。本文基于一个YouTube教程案例,拆解如何在n8n中集成Google Gemini作为对话模型,并用Postgres数据库持久化保存聊天记录。
整套方案最大的特点在于完全运行在Docker容器之上:n8n的智能体服务跑在一个独立容器中,Postgres数据库则运行在另一个独立容器中。这种解耦架构让部署、迁移和维护都更为清晰,也更贴近生产环境的实际做法。
n8n是一款开源的低代码工作流自动化平台,定位类似Zapier或Make(前身Integromat),但支持自托管部署。它通过可视化节点拼接的方式连接各类API和服务,近年来随着AI节点的引入,逐渐成为搭建轻量级AI智能体的热门选择。Docker则是目前最主流的容器化技术,能将应用及其依赖打包进一个隔离环境(容器)中运行,实现「一次构建、到处运行」。两者结合意味着:整套AI工作流系统可以在任意安装了Docker的机器上一键启动,无需在宿主机上手动安装n8n或Postgres,也不必担心版本冲突。
工作流的整体架构
整个工作流的核心目标很直接:用户在聊天入口发送消息,智能体接收后交由Gemini处理并返回答案,同时将用户与模型之间的对话历史写入Postgres数据库。
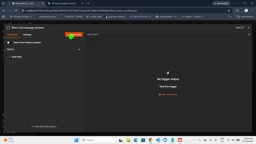
从组件分工来看,这套系统主要由三部分构成:
- Chat Trigger(聊天触发器):作为工作流的入口,接收用户输入的消息;
- AI Agent(智能体节点):核心调度器,负责把消息转交给大模型,并自主决定如何响应;
- Chat Model + Memory(模型与记忆):Gemini负责生成回答,Postgres负责存储上下文。
教程演示时提出的第一个测试问题是「世界上有多少个国家」,模型给出的回答是「这取决于你如何计算,大约195个,其中193个是联合国成员国」——这是一个标准且准确的回答,验证了基础链路的畅通。
配置Gemini模型节点
要让智能体用上Gemini,需要在Chat Model环节选择Google Gemini,并配置对应的API Key。创建流程大致如下:
- 点击AI Agent节点下的Chat Model,向下滚动找到Gemini选项;
- 填入事先在Google AI Studio生成的API密钥;
- 选择具体的模型版本。
教程中特别演示了切换模型的灵活性。当使用较老的模型询问「印度现任反对党领袖是谁」时,模型返回的是基于旧数据的答案(提到2024年的信息);换成更新的Gemini模型后,才给出了更准确的时效性结果。这个细节提醒我们:模型的知识截止时间会直接影响涉及时事类问题的回答质量,选型时需要留意。
Google AI Studio是Google提供的免费在线平台,开发者可以在此申请Gemini系列模型的API Key,并测试不同版本模型的能力。Gemini目前有多个版本在迭代,不同版本在知识截止时间、上下文窗口长度和推理能力上存在差异。「知识截止时间」(Knowledge Cutoff)是指大语言模型训练数据的最后更新时间点,模型对该时间之后发生的事件一无所知,这是当前所有静态训练模型的共同限制。若要获取实时信息,通常需要为智能体额外接入搜索工具(如Google Search API或Tavily)作为补充,仅靠切换模型版本只能缓解但无法根本解决时效性问题。
用Postgres实现持久化记忆
这是整套方案中技术含量最高的部分。在Memory环节选择「Postgres Chat Memory」,然后配置数据库连接凭据——包括数据库名、主机名(Host)、用户名和密码。
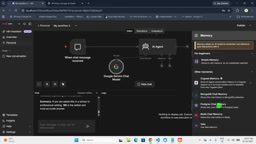
但在连接之前,有一个容易被忽略的关键步骤:需要修改Postgres的配置文件,才能让n8n容器从外部连接到数据库。具体要改动两处:
- 在
postgresql.conf中设置listen_addresses = '*',表示允许任意外部地址访问; - 在
pg_hba.conf中添加对应的子网授权规则。
作者提醒这里设置为全局监听意味着任何人都可能连接到该数据库,生产环境中应当收紧权限范围。完成修改后,通过docker ps可以看到两个容器正在运行——一个是n8n服务,一个是Postgres数据库。此时主机名直接填容器名postgres即可,用户名同样是postgres。
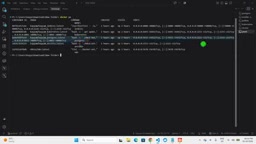
验证记忆是否真正落库
配置完成后,作者进入Postgres查看是否生成了n8n_chat_histories表。随着几轮对话的进行,表中确实记录下了用户与模型之间的交互历史。这意味着智能体不再是「金鱼记忆」,而是能够基于历史对话上下文持续工作。
PostgreSQL(简称Postgres)是一款功能强大的开源关系型数据库,以可靠性和SQL标准兼容性著称。在AI智能体场景中,用数据库而非内存存储对话历史有明显优势:内存中的上下文会随容器重启或进程退出而消失,而写入数据库的记录可以跨会话、跨重启持续保留。postgresql.conf是Postgres的主配置文件,控制服务器级别的运行参数,其中listen_addresses决定数据库监听哪些网络接口;pg_hba.conf(Host-Based Authentication)则是客户端认证规则文件,逐条定义哪些IP、以哪个用户、用何种方式才能连接到数据库。两个文件都需要修改,是因为前者控制「是否接受外部网络请求」,后者控制「谁有权限通过认证」,缺一不可。在Docker网络中,同一compose网络下的容器可以用容器名作为主机名互相访问,这就是为什么Host直接填postgres即可生效。
实测对话效果
搭建完成后,教程进行了一系列真实测试,Gemini的表现如下:
- 「印度有多少个邦」→ 回答28个邦加8个联邦属地;
- 「印度当前GDP是多少」→ 回答约3.?万亿美元规模;
- 「印度反对党领袖是谁」→ 旧模型答Mallikarjun Kharge,新模型补充了Rahul Gandhi等更新信息。
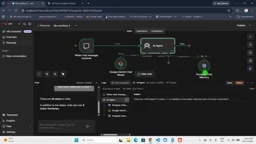
每一轮问答,用户输入与模型输出都会被同步写入Postgres。此外,输出格式也支持灵活调整,可以是纯文本、表格形式,甚至导出为文件,按需求自由切换。
这套方案的价值与局限
这个教程的实用价值在于,它用一套可复现的容器化流程,把「低代码自动化平台 + 大模型 + 持久化记忆」三者打通,适合希望快速搭建带状态AI客服或问答机器人的开发者。Docker化部署也让这套环境具备良好的可移植性。
不过也要清醒看待其局限:教程侧重操作演示,对安全性(如全局监听带来的风险)、性能优化、以及Memory的窗口长度管理只是一笔带过。真正要上生产,还需要在凭据管理、访问控制和模型成本上做更细致的工程化处理。
对于想入门AI工作流自动化的读者,这套Gemini + Postgres + n8n的组合,是理解「有记忆的智能体」如何落地的一个清晰起点。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。