用n8n搭建完美线索引擎:AI线索评分与自动化实战

一个七步 n8n 线索引擎,用 AI 评分加规则兜底,自动化到人工审批为止。
文章拆解了 The Curious Loop 发布的一个 n8n 演示工作流,展示线索引擎应该如何运作。核心问题是线索冷得太快、真假难辨。整个流程分七步:Webhook 统一收口、规范化与校验、AI 打分(配规则兜底)、Switch 按分数分流为 Hot/Warm/Cold/Invalid、构造可推送到任意 CRM 的结构化数据包、生成分级的跟进建议、最后由人工审批后才发送。作者由此提炼出三条可迁移原则:脏数据在入口处理而非出口补救,AI 必须有降级路径,自动化到审批为止。文章强调,把抽象的“线索引擎”拆成七个可独立验证的步骤,是小团队切入销售自动化的务实起点。
线索流失的速度,决定了自动化必须存在
一条新线索进来。Dana 经营一家牙科诊所,想咨询种植牙。几秒钟之内,一个 n8n 工作流完成清洗、校验、意图评分、优先级排序,并准备好下一步动作——全程无人碰键盘。
这是 The Curious Loop 发布在 YouTube 上的一个演示工作流,用来展示线索引擎应该如何运作。它解决的是一个很朴素但很痛的问题:线索冷得太快。一条消息如果一小时没人看,兴趣就淡了;而当成百上千条消息涌进同一个收件箱时,真正的高价值线索和垃圾信息长得一模一样。
作者提出的目标很清晰:每条线索都以完全一致的方式处理,而最好的那条自动浮到顶部。
七步拆解:一个线索引擎的完整骨架
第一步:触发——把所有入口统一收进来
工作流从一个 Webhook 节点开始。网页表单或外部系统把原始数据推过来:姓名、邮箱、电话、留言、来源。
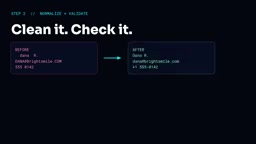
关键是,作者特意强调这些数据是脏的——多余空格、大小写混乱、字段缺失,这才是真实场景的常态。一个好的工作流不会假设数据是干净的,而是把清洗当作必经环节。
Webhook(网络钩子)是一种由事件驱动的反向 API 调用机制:它不是让本系统主动轮询外部服务,而是由外部系统在事件发生时,把一个 HTTP POST 请求推送到预先配置好的 URL 上。在这个工作流里,网页表单、广告平台、聊天工具或第三方系统,只要把线索数据 POST 到那个 Webhook 地址,n8n 就会立刻唤醒工作流并开始执行。相比定时拉取,Webhook 的延迟通常只有几百毫秒,这正是“线索冷得太快”问题所需要的响应速度。它的代价是 URL 必须公开且可访问,因此通常需要配合签名校验、密钥或 IP 白名单来防止伪造请求,否则任何人都能往你的线索引擎里灌垃圾数据。
第二步:规范化与校验——把脏数据挡在评分之前
这里用了 Set 节点加 Code 节点:去空格、邮箱统一转小写、电话号码格式化。随后进入校验环节:邮箱格式是否正确?留言是否为空?
校验不通过的线索会被立即标记为 invalid,永远不会进入评分步骤。这一步的价值常被低估——它保护的不是这个工作流,而是下游的 CRM。脏数据一旦混进客户库,后续的报表、跟进、自动化全部失真。
第三步:AI 评分——让模型给出 0 到 100 分
清洗后的线索被送进语言模型,配上一段明确的提示词,模型返回 0 到 100 的分数以及简短的理由。
牙科线索 Dana 因为咨询种植牙并主动提到了预算,拿到 86 分,直接落入高优先级。
但作者在这里做了一个很多演示工作流会忽略的设计:兜底机制。AI 调用可能超时,也可能返回无法解析的内容。一旦出现这种情况,一套基于规则的评分立即接管——关键词匹配、预算提及、紧急程度,同样能算出一个可用的分数。
这个思路值得展开说。把 AI 放在关键路径上,就必须假设它会失败。n8n 这一类工具的优势正在于,AI 节点和规则节点可以自由组合,让"智能"和"确定性"互为备份,工作流永远不会卡死。
这里的“提示词”指的是一段发送给语言模型的指令文本,用来约束它的任务、输出格式和判断标准。在生产工作流里,评分提示词通常会写清三件事:角色(你是一个销售线索评估员)、维度(购买意图、预算明确度、紧急程度、信息完整度)、以及输出结构(例如返回 JSON,包含 score 和 reason 两个字段)。约束输出结构尤其关键,因为后续节点需要程序化地读取分数并做区间判断;如果模型自由发挥写一段散文,解析就会失败。这也是为什么作者要设计兜底机制——模型可能超时、限流,或返回一段无法被 JSON 解析的文本,任何一处失手都会让整条流水线停摆。把提示词写成“可解析优先”而非“文采优先”,是 AI 评分能否稳定落地的分水岭。
第四步:路由——用 Switch 节点分成四条道
评分出来后,Switch 节点按分数区间把线索分流:
- Hot:高意图,立刻行动
- Warm:有兴趣,当天跟进
- Cold:低意图,慢慢培育
- Invalid:数据有问题,记录后搁置
Dana 进入 Hot 通道。分流的本质是把"处理方式"和"线索质量"绑定起来——不同质量的线索不该占用同样的人力。
Switch 节点是 n8n 中的条件分支组件,它接收一个输入值,按预设规则把它导向多个输出端口之一。与只支持真假两路的 IF 节点不同,Switch 可以配置任意数量的分支,很适合把连续的评分映射成离散的客户等级。实现方式通常是给每个分支设一个数值区间:86 分落入 Hot,60 到 85 落入 Warm,低于 60 落入 Cold,而校验未通过的记录则被贴上 invalid 标签单独走一路。这种“分数区间到处理策略”的映射,本质上是把运营规则从人的脑子里搬进了工作流配置里,让每条线索的去向都可复现、可审计。当业务方想调整阈值时,只需改一个数字,不必重新培训整个销售团队。
第五步:构造 CRM 就绪的数据包
这一步把干净姓名、规范联系方式、分数、分类、评分理由、来源、编号以及时间戳,打包成一个结构化 JSON 对象。
它可以直接通过 API 推送到任意 CRM、表格或数据库。结构化的意义在于可移植:换一套 CRM,工作流主体不用重写。
第六步:生成跟进建议
根据分类,工作流起草下一步动作建议:
- Hot 线索:一小时内人工回复,附上一段提到种植牙的短草稿
- Warm 线索:友好的邮件序列
- Cold 线索:每月一封资讯邮件
注意这里的措辞是"建议"而不是"执行",这直接引向最后一步。
第七步:人工审批——整个设计里最重要的环节
工作流不会自行发送任何东西。它把草稿推给你,附带批准和编辑两个选项。
AI 负责准备工作,人负责做决定。 作者明确表示这是他在整个流程中最看重的部分。这个判断很务实:在客户沟通这种高敏感场景里,全自动发送的风险远大于节省的那点时间。保留一个审批关卡,既拿到了 AI 的效率,又守住了品牌和关系的安全边界。
Human-in-the-loop(人在回路)是指在自动化流程中显式设置一个人工确认节点,让系统暂停等待人的判断后再继续。n8n 里可以通过等待节点、审批表单或与 Slack、邮件等渠道联动来实现:工作流生成草稿后挂起,把内容推给负责人,负责人选择批准或编辑,工作流的执行才被恢复。这个模式的价值在于把自动化的收益与风险分开处理——清洗、评分、起草这些高频、低风险的环节全自动,而对外发送这种不可逆、高敏感的动作保留人工闸门。它也天然形成了审计轨迹:谁在什么时间批准了哪条消息,都有记录可查。对于医疗、金融等受监管行业,这种可追溯性往往不是可选项,而是合规要求。
这个工作流真正值得借鉴的三个设计原则
看完整个拆解,抛开具体的节点配置,有三条原则可以迁移到几乎任何线索自动化项目里:
第一,脏数据在入口处理,而不是在出口补救。 校验前置、失败即标记,让数据质量问题在进入 CRM 之前就被隔离。
第二,AI 必须有降级路径。 语言模型超时或返回异常时,规则评分顶上。这不是过度设计,而是把 AI 用在生产环境的基本要求。
第三,自动化到审批为止。 让机器做它擅长的——清洗、评分、起草;让人做只有人能做的——判断和发送。这条边界划在哪里,取决于业务的风险承受度,但完全不设边界通常不是好选择。
作者在视频结尾提到他承接定制自动化项目,涵盖 n8n、Python、API 和 AI 自动化。这个演示工作流本身的价值在于,它把一个抽象的概念——"线索引擎"——拆成了七个可以单独验证的步骤,每个步骤都能替换、扩展或独立部署。
对于正在考虑给销售流程加自动化的小团队来说,这是一个不错的起点:先从触发和校验做起,跑通数据流,再逐步把 AI 评分和路由接上去。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。