用n8n搭建支持语音消息的WhatsApp AI订单助手实战教程
用n8n搭建能同时处理WhatsApp文字与语音消息的AI客服Agent,核心是Switch分流加Groq转录。
本文详细介绍了如何在n8n自动化平台上,从零搭建一个既能处理文字、又能解析语音消息的WhatsApp AI Agent。流程分两大阶段:先通过Meta开发者平台获取凭证、配置触发器和发送节点,接入挂载了Groq大模型与Simple Memory的AI Agent,跑通文字对话基础能力;再用Switch节点在触发器后对消息类型进行分流,语音消息走"Download Media → HTTP请求调用Groq Whisper转录"的独立分支,将音频转为文本后再送入Agent回答。教程保留了大量真实报错场景,重点揭示了Bearer Token格式错误、Groq与Meta Token混用、Meta Access Token过期等常见陷阱。最终机器人成功识别并回答了语音提问,验证了完整链路的可行性,并预留了连接Google Sheet实现业务定制的扩展空间。
为什么要让WhatsApp机器人听懂语音
做WhatsApp自动化客服时,一个被频繁追问的问题是:如果客户不是用文字下单,而是发语音消息,机器人该怎么处理?多数新手搭建的聊天机器人只能读取文本,一旦遇到语音订单就彻底失灵。这篇教程来自一位专注n8n自动化的内容创作者,核心目标就是补上这块短板——让搭建在n8n上的AI Agent既能回复文字,也能听懂并解析Meta(WhatsApp)通道里收到的语音消息。
作者在视频里反复强调一个商业逻辑:你给客户的便利越多,服务成交的概率就越高。客户发语音是很自然的行为,机器人必须适配,而不是要求客户迁就系统。这也是把一个“简单聊天机器人”升级为“进阶Agent”的分水岭。
从零开始:先跑通文字版聊天机器人
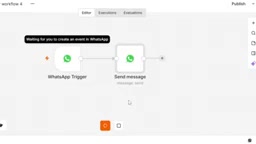
整个流程是从一个全新的空白工作流开始搭建的。第一步是接入WhatsApp。在n8n里新建节点,搜索WhatsApp,选择 On Message 触发器(Trigger),这个节点负责监听Meta传来的所有消息。
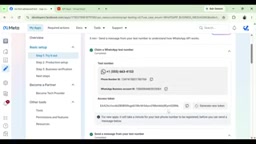
触发器需要填入 Client ID 和 Client Secret,而这两个凭证只能从一个地方获取——Facebook Meta开发者平台(facebook.com/developers)。作者演示了完整的建应用流程:登录后进入 My Apps,点击 Create App,填写应用名称、关联业务组合(Business Portfolio),一路 Next 到提交。应用创建完成后,在 App Settings → Basic 页面即可复制 App ID(对应Client ID)和 App Secret。
这里有一个容易被忽略的坑:Meta 要求必须填写 隐私政策 URL。作者建议用在线的 Privacy Policy Generator 快速生成一份隐私政策链接,填入虚拟信息即可生成,粘贴回Meta设置页后保存。少了这一步,后续流程无法正常跑通。
凭证配置完成后,再新建一个 WhatsApp Business Cloud → Send Message 节点,填入测试号码和接收号码(Recipient Number),用一句简单的"Hi"做发送测试,验证触发器与发送节点是否正确连通。
接入AI Agent:模型、记忆与对话能力
要让机器人真正“像人一样聊天”,需要在触发器和发送节点之间插入 AI Agent 节点。作者的做法是点击加号,选择 AI → AI Agent,然后把触发器输出里的消息文本(Body中的text字段)拖拽映射到Agent的输入。
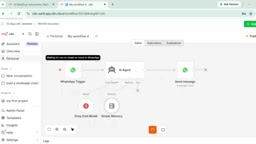
Agent需要挂载三样东西:
- 聊天模型(Chat Model):作者选用免费的 Groq 模型,具体用的是 GPT-OSS 120B,并称其为“最可靠”的选项。API Key 从 Groq 官网控制台(console.groq.com)申请。
- 记忆(Memory):使用 Simple Memory,配置上下文窗口长度。有了记忆,机器人才能记住此前的对话——作者测试时连续打招呼,机器人能识别出"你早上已经问候过了"。
- 工具(Tools):为后续扩展(如连接Google Sheet读写订单)预留。
配置完成后再测试"Hello",机器人返回了拟人化的问候,文字版聊天机器人至此跑通。作者特别提醒:测试阶段节点需要反复 Execute,而要让机器人在真实WhatsApp上稳定响应,必须对应用做 Publish/发布 操作,否则不会正常回复。
Groq 是一家专注于 AI 推理加速的芯片与云服务公司,其自研的 LPU(Language Processing Unit)架构在推理速度上显著快于传统 GPU 方案。对开发者而言,Groq 提供了一套兼容 OpenAI 接口格式的 API,可以直接调用 Meta 的 LLaMA、Mixtral 等开源大模型,且目前有较慷慨的免费额度。教程中提到的 GPT-OSS 120B 实际上指的是在 Groq 平台上托管的某个开源模型(名称可能因版本更新而变化),并非 OpenAI 的 GPT 系列。开发者在 console.groq.com 注册后,进入 API Keys 页面即可一键生成密钥,无需信用卡验证即可开始调用,这也是作者将其作为入门首选的主要原因。
核心升级:用Switch节点分流语音与文字
这是本教程最有价值的部分。当作者直接给机器人发语音问"告诉我Imran Khan是谁"时,触发器虽然激活了,机器人却毫无反应——因为Agent只能处理文本,语音消息根本没被解析。
解决思路是在触发器后插入 Switch 节点,把文本消息和语音消息分流到不同处理路径:
- 新建两条输出规则,分别命名为 text 和 voice。
- text 规则:判断消息 body 中是否 exist(存在)文本字段,存在则走向 AI Agent 直接回复。
- voice 规则:判断是否存在 audio 字段(取其 ID),存在则走向语音处理分支。
语音分支的处理链条更长:
- WhatsApp Business Cloud → Download Media:根据语音消息的 audio ID 把语音文件下载下来。
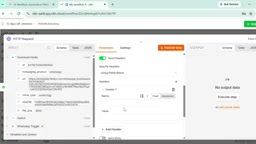
- HTTP Request 节点:这是实现语音转文字(STT)的关键。作者没有使用付费的OpenAI,而是继续走 Groq 的 API 做转录。请求配置要点为:Method 用 POST,填入Groq的转录接口URL,Authentication选 Header Auth,Header 字段名设为 authorization,值为
Bearer加上你的 Groq API Key(注意Bearer后要有空格)。 - Body:content type 选 form-data,加入 model 参数(填模型名),以及 binary file 字段,file 字段的 input data field name 对应前一步下载的文件。
语音转文字(Speech-to-Text,STT)是将音频内容自动转换为可供程序处理的文本的技术。Groq 提供的转录 API 基于 OpenAI 开源的 Whisper 模型,该模型在多语言识别和口音适应性方面表现优秀,且 Groq 的 LPU 架构使其转录速度极快,通常在几百毫秒内完成。调用方式与标准的 Whisper API 完全兼容——向 https://api.groq.com/openai/v1/audio/transcriptions 发送一个 multipart/form-data 格式的 POST 请求,携带音频文件和模型名称(如 whisper-large-v3)即可获得 JSON 格式的转录文本。这也解释了为什么 HTTP Request 节点的 Body 要设为 form-data 而非普通 JSON:音频是二进制文件,必须用 multipart 方式上传,不能序列化为 JSON 字符串。
踩坑复盘:凭证与Token是最大障碍
作者在实操中反复遇到 please check your credential 的报错,这段试错过程恰恰是教程的价值所在。几个关键教训:
- Bearer格式:Authorization头必须写成
Bearer+ token,且中间有空格,漏掉会直接失败。 - Token来源别搞混:语音转录用的HTTP请求节点,需要的是 Groq控制台的API Key,而不是Facebook Meta那套Token。作者一度把Meta的Token填进去导致持续报错,纠正后才跑通。
- Facebook凭证会过期:Meta的Access Token容易失效,需要在Meta后台重新 Generate Token 并替换。作者在流程后段还遇到 WhatsApp API 额度用满的问题,重新复制 Business ID 和 Access Token 替换后恢复正常。
还有一个“隐藏彩蛋”:作者提到AI Agent节点需要在 Memory 里粘贴一段特定的 JSON 结构(Body Entry Changes Value Context),否则整个工作流会卡住跑不动。同时要确保Agent接收的输入是纯文本格式的JSON。
Meta(Facebook)的 WhatsApp Business API 采用短期 Access Token 机制,测试环境下默认生成的 Token 有效期仅约 24 小时,这与 Groq 等平台的长期 API Key 体验截然不同。在正式生产环境中,开发者通常需要申请 永久 Page Access Token 或通过 System User 生成不过期的 Token,流程相对繁琐。此外,Meta 开发者应用在未正式审核上线前处于"开发模式",只有应用管理员账号和已添加的测试用户才能正常收发消息,这也是作者强调要做 Publish 操作的背景——未发布时普通用户的消息不会触发 Webhook,导致自动化流程看似失灵。
最终效果与扩展方向
全部配置完成后,作者发了一条语音消息"Who is Imran Khan",机器人成功解析语音并返回了完整回答——识别出Imran Khan是巴基斯坦知名公众人物、前板球运动员和政治家。这证明语音消息被正确下载、转录并送入了Agent。
到这一步,一个能同时处理文字和语音的WhatsApp AI Agent就搭建完成了。作者给出的扩展方向是:在 Tools 中连接 Google Sheet,就能针对任意业务场景(朋友式陪聊、客服、求职等)定制客户下单与数据记录流程。
整个教程的调性非常务实——作者坦言过程中故意保留了大量报错和试错环节,目的是让观众提前见识这些坑,真正遇到时知道怎么解。这比那种一气呵成、看似完美的教程更贴近真实搭建体验。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。