用n8n打造AI下一步最佳行动引擎:精准推荐加购、交叉销售与留存
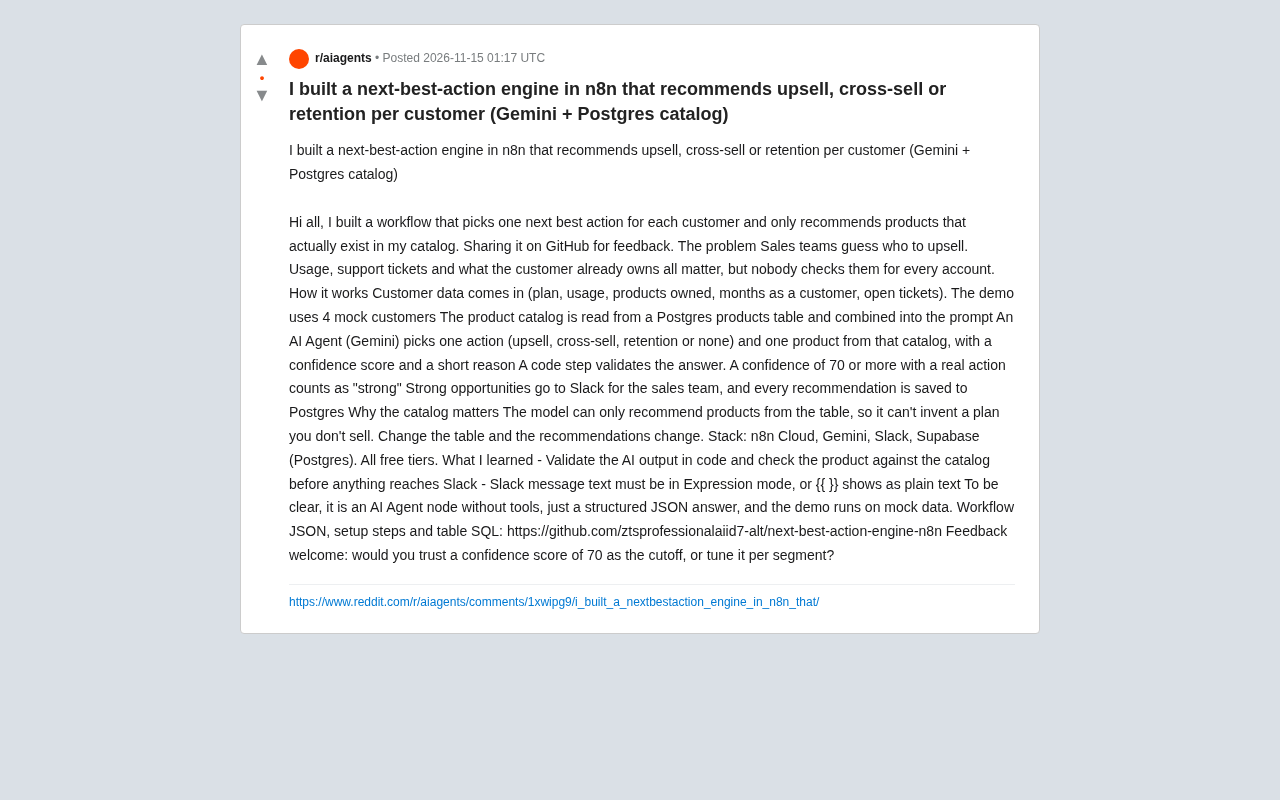
Reddit用户用n8n搭建AI销售推荐引擎,以产品目录硬约束抑制幻觉。
一位Reddit用户用n8n搭建了「下一步最佳行动」引擎,聚合客户用量、工单、已购产品等信号,交由Gemini输出单一动作与产品。核心设计是将Postgres中的产品目录注入提示词,使模型只能从真实产品中选择,从结构上抑制幻觉;代码层再二次校验产品是否存在,置信度70以上的强机会推送Slack,全部结果落库。整套技术栈使用n8n Cloud、Gemini、Slack、Supabase免费额度,演示基于4个模拟客户。作者还提出置信度阈值是否应按客户分群调优的开放问题,建议先用真实转化数据校准。
销售团队常常凭直觉决定该向谁推荐升级、该向谁交叉销售,但每个客户的用量、支持工单、已购产品这些关键信号,很少有人能逐个账户去核对。一位Reddit用户用n8n搭建了一个「下一步最佳行动」(Next Best Action)引擎,让AI为每个客户只推荐一个动作,并且保证推荐的产品真实存在于产品目录中。项目已开源在GitHub,本文拆解其设计思路与值得借鉴的工程细节。
问题:销售推荐的三个盲区
传统的加购与交叉销售推荐往往依赖销售代表的经验判断。素材作者指出,客户的用量数据、支持工单情况以及已购产品组合都会影响推荐质量,但现实中没有人会为每一个账户逐一检查这些维度。这导致两个后果:一是高潜力的升级机会被漏掉,二是推荐了客户根本不需要或公司并不销售的产品。
这个工作流的切入点很务实——不追求复杂的推荐算法,而是把分散的客户信号聚合起来,交给大模型做结构化判断,再用代码层做校验兜底。
工作流拆解:从客户数据到Slack通知
整个流程可以分成四个阶段。
数据输入:客户数据包含套餐类型、用量、已购产品、客户月龄、未关闭工单等字段。演示版本使用了4个模拟客户,方便快速验证逻辑。
目录注入:产品目录从Postgres的products表读取,并被组合进提示词中。这是整个设计中最关键的一环——模型只能从这张表里挑选产品,因此不可能编造出公司并不销售的套餐。作者强调,只要改动这张表,推荐结果就会随之变化。
AI决策:由Gemini驱动的AI Agent节点输出一个结构化JSON答案,包含动作类型(upsell、cross-sell、retention或none)、具体产品、置信度分数以及简短理由。需要注意的是,这里用的是不带工具的Agent节点,本质上是让模型返回固定结构的JSON,而非让模型自主调用外部工具。
校验与分发:一个代码步骤负责验证AI答案,检查推荐产品是否真实存在于目录中。置信度达到70及以上、且动作不是none的,被视为「强机会」推送到Slack供销售团队跟进;同时所有推荐结果都会写回Postgres留档。
为什么产品目录约束比提示词技巧更重要
很多人做LLM应用时把精力花在提示词打磨上,这个项目提供了一个不同的思路:用外部数据源作为硬约束。
当模型被限定只能从Postgres表中选择产品时,幻觉的出口被大幅收窄。即便模型对某个客户的理解有偏差,它输出的产品名至少是真实可售的。这种「目录即白名单」的做法,比在提示词里反复强调「不要编造产品」要可靠得多,因为前者是结构性约束,后者只是软性请求。
作者在代码层还做了二次校验,等于在模型输出和业务系统之间加了一道闸门。这个模式值得所有需要AI输出落地到业务动作的场景借鉴:模型负责判断,代码负责守门。
LLM 幻觉指模型生成看似合理但事实上不存在或错误的内容,在产品推荐场景中表现为编造不存在的套餐或服务。常见的缓解手段包括提示词强调、few-shot 示例、输出后处理等,但这些都属于软性约束,模型仍可能越界。而「目录即白名单」是一种结构性约束:将可选产品列表作为外部知识注入提示词,并在代码层验证输出是否属于该列表,相当于在模型与业务系统之间建立一道硬性闸门,从机制上杜绝了编造型产品流入下游。
免费技术栈与两个实战教训
项目使用的全部是免费额度:n8n Cloud、Gemini、Slack、Supabase(Postgres)。对于想验证想法的个人开发者或小团队,这套组合的启动成本几乎为零。
作者分享了两条踩坑经验。第一,必须在代码中验证AI输出,并在消息进入Slack之前核对产品是否在目录中——这正是前面提到的守门逻辑。第二,Slack消息文本必须使用Expression模式,否则{{ }}会作为纯文本原样显示,而不是被解析为变量。这类细节看似琐碎,却是工作流能否真正跑通的关键。
n8n 是一款开源的工作流自动化工具,支持可视化编排节点、集成数百种服务,并提供云端免费额度,适合快速搭建 AI 原型。Supabase 是基于 Postgres 的开源后端即服务(BaaS),提供数据库、认证、存储等功能,其免费层可用于小型项目验证。Gemini 是 Google 的大语言模型系列,通过 API 提供免费调用额度。Slack 则是团队协作与通知平台,常被用于接收自动化告警或业务提醒。这套组合的共同特点是上手快、零成本启动,非常适合个人开发者或小团队做概念验证。
置信度阈值该固定还是分群调优?
作者在帖子末尾抛出了一个开放问题:置信度70作为强机会的切分线是否可信,还是应该按客户分群分别调优?
这个问题触及了AI辅助销售的核心矛盾。固定阈值实现简单、行为可预期,但不同客户群体的决策难度差异很大——大客户的一个升级动作涉及金额更高,理应要求更高的置信度;而长尾客户的动作风险较低,阈值可以适当放宽。另一方面,分群调优需要足够的历史数据来校准,在冷启动阶段反而可能引入噪声。
从工程角度看,更稳妥的路径是先把阈值和推荐结果一起落库,积累一段时间后回看「强机会」的实际转化情况,用真实反馈来校准阈值,而不是一开始就设计复杂的动态规则。
局限与适用边界
需要明确的是,这个项目目前是演示性质:运行在模拟数据上,AI Agent不带工具,输出是单轮结构化JSON。它能证明流程可行,但距离生产可用还有距离——真实场景下的客户数据清洗、推荐结果的A/B验证、销售团队的反馈闭环,都需要额外建设。
不过作为一个可复用的骨架,它的价值在于把「数据聚合—模型判断—代码校验—人工跟进」这条链路跑通了,并且用产品目录约束解决了LLM落地中最头疼的幻觉问题。对于正在探索AI如何嵌入销售流程的团队,这是一个成本极低的起点。
背景补充
AI Agent 节点是 n8n 中专门用于集成大语言模型的组件,它支持绑定工具、记忆等能力,但本工作流使用的是「不带工具的 Agent 节点」——本质上是一个遵循系统提示词、返回 JSON 的结构化输出节点。这种做法在工程上更可控:模型不需要自主决策调用哪个外部 API,只需基于注入的上下文生成固定格式的答案,便于后续代码校验和流程编排。
相关推荐

AI时代为何必须掌握Git:从版本控制到Agent协作
Git和GitHub有什么区别?AI Agent写代码后如何用Issue、分支和Pull Request管理改动?本文基于NetworkChuck的Git教程,梳理从git init到冲突处理的完整流程,并分析AI时代版本控制为何成为必备技能。
OpenAI 6.2 Astra实测翻车:跑分惊艳,为何开发者却说难用?
OpenAI 6.2 Astra 跑分全面领先且价格更低,但早期测试者反馈其在长任务中频繁卡死、输出难以解析、资源管理失控。本文梳理实测中的真实体验与官方数据之间的落差,并分析这对开发者选型的意义。
GTA VI咖啡系统细节曝光:热咖啡竟能泼人?
Vergecast播客揭秘GTA VI咖啡系统:玩家可在公寓冲泡、自动贩卖机购买、餐厅点单,甚至将热咖啡泼向他人。这种对日常交互的细致还原延续了荒野大镖客2的沉浸感设计,引发对游戏细节与玩法平衡的讨论。