用n8n和AI自动发布Drupal博客:完整实战教程
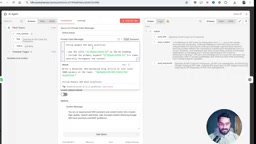
用n8n串联OpenAI与Drupal API,实现从选题到发布的全自动博客生产流水线。
本文介绍了一位技术创作者使用n8n构建的自动化内容生产工作流。该工作流从Google Sheets读取选题,通过OpenAI Agent生成3000字文章和配图,再经Drupal的REST API自动上传图片并发布文章。文章详细拆解了五个环节:选题管理(用status字段避免重复)、AI写作(系统提示词承载SEO规则)、配图生成与处理(resize和binary模式)、Drupal侧的三层权限配置(密钥对、consumer scope、REST UI方法级开关),以及发布时的JSON结构。最后给出了生产环境加固建议,包括增加reviewer agent和人工审批节点。
在内容运营中,从选题研究、配图生成到字段填写,一篇博客的诞生往往要耗费大量重复劳动。一位技术创作者在YouTube上演示了如何用n8n串联OpenAI与Drupal API,把整套流程压缩成一次工作流执行——从Excel选题表拉取待写主题,由AI生成3000字文章和配图,再通过Drupal的REST API自动完成图片上传与文章发布。
整体架构:一条工作流打通五个环节
这条自动化流水线的逻辑并不复杂,但每一步都踩在内容生产的痛点上。工作流从Google Sheets读取选题,交给AI Agent撰写正文,再调用图像生成接口产出配图,最后通过Drupal的内容与文件API把文章和图片一并推送上线。
创作者特别强调,这套流程并非只能用于Drupal。他在前一期视频中已经用同样的思路对接过WordPress,核心差异只在于发布环节的API结构。对熟悉n8n的人来说,更换目标CMS只需要替换末尾几个HTTP节点。
选题从哪来:Excel还是RSS
内容源有两种取法。第一种是维护一张Excel选题表,每行一个主题,配合status字段追踪发布状态;第二种是接入RSS节点,从资讯站点动态抓取热点话题。
演示中选择了Excel方案。原因很实际:RSS虽然能保证内容新鲜,但选题质量不可控,容易出现随机生成的题目。创作者的原话是,若想“i apni marzi ka article”而非随机内容,用表格预置选题更稳妥。
工作流通过status字段过滤出第一条pending记录,并设置“仅返回首行”的条件,确保每次执行只处理一篇文章。文章发布成功后,更新节点会把该行的status改为done,同时回写行号,这样下轮执行就会自动跳到下一个待办选题,避免重复发布。
AI写作:系统提示词才是质量关键
写作节点使用OpenAI Agent,但真正决定产出的不是模型大小,而是提示词的分层设计。创作者明确区分了用户提示词和系统提示词:前者描述当前任务,后者承载所有SEO规则、内容规范与Drupal编码标准。
“所有instructions、rules和best practices都应该放在系统提示词里,而不是任务提示词里。”
演示中把“至少3000字”的要求和“遵循Google最新搜索最佳实践”的指令写进了任务提示,而结构化的输出格式则通过Output Parser节点约束为JSON,字段包括title、content和keywords。想扩展字段,比如加tags或short description,只要在解析器里多定义一项,模型就会自动填充。
Output Parser与结构化输出
Output Parser是n8n中用于约束AI模型输出格式的节点,它要求模型返回符合指定JSON Schema的数据。在本工作流中,解析器定义了title、content和keywords三个字段,模型会严格按照该结构生成内容。这种做法的好处是后续节点可以直接引用这些字段,无需额外解析文本。若要增加tags或short description,只需在解析器的Schema中增加对应字段,模型会自动适应。结构化输出不仅提升了可靠性,还减少了因模型自由发挥导致的格式错误。
配图生成与处理:不只是调一次API
图像节点同样走OpenAI接口,但流程比想象中细。生成后先做resize,因为文章需要两种尺寸:主图和缩略图。创作者用两个字段分别承接,同一张图经过两次尺寸处理后分别绑定。
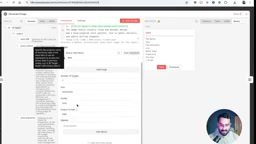
他还演示了一个实用技巧:如果需要在图片上叠加logo,用edit image模式配合binary数据传入,模型会按指定位置合成。binary模式返回的是二进制数据而非链接,这在后续上传到Drupal的文件API时反而更方便,直接作为multipart请求的body即可。
Drupal侧配置:Consumer、Scope与权限的三层控制
这是整条链路里门槛最高的部分。Drupal需要先安装web services、REST API和consumer相关模块,然后依次完成三步配置。
第一层是生成密钥对。在settings中点击生成,系统会把公钥私钥写入指定目录;本地环境如果没有目录写权限,这一步会直接报错,这是创作者提醒的常见坑点。
第二层是创建consumer。演示中为web端建了一个consumer,使用client credentials授权类型,并绑定scope。scope的本质是权限边界——可以让某个consumer只能读写article,而无法触碰站点其他内容。
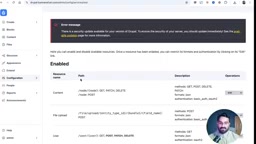
第三层是REST UI里的方法级开关。安装REST UI模块后,才能看到content、file、user三个API各自开放了哪些操作,比如把content API的delete方法关掉,只留create和update。这一步如果漏配,前面的consumer权限再细也没用。
Consumer(消费者)与Client Credentials授权
Drupal的Consumer是OAuth2授权体系中的客户端实体,代表一个调用API的应用程序。它通过client_id和client_secret进行身份认证,而client credentials授权类型适用于服务器到服务器的场景,无需用户介入登录。在生成密钥对后,consumer需要绑定scope,scope定义了该consumer能访问的资源和操作范围,例如只允许读写article内容类型。这样即使client_secret泄露,攻击者也只能在scope限定的权限内操作,无法触及敏感数据。配置consumer时,还需在REST UI中启用对应资源的方法,两者结合才能生效。
REST UI与权限矩阵
REST UI模块提供了图形化界面,让管理员可以逐个启用或禁用REST资源的方法(如GET、POST、PATCH、DELETE)。每个资源(如content、file、user)的方法独立控制,并且需要为每个角色或consumer分配相应的权限。若只启用了content的create和update方法,那么任何授权的consumer也只能执行这些操作。这层控制与scope形成互补:scope决定consumer能请求哪些权限,REST UI决定系统实际开放哪些端点。两者都正确配置,才能保证API的安全与可用。
发布文章:理解Drupal的JSON结构
文章推送节点是整个工作流的终点,也是结构最复杂的一环。请求体遵循Drupal标准API的嵌套格式:外层是data,里面先指定type,再通过target_id引用content type的机器名。正文写进description字段,同时声明format为basic HTML,因为编辑器字段需要显式指定文本格式。
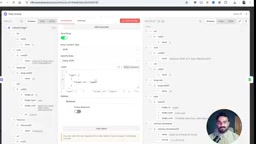
图片字段的处理稍有不同。上传图片后,file API返回的FID需要作为target_id填入image字段,alt text和title则可以直接复用文章标题。创作者提醒,如果这些子字段在content type里不是必填项,留空也不会报错,但填上更利于SEO。
Drupal JSON:API的嵌套数据格式
Drupal的REST API(尤其是JSON:API)要求请求体遵循特定的嵌套结构。对于内容实体,外层通常是data对象,其中type字段指定资源类型(如node--article),attributes包含字段值,relationships用于引用其他实体。在本文的示例中,图片字段通过target_id引用文件实体,这个ID来自文件上传API的返回。正文的description字段需要同时指定format(如basic_html),因为Drupal的文本字段依赖文本格式过滤器来渲染内容。理解这种嵌套关系是成功调用API的关键,否则容易因结构错误而返回400响应。
生产环境的加固建议
演示流程为了直观做了简化,创作者给出了面向生产环境的调整方案:写作模型选中高端型号并开启中等推理强度,生成后再挂一个reviewer agent做审校,用更高阶模型检查事实与行文,必要时二次润色。
另一个建议是加入人工审批环节。把Gmail节点接在发布前,把草稿发到自己的邮箱,确认后再触发后续的发布节点,否则流程直接退出。这样既保留了自动化的效率,又避免未经审阅的内容直接上线。
对于想继续扩展的人,这条工作流的尾部可以轻松接上Facebook等社交平台节点,实现一次生产、多端分发。
相关推荐

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。

REA:无需编码,用AI逆向任意应用
REA是一款爆火GitHub的开源AI逆向工程工具,可让Claude、Codex等AI代理直接分析任意应用并生成功能克隆,无需编码。本文介绍其工作原理、安装方法、实测案例及法律风险。