用NVIDIA NeMo Relay追踪Agent执行路径:让效率可见

NVIDIA NeMo Relay通过追踪Agent执行路径,将智能体评估从结果导向推进到过程导向。
AI智能体(Agent)即使顺利完成任务,其执行路径也可能充斥着失败重试、信息截断引发的重复操作和上下文冗余膨胀等隐性低效问题,而传统的任务成功率指标对此完全"视而不见"。NVIDIA推出的NeMo Relay正是针对这一可观测性缺口而设计,它通过对Agent Harness(智能体执行框架)进行细粒度行为追踪,让开发者能够看到任务执行的完整路径,而非仅仅是成功与否的最终标签。借助这种过程级别的可见性,开发者可以识别低效模式、对比不同配置下的执行差异,并以可量化的方式支撑迭代优化。这一工具的出现折射出一个更宏观的行业趋势:随着Agent系统从演示原型走向生产部署,可观测性正在成为Agent工程不可或缺的基础设施。
智能体完成任务,不代表走对了路
一个AI智能体(Agent)可以顺利完成任务,但它走的路径可能极其低效。一次失败的搜索会触发另一次搜索,一次被截断的文件读取会导致后续命令重复抓取内容——最终任务标记为"成功",但背后隐藏着大量冗余步骤和资源浪费。
这正是当前Agent开发者面临的一个核心痛点:结果导向的评估掩盖了过程的真实质量。传统的任务成功率指标(task success rate)只关心"做没做到",却无法回答"做得好不好"。NVIDIA推出的NeMo Relay工具,正是为了解决这一可观测性缺口,帮助开发者追踪智能体执行框架(Agent Harness)的行为轨迹。
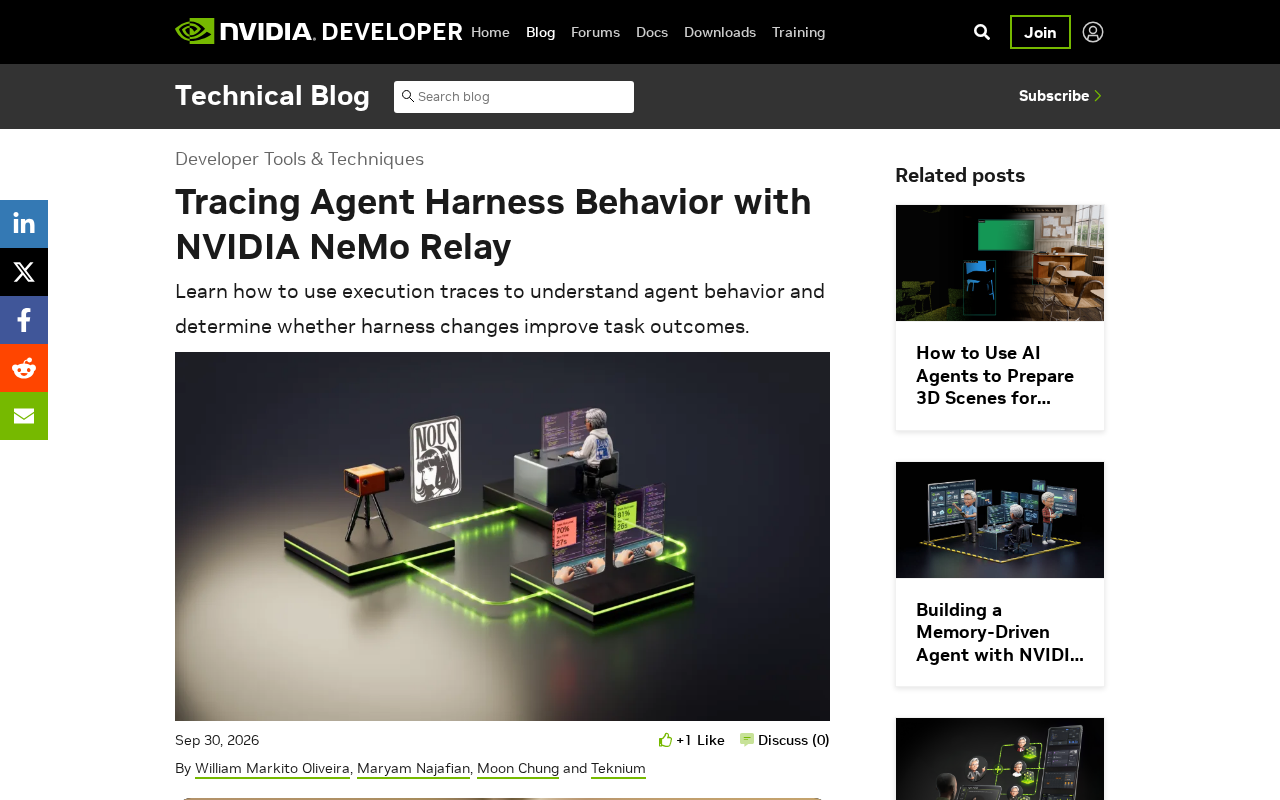
从配图中可以看到,两个任务成功率面板分别显示70%和81%——这种数字上的差异往往不能说明全部问题。两个看似接近的成功率背后,可能对应着完全不同的执行效率和资源消耗模式。
为什么Agent Harness的行为需要被追踪
Agent Harness指的是驱动智能体运行的执行框架,它负责协调模型调用、工具使用、上下文管理和多步推理的整个流程。当一个Agent在真实环境中运行时,它会经历一系列决策链:调用搜索、读取文件、执行命令、处理返回结果、再决策下一步。
问题在于,这条决策链中的每一个环节都可能出现"隐性低效":
- 失败重试的连锁反应:一次失败的搜索触发新的搜索,可能陷入低价值的循环
- 信息截断导致的重复操作:文件读取被截断后,Agent不得不发起额外命令去补全信息
- 上下文膨胀:冗余的中间步骤不断堆积到上下文窗口中,既增加token成本,又可能干扰后续判断
这些问题不会体现在最终的成功/失败标签上,但会实实在在地影响延迟、成本和用户体验。对于生产环境中的Agent系统而言,这类隐性成本会随着调用量放大成为不可忽视的负担。
Agent Harness这一概念值得进一步说明。在主流的Agent开发框架(如LangChain、AutoGen、LlamaIndex等)中,Harness特指将大语言模型与外部工具、记忆模块、执行循环"组装"在一起的胶水层。它决定了:模型输出后如何解析工具调用指令、工具返回的结果如何被格式化再喂回模型、多轮循环何时终止。不同框架的Harness实现差异很大——有的采用ReAct(Reasoning + Acting)范式,有的使用Plan-and-Execute结构,有的允许并行调用工具。正因为Harness是Agent智能的"运作骨架"而非模型本身,同一个底层模型在不同Harness下的执行效率可以相差悬殊,这也是追踪Harness行为而非仅追踪模型输出的核心理由。
NeMo Relay解决的核心问题
NeMo Relay的思路是把Agent的执行过程从"黑盒"变为"可追踪"。通过对Agent Harness行为进行细粒度的追踪(tracing),开发者能够看到智能体在完成任务过程中的完整路径,而不仅仅是终点。
这种可观测能力带来的价值体现在几个层面:
从结果评估到过程评估
单纯的任务成功率是一个滞后且粗糙的指标。当你观察到70%和81%两个成功率数字时,无法判断其中的执行路径是精简还是臃肿。追踪执行轨迹后,开发者可以对比不同配置、不同模型、不同prompt策略下的实际行为差异,找到真正影响效率的因素。
定位低效模式
通过追踪,那些"完成了但绕了远路"的案例会浮出水面。比如某个工具调用总是失败后重试、某类任务反复触发无效搜索——这些模式一旦被识别,就能针对性地优化Harness逻辑或工具设计。
支撑迭代优化
对于持续演进的Agent系统,行为追踪提供了一个可量化的对比基准。每次调整框架或模型后,开发者可以观察执行路径是否变得更高效,而不是只盯着一个可能存在误导的成功率数字。
对Agent开发实践的意义
NeMo Relay反映了一个正在成熟的趋势:随着Agent从Demo走向生产,可观测性(observability)正在成为Agent工程的基础设施。就像传统软件工程中的日志、监控和链路追踪一样,Agent系统同样需要一套完善的行为观测体系。
这对开发者提出了新的思维要求。评估一个Agent,不能只看它能不能完成任务,还要看:
- 它用了多少步骤完成任务?
- 有多少步骤是冗余或可避免的?
- 失败重试的比例有多高?
- 上下文利用是否高效?
这些维度共同构成了Agent的"执行质量画像"。NVIDIA将这类工具纳入NeMo生态,也说明大厂正在把Agent的过程质量作为重点方向布局。
可观测性(Observability)这一概念源自经典控制理论,后被引入分布式系统工程,通常由日志(Logs)、指标(Metrics)和链路追踪(Traces)三个支柱构成。对于传统微服务而言,链路追踪工具(如Jaeger、Zipkin)可以展示一次请求在多个服务节点间的完整耗时和调用关系。Agent系统的可观测性挑战在于:执行路径是动态生成的,步骤数量和顺序不固定,且单次"请求"可能跨越数十次LLM调用与工具调用。NeMo Relay等工具的出现,本质上是把分布式系统的Trace理念移植到非确定性的AI工作流上,需要额外记录模型的推理中间态、token消耗和工具调用语义,而非仅仅是时延和状态码。
结语
"任务成功"只是Agent评估的起点而非终点。NeMo Relay通过追踪Agent Harness的行为,把智能体执行过程中的低效路径暴露出来,让开发者能够从结果导向转向过程导向的优化。对于任何希望将Agent系统投入生产的团队而言,这种细粒度的行为可观测能力,很可能是从"能用"到"好用"之间的关键一步。
相关推荐
民主党若夺回众议院会弹劾特朗普吗?策略转向解析
民主党若夺回众议院,是否会弹劾特朗普?本文解析其从佩洛西时代到当下的策略转变,指出针对赫格塞斯等内阁官员的调查与弹劾,以及制造跨党派"艰难投票"才是真正看点。

豆包工作Agent实测:5个隐藏能力,打工人的效率外挂
豆包工作升级Agent能力后完整实测:文档处理、多维表格、PPT生成、录音转写四大技能围绕任务目标协同工作,帮打工人从提炼资料到汇报输出全流程提效。附使用技巧与体验评价。

豆包工作Agent实测:大学生的AI效率助手该这么用
豆包工作升级Agent能力实测体验:从课程资料整理、PPT框架搭建到论文规划和秋招岗位匹配,解析AI任务助手如何帮大学生提升效率,告别单纯聊天式使用。