用NVIDIA PhysicsNeMo构建汽车碰撞AI代理模型
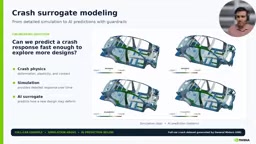
PhysicsNeMo 用四个 Notebook 将碰撞仿真数据训练为 Transolver 代理模型,并经 NIM 部署为推理服务。
文章介绍了 NVIDIA PhysicsNeMo 框架在汽车碰撞分析中的实战路径:利用已有高保真有限元仿真数据训练代理模型,以秒级 AI 推理逼近原本耗时数小时的物理求解。工作流拆为四个 Jupyter Notebook:数据准备与几何物理域参数化、基于 Transolver(GNN 架构)的代理模型训练、模型导出并通过 NVIDIA NIM 封装为推理微服务、推理结果与仿真真值对比验证。文章强调几何需按物理意义分区而非简单网格切块,数据集应按工况分组切分以保证泛化评估的有效性。同时指出演示基于简化参数化构件,跨工况泛化能力尚需实施方自行验证。
从碰撞仿真到AI代理模型:PhysicsNeMo 实战路径
汽车碰撞分析长期依赖高保真有限元仿真,单次求解动辄数小时。NVIDIA 在官方视频中演示了一条替代路径:用 PhysicsNeMo 框架把已有的碰撞仿真数据训练成代理模型(surrogate model),让 AI 在秒级时间内逼近原本昂贵的物理求解。视频作者身份为 AI Physics Solution Architect,内容围绕一个完整的四笔记本工作流展开。
这条路径的核心逻辑并不复杂——先用传统仿真生成数据集,再用神经网络学习"几何输入到物理响应"的映射关系,最后把训练好的模型封装成可交互的推理服务。真正值得关注的是工程细节:几何如何参数化、数据集如何切分、模型如何导出、以及如何用 NVIDIA NIM 把模型变成 API。
几何参数化:把碰撞结构变成可学习的输入
视频首先处理的是"模型表示"问题。碰撞分析的对象是具体的车身结构件,要让神经网络理解它,必须先把几何转化为张量。演示中使用了参数化的碰撞构件——从截图可以看到,工作流对几何体进行分区与物理域划分,将不同区域映射为网络可处理的输入特征。
这一步的难点在于保持物理一致性。几何被切分后,各区域之间的关系不能丢失,否则代理模型学到的只是表面形状而非结构力学行为。视频强调需要对几何做"物理意义上"的划分,而不是简单网格切块——这也解释了为什么整个流程要先定义物理域再谈训练。
数据集切分与训练配置
进入训练环节后,视频展示了数据集的划分策略。原始仿真数据被拆分为训练集与验证集,截图显示了不同数据块对应的角色分配——部分数据块用于训练,部分保留用于评估模型泛化能力。
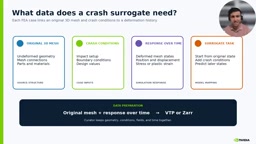
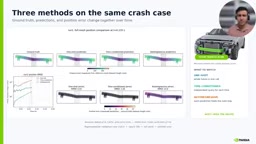
这里有一个容易被忽略的工程判断:数据集切分不是随机划分,而是按物理场景分组,确保验证集覆盖训练时未见过的工况。视频中提到需要"有意识地"划分数据,让模型在训练分布之外也能给出合理预测。训练目标则是对比代理模型输出与仿真真值之间的误差,通过误差图(error plot)直观判断模型在哪类几何或工况下偏差较大。
多笔记本工作流:从数据到推理服务的四步拆解
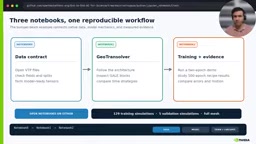
视频把整个流程拆成多个 Jupyter Notebook,每个承担明确职责,形成一条可复现的流水线。
Notebook 0:数据准备与几何采样
第一个笔记本负责加载碰撞仿真数据集、完成几何参数化,并配置 PhysicsNeMo 的碰撞分析 recipe。视频提到这一步要引入必要的物理组件(如碰撞相关的边界条件定义),为后续训练准备好格式统一的数据。
Notebook 1:代理模型训练
第二个笔记本执行训练。模型结构选择的是基于图神经网络(GNN)的 Transolver 类架构——视频中多次提到 "Transolver" 与 "transolver strategy",说明这类面向几何的算子学习方法是该 recipe 的默认选择。训练过程会周期性输出误差指标,供判断收敛情况。
Transolver 是一种面向几何的算子学习架构,其核心思路是在 Transformer 的注意力机制基础上引入物理感知的 token 化策略:将输入几何离散为若干空间区域(切片),每个切片内的点被聚合为一个 token,再通过注意力机制学习切片间的全局交互。与传统的图神经网络逐点消息传递相比,Transolver 能更高效地捕捉大尺度几何上的长程依赖,同时保持对网格分辨率的鲁棒性。在碰撞仿真场景中,这意味着模型可以学习应力波在车身结构中的传播路径,而不仅限于局部邻域的特征聚合。PhysicsNeMo 将其作为碰撞分析 recipe 的默认骨干,正是看中其在复杂几何上的表达能力与计算效率之间的平衡。
Notebook 2:模型导出与 NIM 封装
第三个笔记本把训练好的权重导出,并通过 NVIDIA NIM 封装为推理微服务。这一步是整条链路的价值出口:模型不再是实验脚本里的对象,而是可以通过 API 调用的服务,工程团队能把碰撞预测能力嵌入自己的设计流程。
NVIDIA NIM(NVIDIA Inference Microservice)是一套用于将训练好的模型快速封装为标准化推理服务的工具链。它基于容器化运行时,内置了针对不同模型架构的优化推理引擎(如 TensorRT、Triton Inference Server),并对外暴露统一的 REST/gRPC API 接口。对于物理代理模型而言,NIM 的价值在于屏蔽了部署细节:开发者无需手动编写服务端代码或调优批处理策略,只需提供模型权重和输入输出规范,即可获得一个可水平扩展的推理端点。这使得碰撞预测能力可以像调用普通 Web 服务一样被设计工具链集成,降低了 AI 模型进入工程流程的门槛。
Notebook 3:推理与结果对比
最后一个笔记本演示调用封装好的模型,将 AI 预测结果与仿真真值并排对比。视频展示了预测误差的空间分布,用来评估代理模型在具体构件上的可信度。
这条路径适合谁,边界在哪
从演示看,PhysicsNeMo 的碰撞分析 recipe 把"训练代理模型"这件原本需要大量手写代码的事,压缩成了配置加少量定制。对于已有仿真数据积累的车企或零部件供应商,这意味着可以较快验证代理模型在特定构件上的可行性。
但需要注意演示的边界:视频中的几何是简化的参数化构件,而非完整白车身;误差对比也集中在单一工况。真实碰撞分析涉及材料非线性、接触、大变形等复杂因素,代理模型能否覆盖这些场景,取决于训练数据的覆盖范围。视频本身没有给出跨工况泛化的量化结论,实施时需要自行验证。
另一个值得关注的信号是 NIM 的引入。把物理代理模型做成标准推理服务,意味着 AI 碰撞预测有可能进入设计迭代的日常流程,而不是停留在研究阶段的一次性实验。这对缩短开发周期有直接意义,但前提是模型精度经过充分验证。
总体来看,这个视频提供的是一条可操作的工程蓝图:仿真数据 → 几何参数化 → Transolver 训练 → NIM 部署 → 对比验证。它的价值不在于某个惊人指标,而在于把物理 AI 从概念拉到了具体的工作流层面。
相关推荐
Cerebras CS-4震撼发布:4万亿晶体管的晶圆怪兽,推理速度碾压GPU
Cerebras CS-4晶圆级引擎发布:4万亿晶体管、90万AI核心,推理速度比GPU快一个数量级。采用电源机架加计算背包的模块化设计,3D垂直堆叠与半毫米供电架构,几分钟即可上线部署。
苹果M6芯片登陆iMac:性能升级与AI争议一周回顾
苹果发布搭载M6芯片的新款iMac与MacBook Pro,N1无线芯片带来速度提升;OpenAI宣称模型取得三项重大发现却引发学界质疑;数据中心成为美国中期选举争议焦点;Anduril联手高通推全美制造笔记本。
AI攻克准黎曼猜想?数学家亲述震撼时刻
数论学家Alex在Lex Fridman播客中讲述AI证明准黎曼猜想的震撼经历,以及一个月内费马大定理形式化、Navier-Stokes等多次认知颠覆,解析黎曼猜想的信号处理直觉与AI在数学领域的突破边界。