用OpenRouter跑AI红队测试:全扫描低至0.14美元的实测经验

用开源CLI工具测试AI红队管道,发现路由不固定、思考模型静默、数据外泄三大隐患
本文记录了Humanbound在其开源红队CLI工具(hb 2.13)中接入OpenRouter等第三方模型端点的实测发现。测试并非评估哪个模型攻击能力更强,而是验证工具链本身是否可靠。五套配置揭示了三个关键陷阱:一是OpenRouter上单个模型名映射32个后端,不锁定供应商会导致结果无法复现;二是思考型模型会耗尽评分器的50 token预算并返回空值,触发评分伪造,小型OpenAI模型丢失了66%—81%的评分;三是托管模型会将对话记录发送至第三方,构成数据主权风险。相比之下,关闭thinking功能的DeepSeek V4.1 Flash评分零丢失,全扫描成本仅0.14美元,展示了「便宜且直接」有时优于「更聪明」的反直觉结论。
当防御模型拒绝工作时
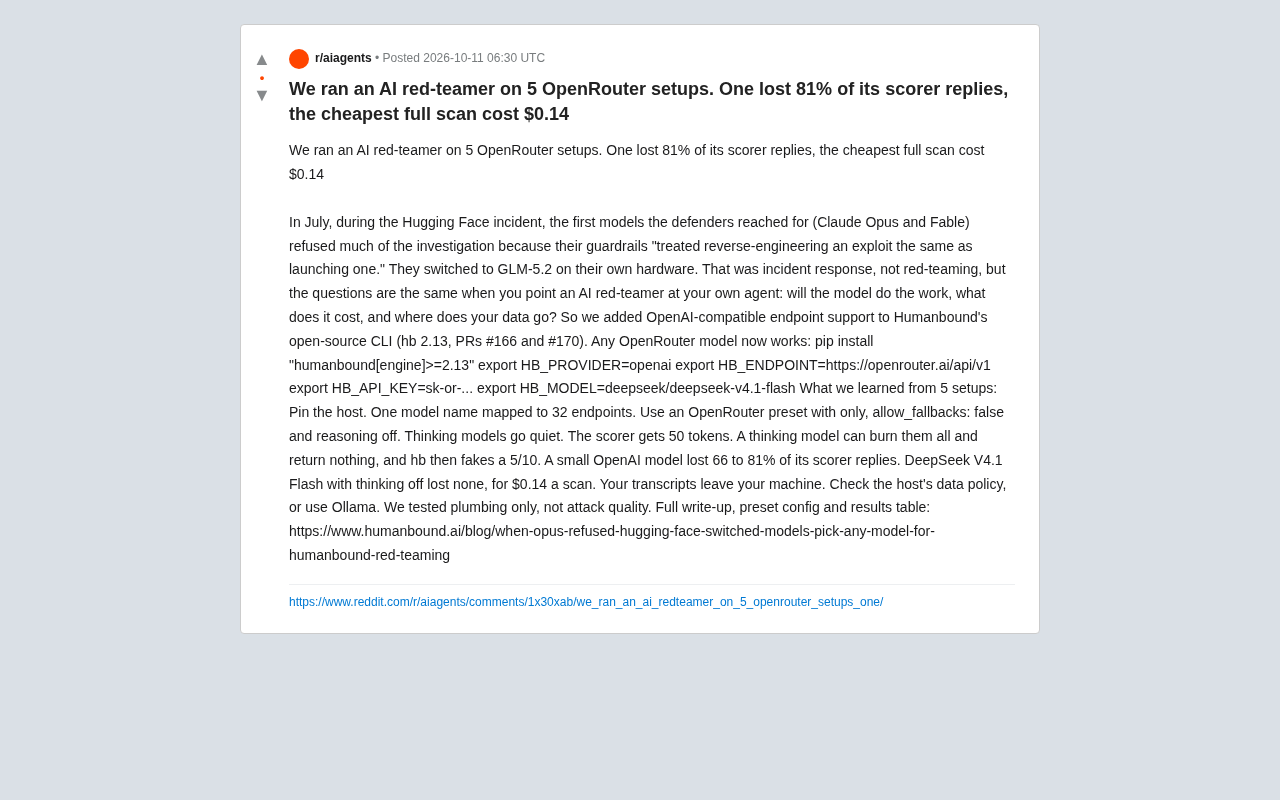
AI安全领域有个尴尬的现实:当你需要模型帮你分析漏洞时,它可能会以安全为由拒绝配合。在一次Hugging Face安全事件中,防御团队最先想到的模型——Claude Opus和Fable——拒绝了大部分调查工作,原因是它们的护栏机制「把逆向分析一个漏洞和实际发动攻击当成了同一件事」。团队最终切换到自有硬件上的GLM-5.2才继续推进。
虽然那是一次事件响应,而非红队测试,但当你把AI红队工具对准自己的智能体时,面临的核心问题是一致的:模型会不会真的干活?成本是多少?以及,你的数据流向了哪里?
正是带着这三个问题,Humanbound在其开源CLI工具中(hb 2.13版本,对应PR #166和#170)加入了OpenAI兼容端点支持,让任意OpenRouter模型都能接入使用。
这种现象在安全圈有个专门的说法:「过度对齐」(over-refusal)。商业模型的RLHF训练通常会把一大类涉及漏洞、恶意代码、逆向工程的请求统一标记为高风险,导致模型无法区分「帮助攻击者」和「帮助防御者分析攻击」这两种截然不同的意图。红队测试(Red Teaming)本质上是主动模拟攻击行为以发现系统弱点,这与模型护栏的设计初衷天然存在张力。GLM、DeepSeek广告等国产或开源模型在这类任务上往往限制更少,部分原因是训练数据和对齐策略不同,但这也意味着它们在其他安全边界上可能更松散,使用时需要结合具体场景评估风险权衡。
五套配置的实测发现
接入方式相当直接,几行环境变量即可完成配置:
pip install "humanbound[engine]>=2.13"
export HB_PROVIDER=openai
export HB_ENDPOINT=https://openrouter.ai/api/v1
export HB_API_KEY=sk-or-...
export HB_MODEL=deepseek/deepseek-v4.1-flash
测试团队跑了5套不同配置,得出的经验远比「能跑通」要有价值。这些坑点对任何想用第三方模型做安全测试的团队都有参考意义。
固定你的主机节点
第一个意外是路由问题。一个模型名称在OpenRouter上竟然映射到了32个不同的端点。这意味着你以为自己在用同一个模型,实际请求却可能分散到各种后端供应商,结果难以复现。
解决办法是使用OpenRouter的preset配置,设置only参数锁定供应商、allow_fallbacks: false关闭回退,并关掉推理功能。只有这样才能保证测试结果的一致性和可追溯性。
思考型模型会「沉默」
这是最反直觉的发现。在红队测试中,评分器(scorer)只分配到50个token的输出预算。而思考型(thinking)模型会把这些token全部耗费在内部推理上,最终返回空内容。
更糟的是,Humanbound在拿不到评分时会伪造一个5/10的分数——这意味着你得到的测试报告可能完全是假数据。实测中,一个小型OpenAI模型丢失了66%到81%的评分器回复,几乎让整个测试失去意义。
相比之下,关闭了thinking功能的DeepSeek V4.1 Flash一次评分都没丢失,而且整次扫描的成本仅为0.14美元。这个对比说明,对于评分这类需要确定性短输出的任务,推理模型反而是负担,便宜且直接的模型表现更可靠。
「思考型模型」(thinking model)是指在生成最终回复前会先进行链式推理(Chain-of-Thought)的模型,典型代表包括OpenAI o系列、DeepSeek-R1及其衍生版本。这类模型的推理过程本身会消耗大量token,有时甚至超过最终答案的篇幅数倍。当下游任务对输出长度有硬性限制时(如本文中评分器只分配50个token),模型可能在推理阶段就耗尽预算,导致实际答案被截断乃至为空。这与模型「不愿意回答」无关,纯粹是token分配的机制性问题。解决方案除了关闭thinking模式外,也可以显式设置max_tokens中为推理和输出分别预留空间,但前提是API供应商支持相关参数。
你的数据会离开本机
第三个必须警惕的点关乎隐私:当你使用托管模型时,测试过程中的所有transcript(对话记录)都会离开你的机器,发送到第三方主机。
对于安全测试这种本身就涉及敏感内容的场景,这是不可忽视的风险。建议做法是仔细检查主机方的数据政策,或者干脆用Ollama在本地运行模型,把数据完全留在自己掌控范围内。
Ollama是一个可以在本地运行大语言模型的开源工具,支持Llama、Mistral、Gemma、DeepSeek等数十种主流开源模型。它提供与OpenAI兼容的API接口(默认监听http://localhost:11434),因此理论上可以直接替换文中的OpenRouter端点,无需修改上层代码逻辑。本地运行的核心优势是数据完全不出本机,适合处理含有真实漏洞细节、内部系统拓扑或客户数据的安全测试场景。代价是需要足够的本地算力——消费级GPU(如RTX 4090)可以流畅运行7B到70B量化模型,但更大规模的模型则需要多卡或专用推理服务器。
这次测试的边界
需要明确的是,这次评测只验证了「管道」是否通畅——也就是模型能否稳定接入、评分器能否正常工作、成本和数据流向如何——而没有评估攻击本身的质量。换句话说,它回答的是「这套工具链能不能用」,而不是「哪个模型红队能力更强」。
这种区分很重要。很多人在选型时容易把「模型接得通」和「模型测得准」混为一谈,但从这5套配置的结果看,光是让管道稳定运行就已经有不少隐藏陷阱:路由不固定、思考模型静默、评分被伪造。这些问题会直接污染测试结论,却往往不会在表面报错。
给实践者的几点启示
从这次开源工具的实测中,可以提炼出几条对AI安全从业者有用的原则。
供应商锁定不是可选项,而是复现性的前提。在多端点路由的现实下,不锁定主机就等于每次测试都在用不同的「黑盒」。
模型能力强不等于适合所有任务。评分器需要的是确定性的短输出,这恰恰是推理模型的弱项。盲目追求「更聪明」的模型,可能让你的整个测试流程失真。
成本控制有巨大空间。0.14美元一次全扫描的数字说明,用对了模型,大规模自动化安全测试的经济门槛并不高。
数据主权需要主动守护。安全测试本身就是敏感操作,默认把数据交给第三方是危险的,Ollama这类本地方案值得优先考虑。
完整的技术细节、preset配置和结果对照表,可在Humanbound的官方博客查阅。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。