用Python构建语音驱动AI多模态生成流水线
用Python和OpenRouter统一网关搭建从语音到视频的五步AI流水线,总成本约3.28美元。
文章介绍了一位YouTube创作者用Python构建的多模态AI流水线:用户录音后,系统依次完成语音转录、结构化脚本生成、封面图生成、配音生成和视频合成,最终输出MP4文件。项目最大的工程亮点是使用OpenRouter作为统一模型网关,用一个API密钥调用文本、图像、语音和视频模型,并支持主备模型自动切换。脚本生成环节通过JSON Schema强制模型输出固定字段,视频生成则采用轮询机制处理异步任务,并以封面图作为首帧提升一致性。完整运行成本约3.28美元,其中视频生成占3.20美元。文章还指出图像格式兼容性和内容审核拦截等实际落地中的问题。
在AI应用开发中,将语音输入转化为完整的视频输出,听起来像是需要多个团队协作的复杂工程。但一位YouTube创作者展示了如何用Python和统一的API端点,构建一条从录音到视频生成的完整流水线。这个项目不仅演示了多模态AI的串联方式,还给出了清晰的成本核算,为想要尝试类似项目的开发者提供了可复用的模板。
项目架构:五步流水线设计
整个系统的核心思路是将复杂任务拆解为顺序执行的独立步骤。用户按下回车开始说话,系统录制音频后自动完成后续所有操作:语音转文字、生成脚本、生成封面图、生成配音、合成视频。最终输出一个包含画面和音轨的MP4文件,并附带完整的成本明细。
这种设计的好处在于每个步骤都可以独立调试和替换。创作者在视频中展示了单独运行每个步骤文件的过程,方便开发者理解每个环节的输入输出。
单一API密钥管理多模型
项目最实用的设计决策是使用OpenRouter作为统一的模型网关。传统做法中,生成文本需要OpenAI的SDK,生成图像需要Stability AI或Google的接口,视频生成又是另一套认证体系,管理七八个API密钥既繁琐又容易出错。
通过OpenRouter,所有请求走同一个端点,只需在请求体中指定模型名称。视频中演示了在文本生成环节配置主模型和备用模型(fallback),当主模型限流或不可用时自动切换,这种机制在生产环境中尤为重要。创作者还展示了如何通过/images/models端点查询特定图像模型支持的参数列表,避免盲目尝试。
OpenRouter 是一个聚合多家模型提供商的 API 网关,它对外暴露与 OpenAI 兼容的接口格式,开发者只需维护一个 API 密钥,即可在请求体中通过模型标识符调用不同厂商的文本、图像甚至多模态模型。这类网关的核心价值在于抽象层:它统一了认证方式、请求结构和计费入口,并在多个上游提供商之间做路由和故障转移。文章提到的 fallback(备用模型)机制正是网关层的典型能力——当主模型返回限流或服务不可用错误时,网关自动将请求转发到预先配置的备用模型,调用方无需修改代码。需要注意的是,网关在带来便利的同时也引入了一层额外延迟和单点依赖,且不同上游模型对参数的支持程度并不完全一致,因此查询模型能力端点(如 /images/models)是必要的适配步骤。
关键技术环节拆解
语音录制与转录
录音部分使用sounddevice库捕获麦克风输入,通过回调函数将音频流写入numpy数组,再保存为WAV文件。转录环节调用Whisper Large V3 Turbo模型,将Base64编码的音频数据发送至/audio/transcriptions端点。创作者特别指出,这个模型"成本只是几分钱的一小部分",转录速度快,适合作为流水线的第一环。
结构化脚本生成
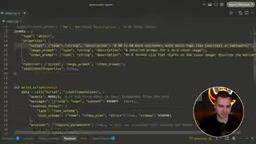
脚本生成步骤使用了JSON Schema强制模型输出固定结构。请求中定义了三个必需字段:40到60词的带情感标签的配音脚本、详细的16:9封面图提示词、以及8秒视频片段的运动描述。这种结构化输出确保后续步骤能稳定解析所需内容,而不是从自由文本中猜测提取。
JSON Schema 是一种用于描述和验证 JSON 数据结构的规范,它定义了对象应包含哪些字段、字段的类型、取值范围以及是否必需等约束。在调用大语言模型时,将 JSON Schema 作为请求参数的一部分传入,可以强制模型按照预定义的结构输出内容,而不是返回自由格式的文本。这种技术通常被称为“结构化输出”或“受约束解码”,其底层实现方式因模型提供商而异:有的通过语法引导的解码策略限制 token 生成,有的则通过函数调用(function calling)机制间接实现。相比在提示词中要求“请以 JSON 格式输出”,JSON Schema 的约束力更强,能显著降低解析失败的概率,是构建多步骤 AI 流水线时保证数据契约稳定的关键手段。
图像与视频生成
图像生成环节演示了模型切换的灵活性。创作者先尝试了Gemini模型,又测试了Recraft模型,发现后者"速度明显更快且成本低得多"。但切换到Recraft后出现了一个意外问题:生成的图像格式不是标准JPEG或PNG,导致后续视频生成 API 报错。重新用Gemini生成封面图后问题解决。这个细节说明,在多模型协作时,输出格式的兼容性需要额外验证。
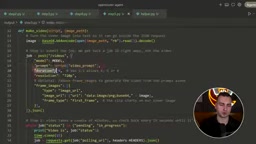
视频生成是成本最高的环节。项目使用Google Veo 3.1模型,以封面图作为首帧,生成8秒、720p分辨率的片段。由于视频生成耗时较长,API采用轮询机制:先返回一个轮询URL,客户端每隔15秒查询一次状态,待状态变为完成后从签名URL下载视频内容。创作者特别提到,以图像作为首帧能让结果"更一致",这是提升生成质量的一个实用技巧。
轮询(polling)是处理异步 API 任务的常见模式。当请求的任务耗时较长时,服务端不会让 HTTP 连接一直挂起等待结果,而是立即返回一个任务标识或状态查询 URL,客户端随后按固定间隔反复请求该 URL 以获取任务进度。在视频生成场景中,渲染一段几秒的片段往往需要数十秒到数分钟,因此轮询几乎是最主流的状态获取方式,与之相对的是 Webhook 回调或流式推送。轮询间隔的选择需要在响应及时性和请求开销之间权衡:间隔太短会增加无效请求和限流风险,太长则延长整体等待时间。工程实现中通常还会设置最大轮询次数和退避策略,避免任务失败时陷入无限循环。
成本结构与实际表现
视频中完整展示了一次运行的账单:总成本3.28美元,其中视频生成占3.20美元,图像生成约0.67美分,文本和转录成本可以忽略不计。创作者坦言视频生成"相当昂贵",但也指出可以通过选择更便宜的模型来压缩成本。
实际生成效果方面,测试案例包括"在电脑前喝咖啡挣扎的程序员"和"火星上骑独角兽的牛仔"。画面质量"不是世界上最好的",但基本符合文字描述。有趣的是,当生成包含疑似知名IP形象的图像时,视频生成API返回了第三方内容版权拦截错误,创作者表示"从未见过这个错误",这从侧面反映了视频模型在版权合规方面的审查机制。
对开发者的启示
这个项目的价值不在于生成质量本身,而在于展示了一种可复用的架构模式:用统一网关屏蔽多模型差异、用结构化输出保证流水线稳定性、用轮询处理异步任务、用成本追踪控制预算。对于想要构建AI Agent的开发者来说,这些工程实践比具体的模型选择更有参考意义。代码通过加入创作者的社区可免费获取,降低了动手尝试的门槛。
说个细节,流水线中各环节的衔接并非完全无缝。图像格式兼容性问题、内容审核拦截等意外情况说明,多模态系统在生产化之前需要增加更多的格式校验和错误处理逻辑。这也是从演示项目走向实际应用时必须跨越的一步。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。