用Python和Claude API构建AI Agent:工具调用与MCP实战

用Claude API在Python中手写Agent Loop,并理解工具描述、MCP与安全边界。
文章基于一期技术讲解视频,演示如何用Claude API在Python中从零搭建一个能读文件、能循环决策的Agent。它从最基础的`messages.create`调用讲起,说明content blocks的返回结构,再引入`tools`列表与JSON Schema,强调description决定模型何时调用工具,其重要性不亚于schema。核心是约二十行的Agent Loop:当`stop_reason`为`tool_use`时执行本地函数并回传`tool_result`,直到模型结束回合,同时必须设最大步数以防无限循环。文章还梳理了托管工具、SDK tool runner、Agent SDK等少写循环的路径,并用“USB接口”比喻介绍MCP开放标准,最后给出最小权限、日志、成本上限与人工确认等安全落地建议。
工具调用(Tool Use)让大模型从“聊天”走向“做事”,而Agent Loop则是把这种能力组织成可重复工作流的关键。这篇内容基于一期技术讲解视频,拆解了如何用Claude API在Python里从零搭一个能读文件、能循环决策的Agent,并顺带梳理了MCP这个正在被越来越多工具支持的开放标准。
从一次普通API调用开始
搭建Agent的第一步不是写循环,而是先跑通最基础的请求。视频里的做法很直接:创建虚拟环境,pip install anthropic,在Claude控制台生成API Key,然后把它存进名为ANTHROPIC_API_KEY的环境变量——而不是硬编码在代码里。这一步看似琐碎,却是后面所有安全实践的前提。
代码层面,导入anthropic并创建client,调用client.messages.create,传入模型名(视频中以Claude Sonnet 5.5为例)、max_tokens和消息列表。每条消息有role(user或assistant)和content。返回结果是一组content blocks,取出其中的文本打印出来,一次对话就完成了。
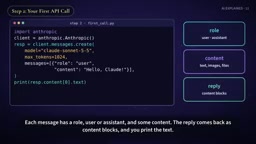
这个阶段的代码没有任何“智能”可言,但它建立了后面所有逻辑的骨架:请求、响应、消息累积。理解content blocks的返回结构,是读懂后面tool_use块的基础。
环境变量与API Key管理:把API Key存进ANTHROPIC_API_KEY环境变量而不硬编码,是Anthropic SDK的默认约定——anthropic客户端初始化时会自动读取这个变量,无需在代码里显式传参。这样做的直接好处是密钥不会进入版本控制,也便于在不同环境(本地、CI、生产)切换不同凭证。代价是环境变量对所有能读该进程环境的代码可见,所以生产环境通常还会叠加密钥轮换、按项目分发独立Key、以及用secrets manager注入等手段。理解这一约定,也能解释为什么后面所有代码示例都不出现明文密钥。
给模型装上工具:description比schema更重要
让Claude变成Agent的核心动作,是在请求里附带tools列表。每个工具包含三部分:name、description、以及用JSON Schema写的input_schema。视频举的例子是read_file,描述为“从notes文件夹读取一个文本文件”,只有一个必填参数path。
这里有个容易被忽视的细节:模型是靠读description来决定何时调用工具的,所以描述写得好不好,直接决定工具被调用的准确率。一个含糊的“读取文件”和一个明确了目录范围和文件类型的描述,效果差距很大。schema负责约束参数结构,description负责表达意图,两者分工不同。
当Claude决定使用某个工具时,响应里的stop_reason会变成tool_use,同时出现一个tool_use块,包含工具ID、名称和输入参数。关键在于:Claude本身不会执行任何工具。真正跑函数的是你的Python代码,权限边界、参数校验、危险操作拦截,全部由开发者掌控。
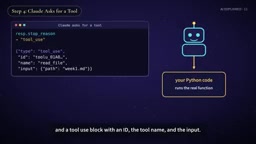
JSON Schema与tool_use块:input_schema遵循JSON Schema规范,用来声明参数的类型、是否必填、枚举取值等约束,模型生成的参数会按这个结构输出,但服务端并不强制校验其业务语义。而tool_use块是响应content blocks中的一种类型,除文本块外,一条响应里可能同时出现多个tool_use块,意味着模型可以在一次回合里请求并行调用多个工具。每个块自带唯一tool_use_id,它是后续把执行结果与请求配对的关键——回传tool_result时必须带上同一个ID,否则模型无法判断结果对应哪次调用。
Agent Loop:二十行代码的核心循环
拿到tool_use块之后,流程是这样的:把Claude的回复追加到消息列表,然后新增一条user消息,里面放tool_result块,使用相同的tool_use_id并附上本地函数的执行结果。再次调用API,Claude读取结果后,要么请求下一个工具,要么给出最终答案。
把上面这套动作包进循环——只要stop_reason还是tool_use,就继续执行工具、回传结果——一个Agent就成型了,视频作者说这大约只需要20行Python。循环的退出条件是Claude结束自己的回合,此时打印最终答案。
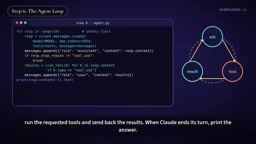
循环必须配一个最大步数限制。没有这个上限,一旦工具持续返回让模型不满意的结果,Agent可能无限打转,烧掉的不只是时间还有token费用。这是视频反复强调的工程纪律,而不是可选项。
stop_reason的取值与轮次语义:stop_reason是判断循环是否继续的唯一依据,常见取值包括end_turn(模型自然结束回合)、tool_use(等待工具结果)、max_tokens(达到输出上限被截断)和stop_sequence(命中自定义停止序列)。一个健壮的循环不应只区分“是不是tool_use”,还要处理max_tokens这类异常终止,否则可能在截断的响应上继续拼接,导致消息历史损坏。此外,tool_result块默认被视为user角色消息的一部分,多个并行工具的结果应放在同一条user消息里回传,这样模型能在一个回合内看到全部结果,而不是被迫多走几轮。
少写循环的几种路径
手写循环的价值在于理解机制,但生产环境未必需要重复造轮子。视频提到了几条省力路径:一类是跑在Anthropic服务器上的托管工具,比如web search和code execution,开发者不需要自己实现;另一类是Python SDK内置的tool runner,它把整个循环封装好了;再往上还有Claude Agent SDK,提供的是驱动Claude Code的那套agent harness。
选择哪一层取决于你对控制力的需求。托管工具省事但可定制性有限,自建循环灵活但要自己处理错误、重试和日志。理解底层循环之后再选用高层封装,遇到问题时才不至于无从下手。
托管工具与tool runner的边界:托管工具(如web search、code execution)运行在Anthropic侧,调用方只看到结果,无法介入中间过程,适合标准化、无需定制的场景;Python SDK的tool runner则在本地替你跑循环,但仍由你定义工具函数,控制力介于两者之间;Claude Agent SDK更进一步,把上下文管理、子Agent、权限钩子等harness层能力一并封装。三者的差别本质上是“谁持有循环控制权”:越往上封装越省事,但出错时的可观测性和干预点也越少。选型时应先明确是否需要自定义重试策略、审计日志或人工确认节点,再决定停在哪一层。
MCP:AI工具的USB接口
Model Context Protocol(MCP)是Anthropic推出的开放标准,视频里用了一个很直观的比喻:它是AI工具的USB端口。你为数据库或某个服务写一次MCP server,任何兼容MCP的应用都能接上使用,包括Claude、Claude Code,以及不少其他公司的工具。
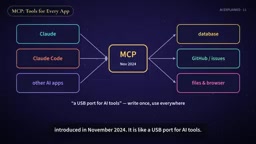
这个类比点出了MCP的真正价值:把“为每个AI应用单独写集成”变成“写一次、处处可用”。对于需要把内部系统暴露给多个AI客户端的团队来说,这能显著降低重复适配的成本。它的意义不在于多了一个协议,而在于集成的边际成本被压下来了。
上手前的几条安全建议
视频给出的落地建议很务实:从简单开始,一个模型、几个描述清晰的工具、一个循环;给每个工具最小必要权限;记录每一步的日志;限制步数和成本上限;高风险动作前先让人确认;在信任Agent之前,用真实案例充分测试。
这些建议指向同一个事实:Agent的能力来自工具,风险也来自工具。一个能读文件、能查数据库、能执行代码的Agent,如果权限放得太宽、日志留得太少,出问题时很难定位也很难止损。循环加上限、权限给最小、动作留痕迹,这三条比任何框架选择都更能决定一个Agent能否安全上线。
相关推荐

开源多Agent模拟经营项目实战评测
基于B站UP主开源的多Agent沙盘经营项目实测,拆解其规划、记忆、多Agent通信、HITL与评估机制,对比大模型自主决策与固定规则引擎在不同场景下的收益差异,为Agent开发者提供选型与工程实践参考。
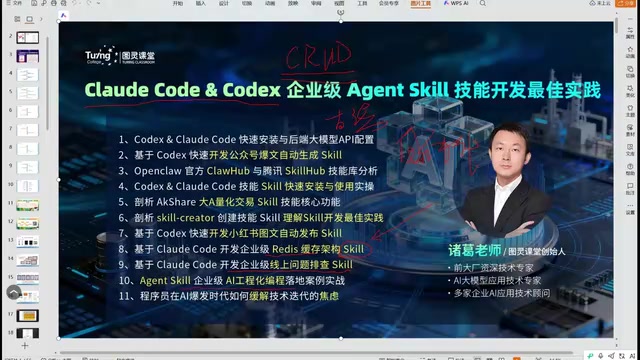
AI工程化实战:Claude Code与Agent Skill开发全流程
B站实战课解析AI工程化:用Claude Code、Codex、WorkBuddy开发企业级Agent Skill,涵盖公众号报文、量化分析、小红书自动发布等案例,讲透Skill驱动开发的范式转移与工具选型。
LangChain零基础入门:结构化输出与Agent实战指南
从LangChain零基础讲起,厘清低代码平台与大模型应用开发的本质区别,覆盖结构化输出、工具调用、Agent实战与多租户RAG企业项目落地四大模块,适合有开发基础想转型AI应用开发的工程师。