用生成模型检验条件分布相等性:高维场景下的新方法

新研究用生成模型辅助条件分布检验,在高维下实现更好的尺寸控制与检验效力。
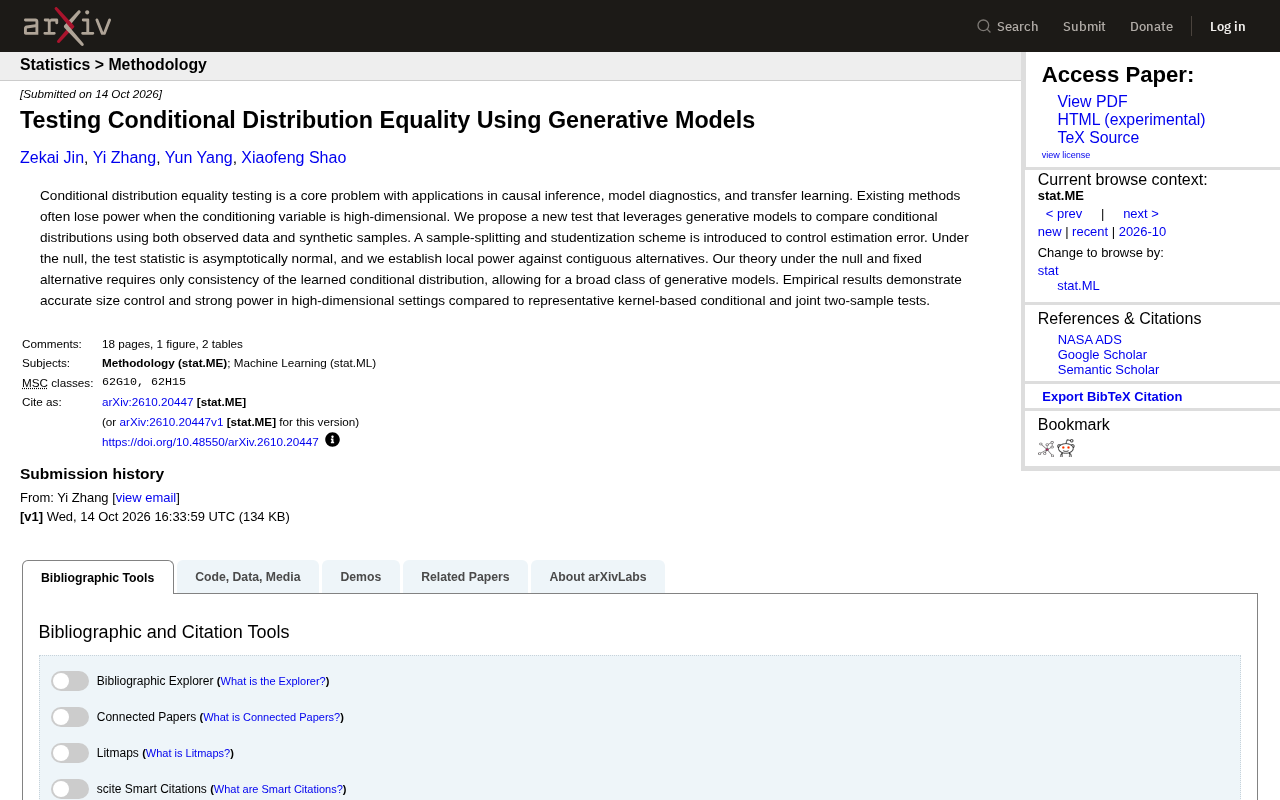
文章介绍一种利用生成模型比较条件分布 P(Y|X) 的新检验方法,旨在绕开高维非参数估计的维数灾难。核心设计包括三层:用生成模型同时拟合两组条件分布并抽取合成样本,使检验统计量同时依赖观测数据与合成数据;采用样本分割与学生化控制生成模型过拟合带来的估计误差,使原假设下统计量渐近服从标准正态分布;理论仅要求学到的条件分布相合,适用于扩散模型、条件 GAN、条件 VAE 等广泛模型。研究还证明方法对连续备择假设具有非平凡局部功效,能检测随样本量增大而缩小的微弱差异。实验显示,在高维设置下相比核方法,新方法尺寸控制更准确、检验效力更强,但实际表现仍取决于生成模型能否准确学习条件分布,小样本下样本分割也可能削弱功效。
条件分布相等性检验是因果推断、模型诊断和迁移学习中的一个核心问题。传统方法在条件变量维度较高时往往失去检验效力,而一项新研究提出借助生成模型来比较条件分布,同时利用观测数据与合成样本,并通过样本分割与学生化方案控制估计误差,在高维场景下展现出更优的检验性能。
问题背景:为什么条件分布检验在高维下如此困难
条件分布相等性检验的目标,是判断在给定条件变量 X 的情况下,两组数据的条件分布 P(Y|X) 是否一致。这个问题在因果推断中用于检验干预效应是否随协变量变化,在模型诊断中用于判断模型是否在不同子群上表现一致,在迁移学习中则用于衡量源域与目标域的条件偏移。
困难在于,当条件变量 X 的维度升高时,条件分布的非参数估计会遭遇维数灾难。基于核函数的方法——无论是条件两样本检验还是联合两样本检验——其检验统计量的收敛速度会随维度增加而急剧下降,导致在样本量有限时几乎无法检测出真实差异。
这项研究的出发点正是绕开直接的非参数估计难题:如果生成模型能够学习到条件分布,那么就可以用生成样本来辅助构造检验统计量。
维数灾难(curse of dimensionality)是理解本文动机的关键背景。它指当协变量维度 d 增大时,非参数估计所需的样本量呈指数级增长:若要在每个维度上以固定精度估计函数,样本量大致需要随 d 指数扩张。这直接导致核密度估计、核均值嵌入等方法的收敛速率失去实用性。对条件分布检验而言,这意味着基于核函数的检验统计量在原假设下的方差会随维度升高而膨胀,而在备择假设下的信号又相对减弱,最终表现为检验功效急剧下降。本文选择“绕开直接非参数估计”的路线,本质上是承认在高维中无法用传统方式稳定估计 P(Y|X),转而用生成模型隐式学习该条件分布,把统计难题转化为生成建模与样本分割问题,这是高维条件下检验方法设计的一种范式转移。
方法核心:生成模型 + 样本分割 + 学生化
新方法的关键设计有三层。
第一层是生成模型的双重角色。研究人员使用生成模型同时拟合两组数据的条件分布,并从中抽取合成样本。检验统计量同时依赖于观测数据和这些合成样本,从而在条件分布的学习过程中“借用”生成模型的表达能力。
第二层是样本分割与学生化。为了避免生成模型在训练集上的过拟合影响检验的渐近性质,方法采用样本分割:一部分数据用于训练生成模型,另一部分用于计算检验统计量。学生化(studentization)则用于校正估计误差,使得在原假设下检验统计量渐近服从正态分布。
第三层是理论保证的宽松条件。在原假设和固定备择假设下,理论分析仅要求学习到的条件分布具有相合性(consistency),而不要求生成模型具有特定的参数形式或收敛速率。这意味着扩散模型、条件GAN、条件VAE等广泛的生成模型都可以被纳入该框架。
研究还建立了对连续备择假设的局部功效(local power),这是检验理论中衡量方法能否区分“微弱但真实差异”的重要指标。
样本分割(sample splitting)在统计推断中是一种经典技术,其核心目的是切断“数据既用于估计 nuisance 参数、又用于构造检验统计量”所带来的过拟合偏差。若直接用同一批数据训练生成模型并计算检验统计量,生成模型在训练集上的拟合误差会与检验统计量纠缠,导致原假设下的分布偏离理论分布,从而破坏渐近正态性。本文的做法是把样本分为训练子集与推断子集,使检验统计量的分布条件在训练子集上可被视为独立,从而恢复理论保证。代价是用于计算统计量的样本量减少,这也是本文在小样本场景下功效可能受限的原因。与样本分割配套的学生化(studentization)指用统计量的估计标准差去除其中心化偏差,使标准化后的量在原假设下渐近服从标准正态分布,便于统一设定拒绝域和 p 值,而不需要为不同维度重新校准临界值。
理论性质:渐近正态性与局部功效
在原假设下,该检验统计量渐近服从标准正态分布,这为设定拒绝域和计算p值提供了直接依据。更关键的是,研究证明了在连续备择假设下,检验具有非平凡的局部功效——也就是说,当两组条件分布的差异随样本量增大而缩小时,检验仍能以高于随机猜测的概率检测到这一差异。
这一理论结果的条件相当宽松:只要求生成模型学习到的条件分布是相合的,不要求其收敛速率达到某个阈值。相比之下,许多基于核方法的检验需要条件分布估计达到特定的收敛速率才能保证检验效力,这在高维下往往难以满足。
局部功效(local power)是检验理论中评价方法灵敏度的核心概念。与固定备择假设不同,局部备择让两组分布之间的差异随样本量 n 增大而以 n^{-1/2} 的速率缩小,考察检验能否仍以高于显著性水平的概率检测出这种“越来越微弱”的差异。若某检验在局部备择下功效趋于 1,则称其具有非平凡的局部功效,通常说明该检验在信息论意义下接近最优。本文证明其方法在连续备择下具备这一性质,且仅要求生成模型学到的条件分布相合(consistency),而不要求具体收敛速率。这一宽松条件的重要性在于:许多基于核方法的检验需要条件分布估计达到某种速率(如 n^{-β})才能保证局部功效,而该速率在高维下往往被维数灾难击败,因此核方法的局部功效在高维下可能退化为随机猜测水平。
实验表现:高维场景下的尺寸控制与检验效力
实证结果从两个维度验证了新方法。在尺寸控制(size control)方面,即在原假设为真时拒绝率是否接近预设显著性水平,新方法表现出准确的尺寸控制,没有出现过度拒绝或过于保守的问题。
在检验效力方面,研究将新方法与代表性的基于核函数的条件两样本检验和联合两样本检验进行了对比。在高维设置下,新方法展现出更强的检验功效,而核方法由于维数灾难导致的功效衰减明显。
这一对比结果与理论分析一致:生成模型的引入使得方法能够适应条件分布的复杂结构,而不必依赖于在高维空间中迅速退化的核距离度量。
适用边界与开放问题
尽管理论条件宽松,方法的实际表现仍依赖于生成模型能否准确学习条件分布。在条件分布本身难以学习的场景下——例如条件变量与响应变量的关系极度复杂或数据极度稀缺——检验的可靠性会受到影响。
此外,样本分割虽然保证了理论性质,但也减少了用于计算检验统计量的样本量,在小样本场景下可能削弱检验效力。如何在保持理论保证的同时更高效地利用数据,是一个值得探索的方向。
该方法为条件分布检验提供了一个新范式:将生成模型从“数据生成工具”转变为“统计推断组件”。随着生成模型能力的持续提升,这一思路有望在因果推断和模型诊断等下游任务中发挥更大作用。
相合性(consistency)指当样本量趋于无穷时,估计量依概率收敛到真实参数或真实函数。在本文语境中,它要求生成模型学到的条件分布 \hat{P}(Y|X) 随样本量增加而趋近真实条件分布 P(Y|X),但并不规定以多快的速度趋近。相比“收敛速率”条件,相合性是一个更弱的渐近要求,这使本文的理论结果能覆盖扩散模型、条件 GAN、条件 VAE 等难以给出显式收敛速率的现代生成模型。然而,相合性本身是渐近性质,并不保证有限样本下的表现。当数据稀缺或 P(Y|X) 结构极度复杂时,生成模型可能远未达到实用意义上的近似,从而影响检验可靠性。此外,相合性通常是在特定假设下证明的,例如模型容量随样本量增长、优化算法能找到全局或足够好的解,这些在深度生成模型的实际训练中不一定成立,因此理论宽松不等于实际无条件适用。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。