用Supabase向量库搭建FAQ知识库:n8n自动问答实战

用 n8n + Google Sheets + Supabase + OpenAI,自动化构建可语义检索的 FAQ 知识库
本文拆解了一个基于 n8n 的 RAG 知识库构建方案:以 Google Sheets 作为 FAQ 数据源,通过定时触发节点每 10 分钟同步一次数据;在 Supabase(PostgreSQL + pgvector)中建立包含 embedding、content、metadata 字段的向量表;借助 OpenAI Embedding 节点将文本转化为向量,再经 Default Data Loader 按问答 JSON 格式写入数据库。建表 SQL 可能因版本差异报错,可借助 AI 工具调试。整套流程实现了知识库维护的全自动化——内容运营只需在表格中更新 FAQ,入库由工作流完成。本文为系列第一部分,仅覆盖知识库构建;问答检索与响应生成将在第二部分实现。
构建一个能自动回答客户问题的系统,核心在于一个高质量、可检索的知识库。本文基于一个 YouTube 教程,拆解如何用 n8n 工作流把 FAQ 数据加载进 Supabase 向量库,为后续的智能问答自动化打下基础。这是整套方案的第一部分——先把知识库建好,再谈如何调用它。
为什么选择 Supabase 作为向量存储
向量库(Vector Store)的作用,是把文本转化为向量后存储,当用户提问时,系统能根据语义相似度检索出最相关的答案,而非简单的关键词匹配。这正是现代问答自动化区别于传统 FAQ 页面的关键。
教程作者选择 Supabase 作为向量存储平台,理由是它在 AI 自动化场景中已经相当成熟,且基于 PostgreSQL,支持 pgvector 扩展,能直接在数据库里完成向量检索。相比自建向量数据库,Supabase 降低了部署与维护成本,对个人开发者和小团队尤其友好。
整个自动化被拆成两部分:第一部分(本文)聚焦如何在 Supabase 中构建知识库,第二部分则讲解如何在问答流程中调用这个知识库。先把地基打牢,是作者反复强调的思路。
pgvector 是 PostgreSQL 的开源扩展,专门用于存储和检索高维向量数据。它支持精确最近邻搜索(Exact KNN)与近似最近邻搜索(ANN),并提供余弦相似度、欧氏距离等多种距离算法。由于 pgvector 直接运行在 PostgreSQL 内部,开发者无需引入 Pinecone、Weaviate 等独立向量数据库服务,就能在同一数据库中同时管理结构化业务数据与向量数据,大幅降低了系统架构的复杂度。Supabase 默认预装了 pgvector 扩展,并提供可视化的 SQL 编辑器和托管基础设施,使这套能力开箱即用。
工作流的触发与数据源
在 n8n 中新建工作流后,第一步是添加一个 Schedule(定时触发)节点。教程中设置为每 10 分钟触发一次,意味着工作流会周期性地检查数据源并同步到知识库。这种定时同步的设计,适合 FAQ 内容会持续更新的场景。
紧接着添加 Google Sheets 的 Get Rows 节点。这里把 Google 表格当作知识库的原始数据源——每一行是一条问答记录。作者在表格中预置了 5 条问答数据,运行节点后即可把这些行读取进工作流。
用表格做数据源的好处很明显:非技术人员也能直接在熟悉的 Google Sheets 里维护 FAQ,无需碰代码,工作流会自动把更新同步进向量库。
在 Supabase 中准备数据表与 SQL
要让 Supabase 承载向量数据,需要先在其 SQL 编辑器中执行建表脚本。教程中这一步出现了真实的踩坑:作者第一次运行的 SQL 直接执行失败,于是他借助 Claude AI 重新生成了一段可用的 SQL,再分两次执行,最终成功创建出名为 client knowledge base 的数据表。
这张表包含了向量库必需的字段:id、content、metadata、embedding 等。其中 embedding 列用于存储文本向量,metadata 存储附加信息,content 保存原始文本。这套结构是 Supabase 向量库的标准范式,也是后续语义检索能够工作的前提。
这里值得提醒的是:直接复制网络上的 SQL 脚本未必能跑通,不同 Supabase 项目版本、pgvector 扩展是否启用都会影响结果。遇到报错时,借助 AI 工具快速调试,或从教程提供的现成脚本入手,是更稳妥的做法。
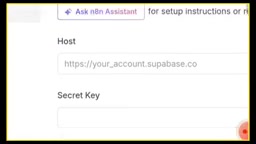
连接 Supabase 与配置 API 凭证
建表完成后,需要在 n8n 中建立与 Supabase 的连接。关键在于两个凭证:
- Host(主机地址):从 Supabase 项目的 Data API 设置页复制,注意要去掉地址中多余的协议前缀部分,只保留实际的 host。
- API Secret / Key:从项目设置中复制 service 密钥,粘贴到 n8n 的凭证配置中。
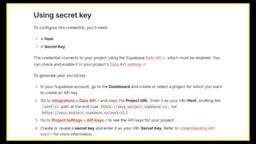
配置完成并保存后,连接即建立成功。作者建议给这个凭证起一个便于记忆的名字,因为后续第二部分的问答流程还会复用它。连接完成后,在向量库节点中选择此前创建的 client knowledge base 表作为目标。
嵌入模型与数据加载
要把文本写入向量库,必须经过**嵌入(Embedding)**处理。教程中接入了 OpenAI 的 Embedding 节点来生成向量——这是整个流程中不可或缺的一环,没有嵌入,文本就无法转化为可供语义检索的向量。
除了嵌入节点,还需要配置 Default Data Loader(默认数据加载器)。作者在其中加载两类数据:先以 JSON 格式组织,再按问答结构(Question & Answer)映射字段,让 FAQ 数据以规范格式写入 Supabase。
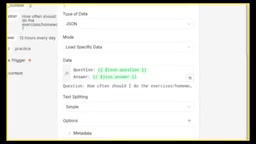
运行工作流后,回到 Supabase 查看 client knowledge base 表,可以看到所有 FAQ 数据已连同向量一起成功写入。至此,知识库构建自动化就完整跑通了——定时从 Google Sheets 读取问答,经 OpenAI 嵌入,最终存入 Supabase 向量库。
嵌入(Embedding)是将文本映射为高维稠密向量的过程。以 OpenAI 的 text-embedding-ada-002 或 text-embedding-3-small 模型为例,每段文本会被转化为一个 1536 维的浮点数数组。语义相近的文本在向量空间中距离更近,这正是语义检索优于关键词匹配的根本原因——即使用户提问的措辞与 FAQ 原文完全不同,只要语义相似,系统仍能找到最相关的答案。值得注意的是,嵌入模型的选择要与检索时保持一致:入库时用哪个模型生成向量,查询时就必须用同一模型将问题也转化为向量,才能在同一坐标空间内进行有效的相似度计算。
小结与下一步
这套流程的价值在于把知识库维护「自动化」:内容运营只需在 Google Sheets 中更新 FAQ,n8n 定时任务会自动完成嵌入与入库,无需人工干预。作者坦言这是他频道中「最难」的一个自动化,强调要对每个环节——尤其是 SQL 部分——理解到位。
需要注意的是,本文只覆盖了知识库的构建。真正的问答能力(客户提问 → 向量检索相关答案 → 返回响应)将在系列的第二部分实现。想要完整落地的读者,建议先把这一部分的数据管道跑通,再接入检索与问答逻辑。
对于想入门 RAG(检索增强生成)类应用的开发者,这个教程提供了一条低门槛路径:n8n 负责编排、Google Sheets 做数据源、Supabase 存向量、OpenAI 做嵌入,各组件职责清晰,可复制性强。
RAG(Retrieval-Augmented Generation,检索增强生成)是目前构建知识问答系统的主流范式。其核心思路是:不依赖大语言模型在训练阶段记住的知识,而是在推理时先从外部知识库中检索与问题最相关的文本片段,再将这些片段作为上下文(Context)拼入提示词,由模型基于真实资料生成回答。这种方式有效缓解了模型"幻觉"问题,同时让知识库可以独立于模型进行更新,无需重新训练。本文构建的 Supabase 向量库,正是 RAG 流程中"检索"环节的基础设施;第二部分将在此之上实现"生成"环节——把检索到的 FAQ 内容喂给语言模型,最终输出面向用户的完整答复。
相关推荐

AI模拟数千个台风季,重塑热带气旋风险评估
AXA与NVIDIA Earth-2利用AI生成超过一千个模拟气旋赛季,突破46年历史数据的稀疏局限,为热带气旋风险评估和保险定价提供更丰富的概率视角。

JetBrains孵化ThinkRail:基于Pi的智能体IDE,规格驱动开发新体验
JetBrains Innovation Hub孵化的开源智能体IDE ThinkRail,基于Pi构建,支持规格驱动开发、Git worktree并行工作区与Monaco编辑器交互,完全免费。本文详解其安装、工作流与生态整合。

主流世界之外:被忽视地区的安全与隐私困境
人本安全研究长期集中于西方,导致安全方案在主流世界失效。研究者Collins Minando基于肯尼亚移动贷款应用、网吧认证困境及九国本地专家研究,揭示社会经济约束如何重塑隐私实践,并提出移动货币隐私重设计与PETs部署路径。