用TabPFN预测空气质量:公开预注册的「诚实失败」实验

开发者用开源TabPFN在笔记本CPU上预测伊斯兰堡逐小时空气质量,并以预注册机制强制公开首日完全排反的失败结果。
巴基斯坦开发者构建了开源项目 Clear Hour,用 TabPFN v2 在本地 CPU 上校正政府 CAMS 大气模型对伊斯兰堡的系统性偏差,为用户推荐明天最值得出门的两小时窗口。项目的核心方法论是「预注册」:每天的预测必须在当天开始前提交 Git 锁死,事后由独立脚本用真实传感器数据打分,无法篡改。首个被真实检验的日子,三个模型的 Spearman 相关系数全为负值——它们把全天清洁度排序完全排反了,原始 CAMS 甚至建议用户在全天第二脏的凌晨 5 点出门。30 天严格评测显示 TabPFN 误差最低,但排序优势统计上不显著,且需约 6–15 周数据才能胜过一行算术基线。项目的可复制性由全链路开源保障,TabPFN 权重开放使跨城市推广的边际成本仅为 CPU 时间,但作者也因许可证细节疏忽被迫事后补署名。文章将失败结果、置信区间与「优势不显著」等负面结论一并公开,使诚实本身成为项目最具说服力的方法论特征。
一位身处巴基斯坦伊斯兰堡的开发者做了一件在技术博客里罕见的事:她在每一天开始之前,就把当天逐小时的空气质量预测提交到 Git,锁死文件、不再修改;等这一天结束后,再用真实传感器数据公开打分,无论结果好看与否。
这个名为 Clear Hour 的开源项目,核心用的是 Prior Labs 的开源表格基础模型 TabPFN v2,完全跑在笔记本 CPU 上。而作者在文章开头就亮出了最尴尬的结论:在第一个被真实数据检验的日子里,包括 TabPFN 在内的三个模型,把一天 24 小时的清洁度排序排反了。
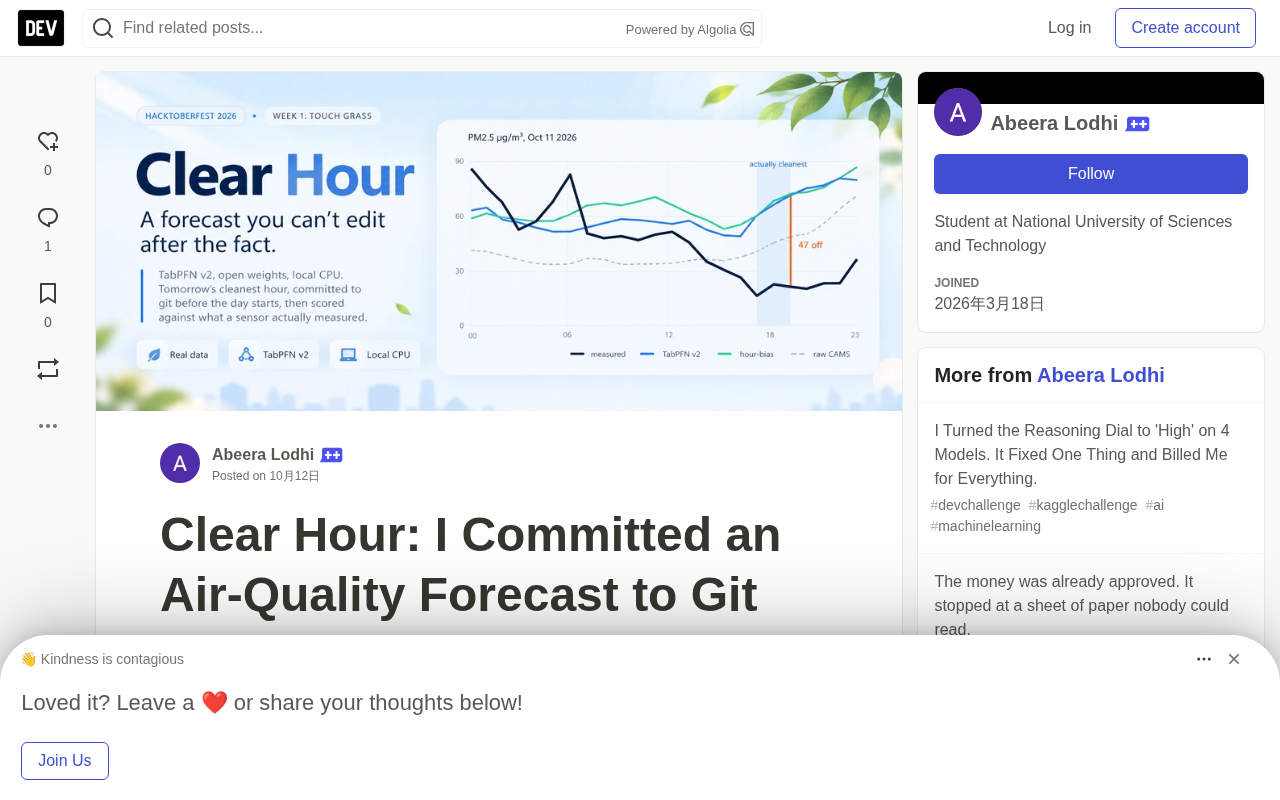
一个值得解决的真实问题
「出门走走」在大多数地方是好建议,但在伊斯兰堡,每年十月雾霾降临后,这件事要打个问号。作者指出,当地的空气质量 App 只给「今天的数字」——一个已经过时、把一天内 4 倍波动压缩成单一颜色徽章的数值。
Clear Hour 的做法不同:它对明天完整的 24 小时按空气清洁度从好到坏排序,挑出值得出门的两小时窗口,以及最该避开的时段。
真正的纪律在于时间顺序。回溯式地在一个「碰巧表现好」的日子跑预测、再写文章吹嘘,这太容易了。所以作者设下铁律:某一天的预测必须在那天开始前提交到 Git,之后永不触碰该文件。 当天结束后,由独立脚本拉取真实测量值打分,好看难看都如实呈现。
诚实的结果:预测排序完全反了
被检验那天传感器的全天均值为 45.4 µg/m³,真实最干净的两小时是傍晚 17:00–19:00(20.9 µg/m³),最糟的是午夜(79.2 µg/m³)。
三个模型的表现如下:
| 模型 | MAE | 偏差 | Spearman (24h) | 选出的最清洁 2h | 实际数值 |
|---|---|---|---|---|---|
| B0 原始 CAMS | 21.9 | −3.5 | −0.512 | 05:00–07:00 | 73.7 |
| M1 TabPFN v2 | 21.9 | +14.6 | −0.369 | 15:00–17:00 | 29.8 |
| B2 CAMS+小时偏差 | 25.3 | +18.8 | −0.409 | 15:00–17:00 | 29.8 |
Spearman 列全为负值,意味着模型给出的排序与现实完全相反——它认为更干净的时段,实际上反而更脏。原始 CAMS 犯了对人最致命的错误:它建议你凌晨 5 点出门,而那恰是全天第二脏的两小时窗口。TabPFN 和 B2 至少选了低于均值的时段,但都错过真实窗口两小时,并严重低估了傍晚空气会变得多干净。
作者坦言:「在这个项目唯一一个被现实检验过的日子里,它把小时排反了。」但她也强调,这不是对 TabPFN 的最终判决——一天只是一个样本,明天表现好也同样不能证明模型可靠。真正的证据在后面的 30 天留出评测里。
技术栈:全部开源、全部可审计
整条流水线由三样免费开源的组件构成:
- 空气质量预测:Open-Meteo 提供的 CAMS 全球模型,逐小时 PM2.5;
- 气象预测:Open-Meteo 的边界层高度、风、湿度、温度、降水——这些特征能解释 CAMS「为什么错」;
- 地面真值:OpenAQ v3 的真实传感器,距 CAMS 网格点 5.2 公里。
CAMS 本身是严肃的大气模型,但在这个特定地点它是可预测地错的:相对参考监测仪,它平均低读 18.9 µg/m³,且误差强烈依赖小时和季节——10 至 12 月它对早 9 点峰值的误差可达 90 µg/m³。这种结构化、重复出现的误差,正是表格模型可以学习的东西。
三个模型并列展示,弱基线不被悄悄丢弃
每张预测卡片同时展示三个模型:原始 CAMS(控制组)、CAMS 加逐小时偏差校正(刻意只有一行的基线),以及本地 CPU 运行的 TabPFN v2。
TabPFN 的调用极其克制——不微调、不做超参搜索、不走托管 API。关键参数是 ignore_pretraining_limits=True:TabPFN v2 默认拒绝超过约 1,000 行训练数据,而推到 10,000 行也正是单次拟合要 30–90 分钟而非几秒的原因。首次拟合在作者的笔记本上耗时 3,351 秒(56 分钟),拟合后缓存到磁盘(10,000 行约 6.3 GB),重跑约 2 分钟即可重载。
CAMS(哥白尼大气监测服务) 是欧盟哥白尼计划下由欧洲中期天气预报中心(ECMWF)运营的全球大气成分预测系统,提供包括 PM2.5、PM10、臭氧、二氧化氮在内的逐小时全球网格数据,空间分辨率约 40 公里,免费对外开放。由于网格分辨率限制,CAMS 无法捕捉城市内部因地形、交通、燃煤取暖等造成的局地浓度差异,在南亚等监测基础设施稀疏的地区,其系统性偏差往往更大且具有明显的时段规律性。这种「可预测的错误」正是后处理校正模型的切入点——模型不需要理解大气物理,只需学习偏差与小时、季节、气象条件之间的统计关联,就能将全球模型的粗粒度输出修正为本地化预测。Open-Meteo 则是一个开源气象 API 项目,将 CAMS、ICON、GFS 等多套公共模型的输出整合为统一接口,无需注册或 API 密钥即可使用,这对缺乏机构资源的独立开发者而言消除了一道关键门槛。
当「预注册」撞上 56 分钟的拟合
一次长达一小时的拟合,显然塞不进「当天开始前提交」的理想时间窗。作者没有造假,而是把 10 月 11 日的预测分成两个明确标注的阶段提交:
- 本地 06:10:46:B0 和 B2 从即时抓取的数据提交;
- 本地 06:51:41:TabPFN 基于同一份内存中的特征矩阵提交,不重新抓取。
卡片直白写明:06:51 之前的小时已经发生,不计入 TabPFN 的预注册。打分脚本则同时报告全天结果和一个「≥07:00」的独立视图,只用真正还在未来的小时重新推导每个模型的窗口。作者的态度很鲜明:「一个带诚实注解的、丑陋的两阶段提交,胜过一个暗示 56 分钟模型在午夜就跑完的漂亮故事。」
打分脚本只读取冻结的预测、只写新文件,CLI 层面也用 --force 机制禁止覆写已存在的预注册文件——数字无法事后被人(包括作者本人)悄悄调整。
「预注册(pre-registration)」源自学术科研实践,指研究者在收集数据或观察结果之前,将研究假设、分析方法和评估指标公开记录并锁定,防止事后根据结果反向调整方法论——这种调整在统计学上被称为「p-hacking」或「HARKing(先假设后研究)」。在机器学习领域,对应的问题是研究者在看到测试集结果后反复调整模型或特征,直到指标好看为止,再以单次运行的形式呈现。将预测提交到公开 Git 仓库是将这一学术规范移植到工程实践的具体手段:Git 提交带有加密签名的时间戳,任何人都可以通过提交哈希验证文件在特定时刻的内容,从根本上切断了事后篡改的可能。这也解释了为何「禁止覆写已存在预注册文件」的 CLI 机制如此重要——它让规则在代码层面强制执行,而不依赖作者的自律。
TabPFN 在哪里真的赢,又在哪里输
30 天留出评测:只用一次的测试月
作者采用严格时序切分,并保留一个 30 天的测试月,所有模型只能看它一次,代码层面拒绝第二次测试运行。
| 模型 | MAE | RMSE | 日内 ρ(中位数) | Top-2h 命中率 |
|---|---|---|---|---|
| B0 原始 CAMS | 16.1 | 20.7 | 0.564 | 30% |
| B2 CAMS+小时偏差 | 22.1 | 28.7 | 0.544 | 43% |
| B5 HistGBR | 10.8 | 15.2 | 0.644 | 40% |
| M1 TabPFN v2 | 10.3 | 14.6 | 0.675 | 37% |
TabPFN 的误差最低,相对 B2 的 MAE 优势是扎实的(95% 置信区间 −17.0 到 −6.9)。但它在排序上对 B2 的优势在此样本量下并不显著,而且一个未调参的 HistGBR 在验证月上甚至击败了它。作者说得坦率:「我宁愿印出这三条警告,也不愿只印一个加粗的胜利。」
TabPFN 到底需要多少数据?
这是最值得玩味的发现。通过六折滚动起点学习曲线,作者得出结论:TabPFN v2 大约需要 1,000–2,500 小时训练数据(约 6–15 周),才能在小时排序上追平、进而略胜一条只有一行算术的小时偏差基线。在此之下它更差、也更不稳定(N=100 时排序在各折间摆动 ±0.34)。
对一个以「少样本能力」著称的基础模型来说,「你需要六周数据才能打败一行算术」是个真正有用的负面结果——而这恰恰是黑客松文章通常会掩埋的东西。
另一个意外收获:作者在一个传感器上训练的校正,完全不重训地应用到城市里另一个距 CAMS 点约 5 公里的传感器上,依然奏效(TabPFN MAE 16.8 / ρ 0.661,远好于原始 CAMS 的 27.5 / 0.570)。这种跨传感器迁移能力,对项目的推广意义重大。
Spearman 等级相关系数(ρ) 衡量的是两组排序之间的单调一致性,取值范围为 −1 到 +1:+1 表示排序完全一致,0 表示无关,−1 表示完全相反。在空气质量窗口推荐这一任务里,用户关心的不是绝对浓度数值的精度(MAE/RMSE 衡量的东西),而是模型能否正确判断「A 时段比 B 时段更干净」——这正是 Spearman ρ 所捕捉的信息。第一个真实检验日三个模型的 ρ 均为负值(约 −0.4 到 −0.5),意味着模型的排序判断比随机猜测还要差,其推荐的「最清洁时段」实际上是当天污染较重的时段。滚动起点学习曲线(rolling-origin learning curve) 是时间序列场景下评估数据量与性能关系的标准方法:通过将训练起点依次后移,得到在不同训练样本量下的多组评估结果,从而在保持时序不泄露的前提下,观察模型性能随数据积累的变化趋势。
TabPFN v2(表格先验拟合网络 v2) 是 Prior Labs 开发的表格数据基础模型,其核心思路是通过在海量合成表格数据集上预训练一个 Transformer,使模型在推理时无需梯度更新即可完成贝叶斯风格的后验预测——本质上是把训练数据作为上下文传入网络,类似大语言模型的 in-context learning。这赋予了它在小样本场景下强于传统树模型的归纳偏置,但代价是推理计算量随训练集规模二次增长(Transformer 的注意力复杂度),这正是 10,000 行数据导致单次拟合耗时 56 分钟的根本原因。HistGBR(HistGradientBoostingRegressor) 是 scikit-learn 中基于直方图的梯度提升树实现,与 LightGBM 思路相近,在中等规模表格数据上训练极快且通常无需大量调参即可达到竞争性性能,是评估「更复杂模型是否真的值得」时最自然的比较基线之一。
为什么「开放」在这里是刚需
对这个项目而言,开放不是抽象理念,而是它能存在的全部原因。
根本没有现成产品可买。 巴基斯坦没有公共的逐小时空气质量预测服务,伊斯兰堡唯一的参考级监测仪——美国大使馆 BAM——已停止发布数据,无人接替。没有商业厂商会为拉瓦尔品第建一个小时分辨率的雾霾模型,市场规模撑不起这笔账。如果要有人建,只能是住在当地、用开源组件拼起来的人。
每一层都是开放的,而且每一层都「承重」:CAMS 是公共资助的大气模型,Open-Meteo 让其输出无需企业合同即可查询,OpenAQ 以开放许可聚合传感器数据,而 TabPFN v2 开放权重且能跑在 CPU 上——这一点真正改变了经济账。
作者算得很清楚:如果 TabPFN 是封闭、计量、托管的 API,那 56 分钟的拟合成本会落到每座城市、每个传感器、每次重训上,项目会在帮到任何人之前先死于单位经济学。因为权重开放、推理本地,校正一个新传感器的边际成本只是「别人已有硬件上的 CPU 时间」。结合跨传感器迁移结果,这意味着拉合尔或白沙瓦的人可以克隆仓库、指向自己的 OpenAQ 传感器,无需密钥、无需配额、无需任何人许可,就得到一个可用的预测器。
开放也是诚实可被执行的前提。 预注册的预测只有在陌生人能验证时才有意义——它是一个带时间戳、公开哈希和特征矩阵校验和的 Git 提交。任何人都能确认 10 月 11 日的预测确实在当天 06:10 存在、此后未被编辑。你无法审计一个封闭预测器的历史战绩,只能读它的营销文案。
作者踩过的坑
文章难得地列出了一串「我哪里做错了」,比成功清单更有价值:
- 一个糟糕的算力预算估算器用二次外推误判了大实验的耗时,静默跳过了最大的几次实验——真实成本只有 12–22 分钟;
- 作者原以为 TabPFN v2 权重是纯 Apache-2.0,其实不是——它是 Prior Labs License 1.1,强制要求在权重或其输出出现的任何地方显示「Built with PriorLabs-TabPFN」,她不得不事后在 README、CLI 和演示页补上署名;
- 10 月 11 日预测背后的实时特征矩阵从未写盘或哈希,这是无法交给质疑者审计的缺口(此后每次运行都保存并哈希);
requirements.txt只有作者本人能装,PyTorch CPU 的索引配置导致从干净克隆安装时失败。
「一个开放许可仍然是许可,」作者写道,「『开放』不等于『没有义务』。」
诚实本身才是方法论
Clear Hour 的技术亮点——本地 CPU 跑开源基础模型、校正公共大气模型的结构化偏差、跨传感器零重训迁移——都值得关注。但这个项目真正稀缺的,是它把可验证的诚实写进了架构:预注册、一次性测试月、报告失败、公布置信区间、明说「这个优势不显著」。
正如作者所说,这篇文章里的负面结果之所以被公布,正是因为架构让隐藏它比公布它更难。在一个充斥着精选结果和事后叙事的技术环境里,一个敢于在同一篇文章里公开自己「排反了」的项目,反而建立起了更强的可信度。
相关推荐

黑人觅食者Alexis Nelson:从觅食到出书,快乐零食别死
黑人觅食者Alexis Nikole Nelson做客Talks at Google,分享从童年跟随母亲认识植物到出版食谱书《Happy Snacking, Don't Die!》的旅程,揭示美国觅食兴衰背后的种族与土地历史。

如何有效呈现你的想法:三种揭示式演讲方法
揭示式演讲是传递想法最直接的方式。本文解析奇妙漫步、动态演示和梦想图景三种演讲类型,结合David Gayo、Michael Pritchard、Sylvia Earle等经典案例,教你如何有效呈现想法。

Modern Web Guidance:让AI写原生声明式对话弹窗
Google Modern Web Guidance 让 AI 编程助手在生成代码时优先使用浏览器原生声明式 dialog 能力,替代重复的 JavaScript 事件监听,实测可显著减少样板代码。