用 TypeScript 手写 HNSW,实测 efSearch 与召回率权衡

用 TypeScript 手写迷你 HNSW,实测 efSearch 如何决定 RAG 检索召回。
文章从 pgvector 默认 hnsw.ef_search=40 这一事实出发,指出多数 Postgres RAG 应用的检索质量实际由这个很少被改动的参数决定。作者用 TypeScript 在单文件里实现了一个确定性的迷你 HNSW,索引 5 万个随机向量,以暴力检索为基线,在 efSearch 取 10、40、100、200 时对比 recall@10,并解释分层、贪心下降、束搜索三个核心机制,以及邻域启发式为何是图可导航性的关键。文章进一步说明如何解读实测数字:随机均匀向量是最差情形,真实嵌入有结构所以召回更高;暴力检索是精确基线;pgvector 先索引后过滤会让小束更小;生产环境可用 SET LOCAL 按事务调参,或用 enable_indexscan=off、Qdrant 的 exact 参数建立召回监控。
pgvector 的 README 只用一句话交代了近似索引的代价:加索引就是「用召回换速度」。默认的 hnsw.ef_search 是 40——如果你的 RAG 应用跑在 Postgres 上,而团队里没人改过这个值,那么决定模型能读到哪些 chunk 的就是这个 40。
与其读文档里的描述,不如自己把索引搭出来看它发生。下面这条路线用 TypeScript 写一个迷你 HNSW,在 Node 里索引 5 万个随机向量,然后在 efSearch 取 10、40、100、200 时对比暴力检索测 recall@10。脚本是确定性的(同一份数据每次运行结果一致),短到可以一口气读完。
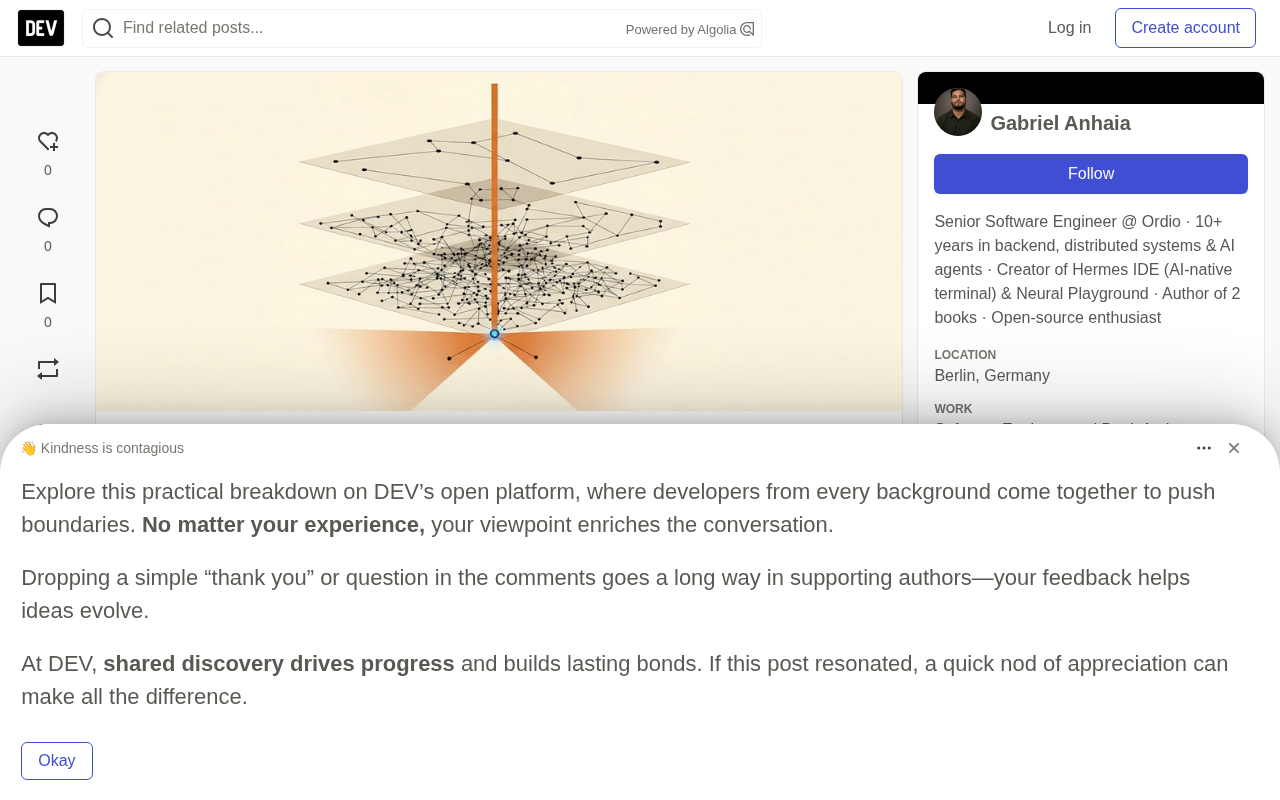
三个核心概念:分层、贪心下降、束搜索
HNSW 出自 Malkov 和 Yashunin 2016 年关于分层可导航小世界图的论文。抛开证明,剩下三个想法。
分层。 每个向量都在第 0 层,随机一小部分同时存在于第 1 层,更少的在第 2 层,以此类推。论文把元素最高层定义为 floor(-ln(uniform) * mL),建议 mL = 1/ln(M),其中 M 是每个节点的链接数。得到的效果类似跳表:稀疏的顶层负责远跳,密集的底层保证精度。
贪心下降。 查询从顶层的一个入口点出发,走向更近的邻居,直到没有更近的为止,然后下降一层重复。上层搜索用 ef = 1:只保留一个候选,纯贪心。
底层用束搜索。 最底层维护一个大小为 ef 的候选列表,不断展开最近的未展开节点,直到最近的未展开候选比列表里最差的节点还远才停止。这个 ef 就是 efSearch。束越宽,探索的图越多,找到的真实邻居越多,距离计算也越多。
HNSW 的全称与定位。 HNSW 是 Hierarchical Navigable Small World 的缩写,即可导航小世界图的分层版本。它的前身 NSW(可导航小世界图)由同一批作者提出,核心观察是:高维向量构造成图后,任意两点之间只需要很少的跳数就能连通,搜索时沿着「离目标更近」的边贪心前进即可快速逼近。但 NSW 在低维或强聚类数据上容易陷入局部最优,HNSW 通过叠加多层稀疏图来解决:上层稀疏、边少、跳距大,承担粗定位;下层稠密、边多、精度高,承担精搜索。这种「多分辨率」思路和跳表、B 树、图像金字塔是同一类设计,也是 HNSW 在向量数据库中占据主流的原因。理解这一点,才能明白为什么 efSearch 只影响底层束搜索的宽度,而不影响上层的贪心路径。
最小实现:从向量生成到插入与搜索
所有代码放一个文件 hnsw.ts,按顺序追加即可。Node 从 v22.18.0 和 v23.6.0 起直接剥离类型运行 .ts 文件,无需构建步骤。代码刻意避开 enum 和参数属性,因为类型剥离不支持这两种语法。
几个关键取舍:用 mulberry32 做带种子的随机数生成器,保证每台机器生成同样的 5 万个向量、两次运行可比;距离用平方 L2,在单位向量上它和余弦相似度的排序一致(|a - b|² = 2 - 2·cos(a, b));用有序数组代替论文里的两个优先队列,几百的束宽下它更慢但可读、正确,这里可读性更重要。
searchLayer 对应论文算法 2,selectNeighbors 对应邻域启发式(算法 4,去掉可选扩展),insert 和 search 对应算法 1 和 5。1 - this.rand() 是为了让对数避开 ln(0),因为生成器可能返回 0 但不会返回 1。search 会把束宽夹到至少 k,和 hnswlib 的参数说明一致:ef「不能设得比查询的近邻数 k 还小」。
邻域启发式是让图保持可导航的关键。直接连最近的 M 个点听起来合理,但在聚类数据里链接会困在各个簇内,搜索卡在簇边界。论文图 7 展示过这一点:简单规则在聚类数据上低召回处停滞,而启发式不会。
hnswlib 与 pgvector 的关系。 文章多次引用 hnswlib 的参数说明,是因为 pgvector 的 HNSW 索引实现参考了 hnswlib 的算法与默认值,但并不是直接嵌入这个库——pgvector 用 C 重写并适配了 Postgres 的存储层。hnswlib 是 Malkov 等人维护的独立 C++ 头文件库,也是很多向量数据库(包括部分版本的 Qdrant、Milvus 的历史实现)的算法原型。因此 hnswlib 文档里对 ef 的表述——越高越准越慢、不能小于 k——基本可以直接迁移到 pgvector 的 hnsw.ef_search 上理解。区别在于 pgvector 把索引参数做成了 GUC 变量和索引选项(WITH (m = 16, ef_construction = 64)),而 hnswlib 是在构建索引和查询时以函数参数传入。
基准测试:recall@10 对比暴力检索
基准用 M = 16、efConstruction = 64 建索引(这是 pgvector 的默认值),用暴力检索算出精确答案,然后扫 efSearch。
超过 5 万次插入、每次都是一次纯 JavaScript 的束搜索、没有 SIMD,建索引是慢的部分。想快点看到第一次结果,可以把 N 降到 10,000。
recall@10 是在 500 个查询上取平均:HNSW 返回的 10 个结果里有多少落在真实的最近 10 个中。计时只包住搜索调用,召回统计不会渗进每次查询的耗时。
这里不印结果表,因为唯一值得相信的数字是你自己机器跑出来的那些。文档能预测的只有方向:pgvector 说 ef_search 越高「召回越好」、代价是速度,hnswlib 说「ef 越高搜索越准越慢」。你的运行会告诉你幅度有多大,以及从 40 到 100 带来的是否多于从 100 到 200。
怎么读你的数字
随机向量是最难的情况。 均匀随机数据没有簇,内在维度接近标称维度。Elliott 和 Clark 的论文把 HNSW 召回和数据的内在维度、插入顺序联系起来,Marqo 关于 HNSW 召回的文章则指出聚类数据「往往比均匀分布数据召回更高」。真实文本嵌入是有结构的,所以把随机数据上的召回当作悲观的底线。可以试试 DIM = 16 和 DIM = 256(后者配更小的 N,因为每次距离计算贵四倍),看同样的 efSearch 换来多么不同的召回。
暴力检索那条线是你的基线。 5 万个向量时精确扫描很便宜,不带索引的 pgvector 做的就是这件事,召回完美。HNSW 在 N 变大后才回本:暴力检索随语料线性增长,而图搜索按论文说法大致是对数级。
过滤会让小束更小。 pgvector 在索引扫描之后才应用 WHERE 过滤。它的 README 直接点明后果:「如果一个条件匹配 10% 的行,在 HNSW 和默认 hnsw.ef_search 为 40 的情况下,平均只有 4 行会匹配。」也就是一个 top-10 查询只返回 4 行。从 0.8.0 起 pgvector 提供迭代索引扫描,会一直扫到凑够通过过滤的行数为止。
在生产里调这个旋钮。 在 Postgres 里它就是一个设置,可以只作用于事务:BEGIN; SET LOCAL hnsw.ef_search = 100; SELECT id FROM chunks ORDER BY embedding <=> $1 LIMIT 10; COMMIT;。在 Qdrant 里按每次搜索传 "params": { "hnsw_ef": 128 },其索引文档说 ef 默认等于 ef_construct 的值,开箱是 100。
两家存储也都允许跳过索引拿精确答案:pgvector 在事务里 SET LOCAL enable_indexscan = off(README 建议用它监控召回),Qdrant 用 "exact": true。这条精确路径就是你在真实数据上自建召回测试的办法:拿几百个真实查询,精确算出一次 top-10,然后对比生产设置返回什么。
迭代索引扫描(iterative index scan)。 这是 pgvector 0.8.0 引入的机制,用来缓解「先索引扫描、后过滤」导致的结果不足。默认模式下,HNSW 按 ef_search 取出固定数量的候选后就停止,再对这批候选应用 WHERE,匹配行不够就返回不足 k 条。开启迭代扫描(SET hnsw.iterative_scan = relaxed_order 或 strict_order)后,pgvector 会在候选耗尽时继续扩大扫描,直到凑够 LIMIT 要求的行数或达到 hnsw.max_scan_tuples 上限。strict_order 保证结果严格按距离有序但稍慢,relaxed_order 允许近似有序、吞吐更高。代价是过滤选择性极低时单次查询会扫描大量图节点,延迟上升,因此它适合「过滤后仍需 top-k」的 RAG 场景,不适合高并发下过滤条件极稀疏的查询。
这个玩具实现省略了什么
真实实现还要补上这个单文件跳过的部分:删除与更新、并发插入、磁盘页存储、量化向量、SIMD 距离核。论文的邻域启发式还有两个可选开关(扩展候选、保留被剪枝的连接),这个版本都没开。
想看启发式为什么存在,可以把生成器换成带簇的向量,把 selectNeighbors 换成直接取最近的 M 个候选的切片,再对比同样 efSearch 下的召回。
相关推荐

GitHub日报·10月23日:Agent运行时与技能库同日爆发

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。