用效率定义智能:当前AI比人类落后6个数量级
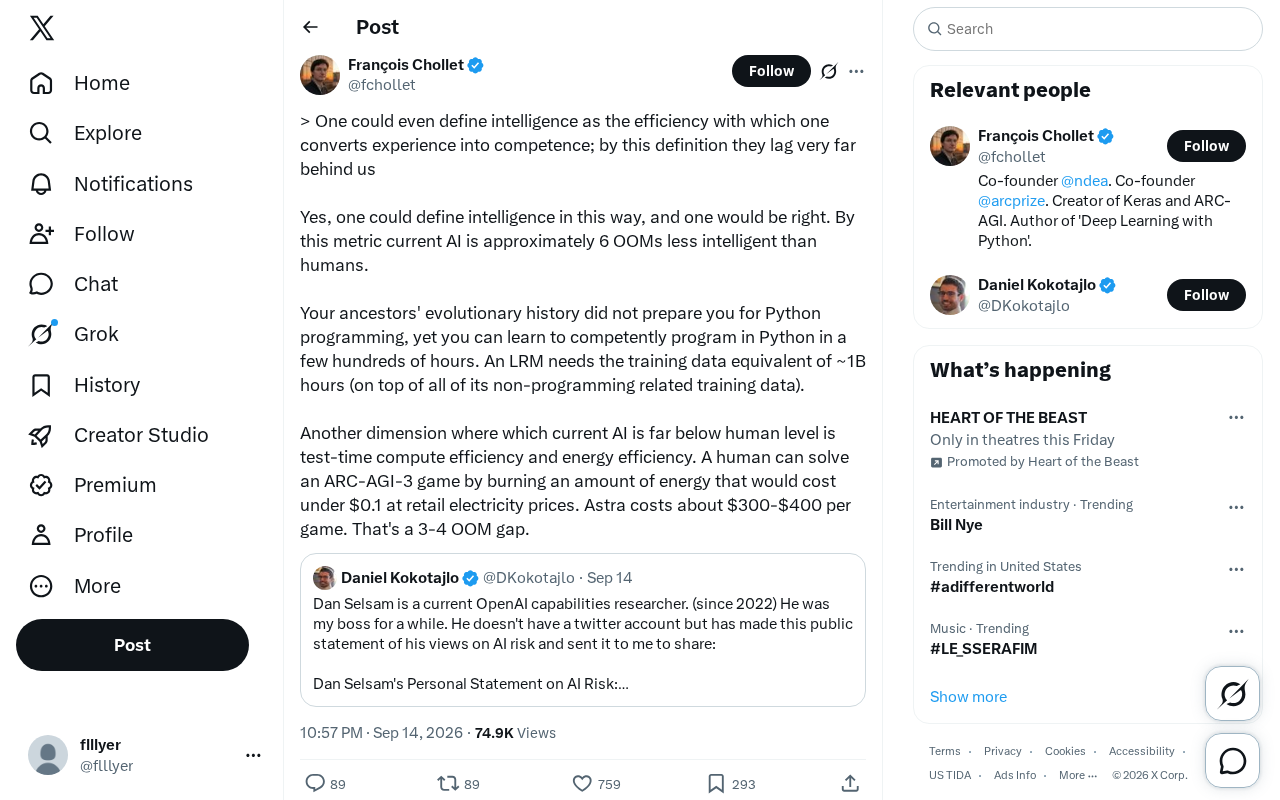
以学习效率和推理能耗衡量,当前AI的"智能效率"比人类落后约6个数量级。
文章提出一种衡量智能的替代标准:智能是将经验转化为能力的效率,而非单纯的最终表现。按此标准,当前AI与人类之间存在约6个数量级的差距,体现在两个维度:学习效率上,人类数百小时可掌握Python编程,而大型推理模型需要相当于约10亿小时的等效训练数据;推理能耗上,人类完成一局ARC-AGI-3的成本不足0.1美元,而Astra系统需耗费300至400美元。文章指出,主流AI评估聚焦于"能否做到",而忽视了"以多大代价做到"这一更本质的维度。真正的智能突破或许不在于扩大模型规模,而在于提升数据效率与能耗效率,让机器以更少的经验和更低的能耗完成更多的任务。
智能的另一种定义:把经验转化为能力的效率
关于「什么是智能」的争论从未停止,但有一个视角越来越受到研究者关注:智能可以被定义为把经验转化为能力的效率。换句话说,衡量智能高低不只看最终能力,而看达成这种能力需要消耗多少经验、算力和能量。
按照这个定义,一位在社交平台上引发讨论的观点认为,当前的AI在效率维度上远远落后于人类——大约落后6个数量级(OOM,orders of magnitude)。这不是一个情绪化的贬低,而是从学习效率与推理成本两个可量化维度得出的结论。
学习效率:人类几百小时 vs. AI十亿小时
第一个巨大的差距体现在数据效率上。
人类的进化史从未为「编写Python代码」做过任何准备——我们的祖先没有面对过编程语言,基因里也没有编译器。然而一个普通人只需要投入几百个小时的学习,就能达到能够胜任编程工作的水平。
相比之下,一个大型推理模型(LRM)要达到类似的编程能力,需要相当于约10亿小时的训练数据——而且这还是建立在它已经吸收了海量与编程无关的其他训练数据的基础之上。
把「几百小时」和「十亿小时」放在一起对比,学习效率的差距一目了然。人类能从极少的样本中快速泛化,而当前的模型仍高度依赖规模化的数据堆叠。这正是「智能=经验转化效率」这一定义下,AI最刺眼的短板。
「数据效率」(data efficiency)和「少样本学习」(few-shot learning)是衡量这一差距的核心概念。人类学习新技能时依赖先验知识的迁移、因果推理和高度压缩的概念表征,能够从极少的示例中快速归纳出可泛化的规则——认知科学将这种能力称为「归纳偏置」(inductive bias)。相比之下,当前主流的大型语言模型和推理模型本质上是统计模式匹配系统,其泛化能力高度依赖训练数据的覆盖密度。所谓「约10亿小时训练数据」并非字面上的单一任务训练时长,而是将模型预训练所消耗的全部token量按人类阅读速度折算得出的等效值,用以直观呈现数据规模的量级差异。这种折算方式本身带有估算性质,但数量级层面的对比结论在研究者中具有相当的共识基础。
推理成本:一局游戏,人类几分钱,AI几百美元
第二个维度是测试时算力效率(test-time compute efficiency)与能量效率,这个差距同样惊人。
以ARC-AGI-3这类推理游戏为例:一个人类玩家完成一局游戏所消耗的能量,按零售电价折算,成本不到0.1美元。而据该观点引用的数据,名为Astra的系统完成同一局游戏,成本高达300到400美元。
这意味着在解决同类问题时,AI与人类之间存在3到4个数量级的成本与能耗差距。人类大脑以约20瓦的功耗完成复杂推理,这种能效至今没有任何AI系统能够接近。
换个角度看,即便未来模型在准确率上追平甚至超越人类,只要单次推理成本仍停留在「几百美元一局」的量级,它在「智能效率」这个定义下依然算不上真正高效的智能体。
ARC-AGI(Abstraction and Reasoning Corpus for Artificial General Intelligence)是由AI研究者François Chollet设计的推理基准测试,旨在衡量系统的抽象推理与泛化能力,而非记忆或模式匹配。每道题呈现少量输入-输出示例,要求系统归纳规律并应用于新样本,刻意规避了可以通过大规模训练数据"背答案"的可能性。ARC-AGI-3是该系列的最新版本,难度进一步提升。由于其设计哲学与"效率定义智能"高度契合——两者都强调从极少样本中泛化的能力——它常被用作衡量AI与人类推理效率差距的参照场景。值得注意的是,人类在ARC-AGI上的平均得分约为85%,而顶尖AI系统直到近年才开始在部分版本上接近这一水平,但所消耗的算力成本与人类相比仍相差悬殊。
为什么这个视角值得重视
主流的AI能力评估往往聚焦于能不能做到——能否通过考试、能否写出代码、能否赢下游戏。而「效率定义智能」提供了一个互补且更苛刻的标尺:用多大代价做到。
这个视角带来几点启发:
- 数据效率是尚未被攻克的核心难题。人类的少样本学习能力,仍是当前架构难以企及的目标。
- 能耗与成本不是工程细节,而是智能的本质指标。真正的通用智能应当是高效的,而非靠无限堆算力换取表现。
- 基准分数不等于智能。当一个系统需要百万倍于人类的数据、数千倍于人类的能量才能完成任务时,「接近人类智能」的说法需要打上折扣。
人类大脑的功耗约为20瓦,全天候运行的年耗电量不足200千瓦时,这一能效水平背后是数亿年演化压力下形成的极度优化的神经计算架构。与此对应的概念是「神经形态计算」(neuromorphic computing),即尝试在硬件层面模拟大脑稀疏激活、事件驱动等机制以大幅降低能耗,代表性项目包括Intel的Loihi芯片和IBM的TrueNorth。当前主流AI训练和推理依赖的GPU/TPU集群功耗动辄达到兆瓦级别,单次大模型推理调用的能耗可能是人类完成同等认知任务的数千倍。因此,能耗差距不仅是经济问题,也是判断一套计算范式是否在架构层面接近"真实智能"的深层指标。
差距之外:留给行业的思考
说一下,「落后6个数量级」是基于特定定义与特定案例(编程学习、ARC-AGI-3游戏)的估算,本身带有讨论性质,并非严格的学术测量结论。不同任务、不同模型的效率差距会有很大波动。
但它确实点出了一个方向性的问题:如果我们真心把智能理解为「经验转化为能力的效率」,那么当前AI的进步更多体现在规模上,而非效率上。未来真正的突破,或许不在于把模型做得更大、喂更多数据,而在于让机器像人一样,用更少的经验、更低的能耗,学会更多的东西。
这也是通往更接近人类智能的关键一步。
相关推荐
2026诺贝尔化学奖解读:手性放大背后的化学革命
2026年诺贝尔化学奖授予亨利·卡根与左右田健次,表彰其在不对称有机合成中发现非线性效应与自催化。本文解读手性分子、不对称催化及63万倍手性放大实验的科学意义。
诺贝尔化学奖得主硖合宪三:手性之谜与生命起源
诺贝尔化学奖得主硖合宪三接受电话采访,谈及其发现的硖合反应如何满足Frank判据、揭示分子手性起源,为地球生命起源这一世纪难题提供关键实验证据。
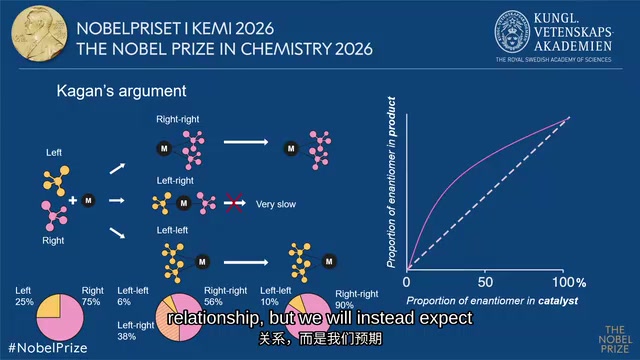
2026诺贝尔化学奖:破解分子手性之谜
2026年诺贝尔化学奖授予亨利·卡根与硕井健三,表彰其在不对称有机合成中发现非线性效应与自催化反应。本文解读手性、放大效应及其对制药与生命起源研究的意义。