用语音让 AI 写代码:博主用 Codex 语音模式边做饭边上线博客新功能

Simon Willison 用语音驱动 AI 代理,在做饭半小时内搭出博客 Newsletters 页面。
Simon Willison 在博客上线 Newsletters 页面,将免费 Substack 周报与赞助者月报集中索引。他使用 ChatGPT 桌面版 Codex 语音模式,一边做晚饭一边口述需求,约半小时内让代理完成了 Django 模型与迁移、四种导入逻辑、公开归档页及站内搜索接入。即使语音转录充满停顿与自我纠正,模型仍能正确理解意图,并自行搜索到 Substack 未公开 API 的分页方法。但涉及私有仓库导入、API key 创建和导入机制选择时,他仍需切回键盘,又花了约半小时打字审查和调整页面细节。Willison 认为语音的真正价值在于多任务,但不会成为日常主力开发方式,未来趋势是语音与键盘混合协作。
Simon Willison 今天为他的博客上线了一个新功能:Newsletters 页面,把免费 Substack 周报和仅限赞助者的月度通讯索引集中在一起。特别之处在于,这个功能几乎完全是用语音完成的——他一边做晚饭,一边对着笔记本电脑说话,让 AI 代理写代码。
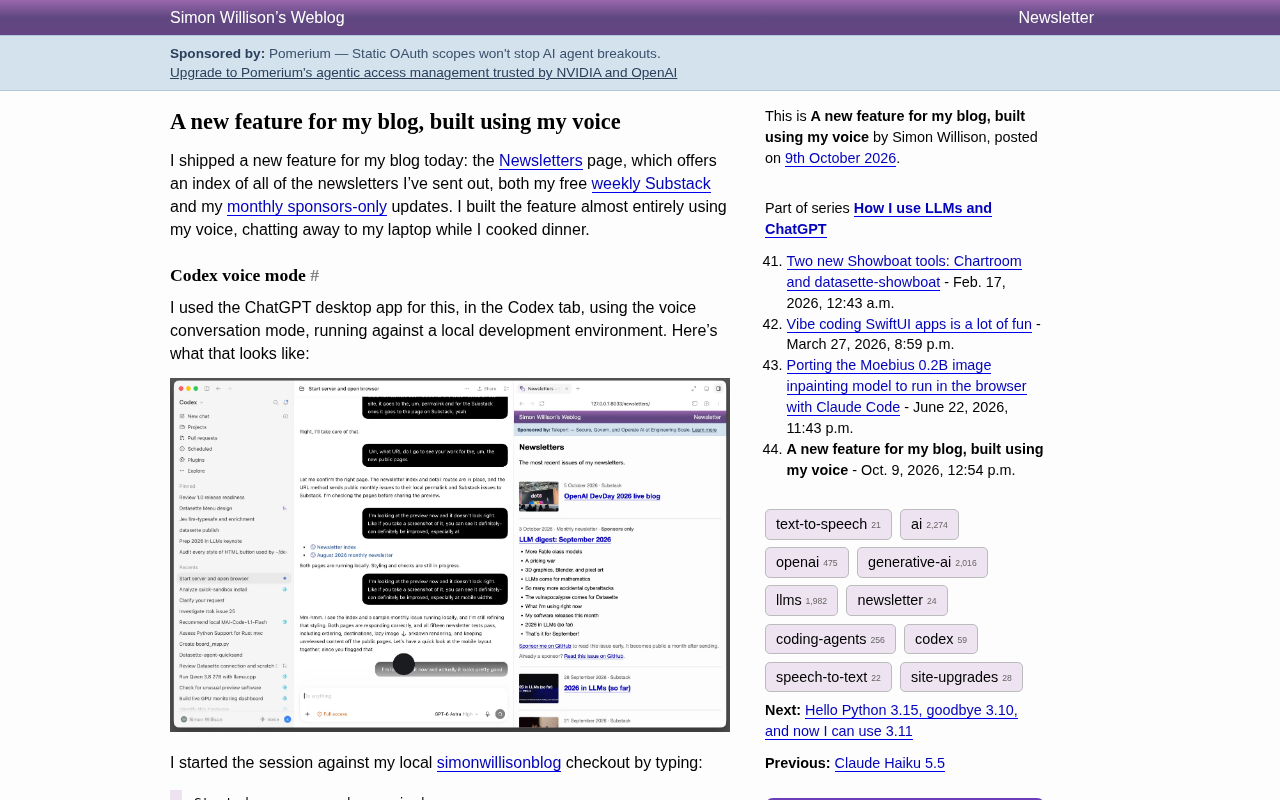
一场厨房里的结对编程
Willison 使用的是 ChatGPT 桌面应用 Codex 标签页里的语音对话模式,运行在本地开发环境上。整个流程并不复杂:先让代理「启动开发服务器并在浏览器打开」,这样他就能在右侧看到本地博客预览,随时用眼睛追踪进度。然后点击「Start new voice chat」按钮(不是麦克风按钮,是它右边那个),把笔记本搬到厨房,开始边做饭边聊需求。
他描述需求的方式非常口语化,甚至带着大量语气词和中断。比如在解释新内容类型时,他说:
「嗯,它们不会……这是个新内容类型。嗯,它不会出现在……哦等等。对,不——我不希望它出现在我的标签页和日期归档页里……实际上,不,我想……我不希望它在标签页上。我不希望它在博客首页。但我觉得我确实希望它出现在基于日期的页面上。你知道,如果你导航到 9 月 19 日,而我在那天发了一份通讯,我希望它能显示出来。所以……我觉得我们可能需要一个新模型。」
据 Willison 事后复盘,这段充满自我纠正和停顿的口语竟然被模型正确理解了。完整转录(包括所有不流畅之处)被他放进了 Gist。这样的对话持续了大约半小时,正好是做一顿饭的时间。
Codex 的语音模式指的是 OpenAI 在 ChatGPT 桌面客户端中提供的实时语音对话能力,用户可以通过自然语言与模型连续交互,模型则同步执行代码生成、文件操作等任务。与传统「输入 prompt—等待输出」的回合制方式不同,语音对话允许边说边改,模型会维护上下文并根据口头修正调整方案。Willison 使用的正是这一模式,并将其与本地开发服务器相连,使代理的每一次代码改动都能立即反映在浏览器预览中。这种「语音+可视化反馈」的组合,是本次实验能够顺利推进的关键前提——没有预览,口头描述代码效果几乎无法验证。
语音模式一口气搭出了什么
让 Willison 意外的是,纯语音推进的进度相当可观。半小时内,代理完成了:
- 新建 Django 模型和迁移,用于表示导入的通讯内容,并配置了 Admin 后台
- 四个可用的导入逻辑:通过 RSS 拉取最新 Substack 条目;通过 Substack 未公开的 API 拉取其余历史条目;从 GitHub 仓库导入已发布的月度通讯;从私有仓库导入最近一份仅限赞助者的通讯
- 上线
/newsletters/和按年份归档的公开页面 - 让通讯出现在日期和月份归档页,但不出现在标签页或首页
- 周报链接回 Substack,归档的月度通讯拥有自己的独立页面
- 接入站内搜索
其中 Substack 的未公开 API 值得一提。模型直接尝试了 /api/v1/archive 端点,随后通过搜索找到了分页方法,还引用了一篇由 Karen Spinner 撰写的技术文章。这说明当前代码代理已经具备一定的「遇到未知接口就自己查」的能力。
Substack 的未公开 API 指 Substack 平台未在官方文档中公开、但被前端页面实际调用的接口端点,例如 /api/v1/archive 用于按时间分页获取某个出版物的历史帖子。这类接口通常通过抓包或社区逆向工程被发现,稳定性无保障,但在缺乏官方 API 的情况下是批量获取历史内容的常用手段。Willison 的代理在遇到该接口后,自主搜索到了分页参数,并引用了一篇第三方技术文章来确认用法。这一细节表明,现代代码代理已具备一定程度的「接口勘探」能力:面对未知服务,它们不再只能报错,而是会尝试搜索、推断并验证可用的调用方式。
语音的边界:导入与审查仍需键盘
几乎完成不代表完全完成。剩下的问题出在导入环节。模型提议从本地导出数据、再导入生产环境,但 Willison 希望导入方式和他其他脚本保持一致。由于部分数据位于私有 GitHub 仓库,这需要创建新的 API key——这类操作必须坐在键盘前完成。
于是他让 Codex 创建分支并打开 Pull Request,转到 GitHub PR 界面做代码审查。审查中他发现一个问题:代理选择用 subprocess 调 Git 的方式来做导入,而他更倾向走 API。切回键盘后,他让 Codex 把这段替换掉,又花了大约半小时打字调整公开页面的展示细节,才最终合并部署。
Willison 把审查期间的额外提交都留在了 PR 里,可以看到他对导入机制和页面显示做了几处修正。
Pull Request(PR) 是 GitHub 等代码托管平台上的协作机制:开发者将改动推送到独立分支后,发起合并请求,其他人可在网页界面逐行审查 diff、评论并决定是否合并。Willison 让 Codex 自动创建分支并打开 PR,随后自己转到 GitHub 界面做代码审查,正是利用了这一机制将「AI 生成」与「人类把关」分离。审查中发现代理选择用 subprocess 调用 Git 命令行来做导入,而他更倾向直接走 API——这类架构选择需要理解项目长期维护成本,往往超出语音交互能有效表达的粒度,因此必须回到键盘上完成修正。
最终上线的 Newsletters 页面
新的 Newsletters 索引页 把最近的 Substack 周报和 GitHub 赞助者月报按时间倒序混排,下方是按年份归档的链接。页面设计由模型完成,并根据 Willison 在厨房里隔着距离瞥一眼本地预览后给出的口头反馈做了调整。

该页面的结构相对克制:最近内容优先,归档往下收,订阅入口放在右侧。这种布局对内容型博客来说足够清晰。
多任务利器,但还不是日常主力
OpenAI 显然喜欢在 DevDay 这类场合展示语音驱动开发的演示,效果也确实不错。但 Willison 明确表示,这不会成为他的日常主力工作方式。
他此前写过自己遛狗时用手机 ChatGPT 语音模式做研究、头脑风暴,偶尔也让 AI 写点代码片段。但这次体验不同:加入了可视化预览,以及随时可以切回键盘粘贴内容,让语音交互对编码代理来说实用得多。
不过一旦进入细节,他还是会切回打字。粘贴示例、错误信息,或者直接高亮需要修改的代码,仍然比用语言描述更高效。他也提到,自己主要在家工作,所以可以这样跟电脑说话;在共享办公空间里绝对做不出来。
对他而言,真正的杀手级特性是多任务——平时做饭会放播客或 TikTok,现在可以顺便把东西做出来。
对开发者的启示
这次实践揭示了当前语音编码代理的几个现实特征。语音适合在需求模糊、结构清晰的早期阶段快速推进,视觉预览能显著提升口头反馈的准确度,而不流畅的口语输入对现代模型已经不构成理解障碍。
但涉及密钥管理、私有仓库访问、接口方案选择这类需要精确上下文的环节,键盘仍然不可替代。语音与打字的切换不是退步,而是当前阶段最务实的协作方式。
对想要尝试的开发者来说,门槛并不高:一个本地开发服务器、一个支持语音对话的代理界面,以及一段相对完整、不被频繁打断的时间——比如做一顿饭的工夫。
相关推荐

Cursor AI编程实战:30分钟从零构建学生管理系统
B站UP主实战演示Cursor AI编程:30分钟用自然语言生成学生管理系统。详解Agent模式、Claude模型选择、提示词技巧与使用门槛,帮你判断Cursor是否值得入手。

AI编程工具20强榜单:从夯到拉的评分矩阵
B站UP主发布AI编程工具20强榜单,从夯到拉分为T0-T4五个层级,Claude Code和Codex并列T0。本文详解评分维度(能力、可靠性、耐操性、耐久性、成本、国内可用性)及工具表现,帮助开发者选择适合的AI编程助手。

Vibe Coding系统教程:零基础玩转AI编程实战
B站UP主耗时三个月打造的Vibe Coding系统教程,覆盖Codex、ClaudeCode、Cursor等AI编程工具,从基础逻辑到商业级项目实战三段式讲解,适合零基础学习者系统入门AI编程。