用自然语言查询Google Sheets:n8n模板实战

n8n 模板 7639 用五节点 AI agent 让团队用大白话查询 Google Sheets,只读、低成本、八分钟可搭。
本文介绍 n8n 模板库第 7639 号工作流,它在 Google Sheets 前加了一个聊天框,让团队成员用平实英语直接提问客户名单、续约时间等问题,无需筛选、公式或等同事回复。工作流仅五个节点:聊天触发器、AI agent、OpenAI 模型、记忆节点和只读的 Google Sheets 工具。设置只需连接 OpenAI 和表格两步,约八分钟完成,使用 gpt-4.1-nano 成本极低且 agent 只读,风险可控。作者特别提醒语言模型算术不可靠,实测中 6,200 的总数被误报为 5,200,金额类总数必须人工核对。计数和列表类问题是 AI agent 的甜蜜点,适合从被问最多的表开始实践。
中小型团队几乎都有一张关键 spreadsheet:客户名单、项目进度或订单表。所有答案都在里面,但要把答案取出来,却往往需要打开表格、筛选、排序,甚至做透视表。n8n 模板库中有一个热门工作流,把聊天框放在 Google Sheets 前面,让团队成员用大白话直接提问。
问题:答案就在表里,但取出来要花15分钟
想象周一早会,合伙人问:“哪些客户有风险?”“谁在11月续约?”总得有人打开表格、筛选、排序,可能还要建透视表,再把结果贴到聊天里。客户经理每周要重复十几次。提问的人往往最不熟悉筛选菜单,于是要么等别人回复,要么凭记忆做决定。
真正的成本不是表格本身,而是围绕它的打断。每个“快速问题”都会把一个人从工作中拉出来,而且等答案到达时已经过时了。
变化:像问同事一样问表格
n8n 模板库第 7639 号模板在 Google Sheet 前面放了一个聊天框。你用平实英语输入问题,AI agent 读取行数据,几秒内给出答案。在用于教学的客户名单中,以下问题效果良好:
- “哪些客户处于 At Risk?”返回 Northwind Insurance 和 Riverbend Accounting。
- “哪些客户在11月续约?”返回 Atlas Logistics Co 和 Northwind Insurance。
- 追问“这两个中哪个有风险?”也能工作,因为模板包含记忆节点,能记住对话。
无需筛选、无需公式、无需等同事。合伙人提问,表格回答。
n8n 模板 7639 中的 AI agent 是一个工具调用型 agent。 所谓工具调用(Tool Calling),是指大语言模型在生成回答时,可以主动决定调用某个外部函数或数据源,并把返回结果纳入自己的推理。在这个工作流里,Google Sheets 的 Get Row(s) 操作被注册为一个名为 Analyze Data 的工具,agent 看到用户问“哪些客户处于 At Risk”时,会先判断需要读取表格,再发起一次 Get Row(s) 调用,拿到行数据后再组织自然语言答案。
这一点很关键:模型本身并不“知道”表格内容,它只是在需要时去查。因此 agent 的能力边界由你给它挂了多少工具决定。模板只挂了只读的 Get Row(s),所以它只能查、不能改。如果把 Append、Update 等写操作也挂成工具,agent 同样会调用,风险随之上升。
它是如何搭建的(五个节点)
该模板共有五个工作节点:
- Chat with Your Data — 聊天触发器,接收你的消息。
- Talk to Your Data — AI agent,决定如何处理问题。
- OpenAI Chat Model — agent 思考所用的大脑。
- Memory — 保存对话,让追问有意义。
- Analyze Data — 设为 Get Row(s) 的 Google Sheets 工具,agent 借此读取表格。
注意 Analyze Data 只读。该模板中的 agent 无法修改你的表格,这正是首次在真实客户数据上部署时想要的效果。
Memory 节点在 n8n 中用于在多次对话轮次之间保存上下文。没有它,每一轮提问都是孤立的,agent 无法理解“这两个中哪个有风险?”里的“这两个”指什么。Memory 通常按会话 ID(session ID)分区存储,聊天触发器会为每个对话分配一个标识,因此不同用户的追问不会互相串台。
需要留意的是,Memory 只保存对话历史,不保存表格数据。每次提问时,agent 仍然要重新调用 Get Row(s) 去读表,所以表格里的最新数据总能被看到,但上下文窗口会被历史消息占用。如果对话很长,可以配置只保留最近若干轮,避免提示词膨胀导致成本和延迟上升。
设置阶段:两个连接
模板无法携带任何人的密钥,因此打开时凭据为空。两步即可完成。
连接 OpenAI。 打开 OpenAI Chat Model 节点,选择你的 OpenAI 凭据。如果没有,在 OpenAI API Keys 页面创建密钥,在 Billing 下充值,把密钥粘贴到 n8n 的新凭据中。模板使用 gpt-4.1-nano,最便宜的模型,练习成本几乎可以忽略。如果模型列表加载不出来,把 “From list” 小框切到 “By ID”,手动输入模型名。
连接你的表格。 打开 Analyze Data,选择拥有该 spreadsheet 的 Google 账户的 Google Sheets 凭据,然后选 Document 和 Sheet tab。两个容易踩的坑:用不同 Google 账户的凭据不会列出你的 spreadsheet;表需要第 1 行是列名,数据从第 2 行开始。点击 Execute step。如果输出面板显示每行一条记录且带有列名,agent 也能读取。
gpt-4.1-nano 是 OpenAI 面向高吞吐、低延迟场景的小型模型,定位类似早期的 gpt-3.5-turbo 或 gpt-4o-mini:单价低、速度快,适合做工具调用和结构化抽取这类“不需要深度推理”的任务。用它跑本文这种读表问答,单次成本通常不到一分钱,练习阶段几乎可以忽略。
代价是复杂推理和长上下文表现弱于大模型,所以当问题涉及多步计算或跨表关联时,换用更强的模型往往比重写提示词更有效。n8n 的 OpenAI Chat Model 节点支持在“From list”和“By ID”之间切换:列表模式从 OpenAI 拉取可用模型名,网络或账户权限异常时可能为空,此时切到“By ID”手动填写模型标识即可绕过。
必须知道的坑:核对总数
这是我很庆幸实际测试而不是想当然的部分。我让 agent 计算某位客户经理 Active 客户的总月费。它列出了正确的三行:2,500、1,800 和 1,900。然后说总数是 5,200。真实总数是 6,200。
语言模型擅长找到正确的行,在算术上则不太可靠。模型每次运行也可能不同,所以我的答案错了,你的答案可能对,反之亦然。对业务来说规则很简单:用 agent 查找和列出,在向客户重复总数或写入报告之前,自己(或用表格公式)加总。如果让 agent 展示它的行,核对只需十秒。
计数和列表类问题(“谁”“哪些”“何时”)是甜蜜点。金额总数值得人工核对。
语言模型在算术上不可靠,根源在于它处理的是 token 而不是数字。 模型看到的“2500”会被切分成若干 token,它并不是在做十进制加法,而是根据训练中见过的模式预测下一个 token。因此模型能准确地把金额从表格里“抄”出来,却在求和、平均、百分比这类运算上容易出错,而且同一个问题换一次运行结果就可能不同。
缓解办法有三类:一是让 agent 把用到的行先列出来,人工十秒核对;二是把求和交给表格公式或专门的 Calculator 工具,让模型只负责选行、不负责算数;三是在提示词里明确要求“涉及金额总数时必须列出计算过程”。但最稳妥的仍然是把 AI 当作查找和列出的助手,最终数字由人或确定性程序确认。
成本与预期
- 设置时间: 有密钥后约 8 分钟。
- 运行成本: nano 模型非常便宜,典型问题成本极低。
- 风险: 低,因为 agent 只读。不要与不该看到完整名单的人分享聊天,因为 agent 能读取指向的每一行。
要让其他人使用,需要发布工作流。那是单独的步骤,值得在发布前决定谁有访问权限。
在哪里练习
上述工作流共有 22 个步骤,分三部分:连接 OpenAI、连接表格、向数据提问。作者将其转化为免费互动课程,在 n8n 编辑器的练习副本中运行,使用虚构数据,因此不会触及真实账户,也不会产生费用。
完整课程见:n8n: Talk to Your Google Sheets with ChatGPT。
如果你已有客户列表、任务列表或订单表,这是让它变成全团队可查询的最快方式之一。从你被问得最多的那张表开始。
相关推荐

iPhone Duo上手体验:2000美元的小屏折叠,值不值?
YouTube博主Allison分享iPhone Duo上手体验:双屏多任务效率翻倍,视频观看体验出色,磨砂质感好评,但机身偏厚、单屏操作偏小,2000美元定价进入MacBook区间,属于奢侈品定位。

Sentry广告笑疯开发者:On-call也能变有趣?
Sentry广告短片以开发者On-call焦虑为切入点,用幽默对话展示其将错误、日志、链路、指标、录屏和发布记录集中一处的可观测性能力,引发开发者社区共鸣。
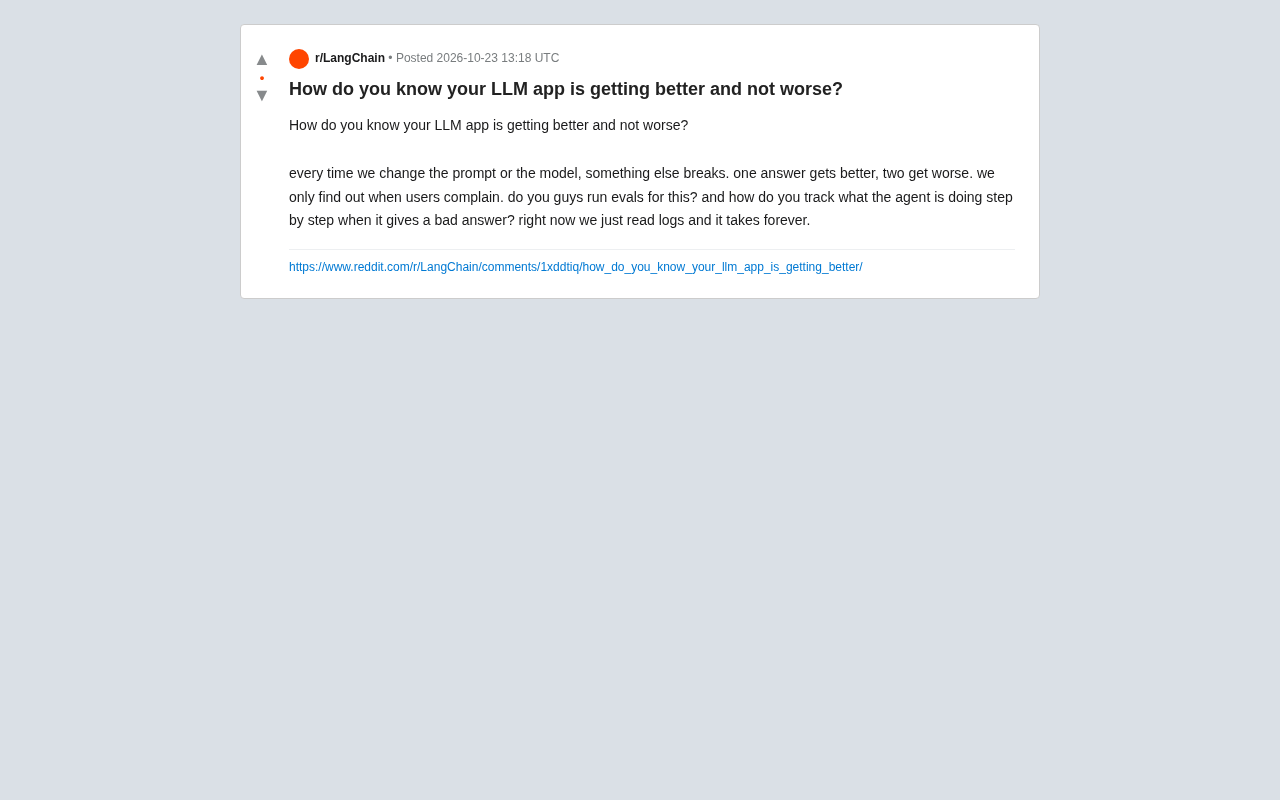
LLM应用越改越糟?三步构建有效评估体系
LLM应用迭代时如何判断变好还是变坏?本文基于Reddit开发者讨论,详解构建测试集、自动化回归评估、LLM-as-judge评分与结构化追踪智能体行为,建立从生产反馈到评估追踪的持续闭环。