You.com推出Inference Router:12款开源模型+99.9%可用性SLA
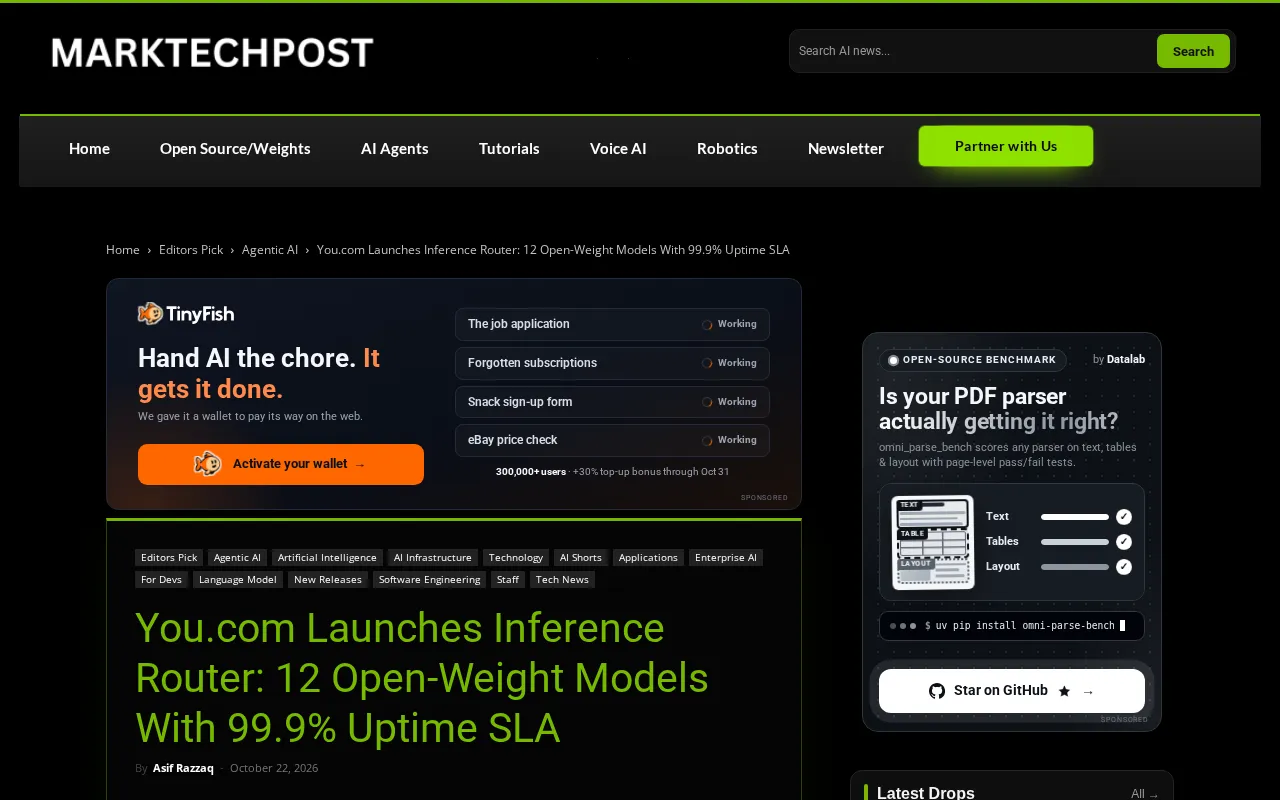
You.com推出兼容OpenAI接口的Inference Router,聚合12款开源模型并承诺99.9%可用性SLA。
You.com发布Inference Router,这是一个兼容OpenAI接口的推理路由服务,聚合12款开源权重模型,并以99.9%可用性SLA、零数据保留、100%美国托管和服务端Web搜索作为差异化卖点,采用无平台费、按用量计费的模式。文章分析了多模型策略成为默认选项后,路由层作为基础设施的价值:统一端点背后由平台负责模型分发、故障切换与容量调度。同时指出独立路由平台面临推理优化工程积累不足、路由层可替代性强等挑战,需靠SLA兑现与合规能力构建护城河。最后给出开发者评估清单,包括接口兼容真实程度、SLA赔付条款、数据保留边界、模型版本策略与搜索计费方式。
You.com推出Inference Router:12款开源模型+99.9%可用性SLA
据MarkTechPost报道,You.com正式发布Inference Router——一个兼容OpenAI接口的API服务,聚合了12款开源权重模型,并承诺99.9%的可用性SLA。对于正在寻找闭源API替代方案的开发团队来说,这个产品的几个设计选择值得仔细拆解。
产品核心规格一览
Inference Router的定位是"推理路由层":开发者用同一套OpenAI SDK调用方式,就能在12个开源权重模型之间切换。官方披露的关键参数包括:
- OpenAI兼容API:现有基于OpenAI SDK的代码基本可以平移,迁移成本低
- 12款开源权重模型:覆盖不同规模与能力档位(具体模型清单原文未完整列出)
- 99.9%可用性SLA:以服务等级协议形式承诺,而非口头"高可用"
- 零数据保留:请求与响应数据不留存
- 100%美国托管:满足数据驻留与合规诉求
- 服务端Web搜索:模型推理时可调用联网检索能力
- 无平台费:只按推理用量计费,不收额外的路由"过路费"
这套组合拳指向的客户画像很清晰:对数据主权敏感、又不想被单一模型厂商锁定的企业开发团队。
开源权重模型(Open-Weight Models) 指模型训练完成后,其权重参数以可下载或可获取的形式公开发布的模型,如 Llama、Mistral、Qwen 系列。它与“开源”并非完全等同:权重公开不代表训练数据、训练代码或完整许可证同样开放,部分模型仅允许带限制条件的商用。对推理服务商而言,开源权重意味着可以自行部署在自有或租用的 GPU 集群上,无需依赖模型厂商的托管 API,从而具备定价自主权和故障隔离能力;对客户而言,则意味着可以在不同平台之间迁移同一模型,降低单一供应商锁定风险。Inference Router 聚合的 12 款模型正属于这一类别,因此其路由能力本质上是“同一批可移植权重在不同托管环境间的调度”。
零数据保留(Zero Data Retention) 是数据合规领域的一类承诺,通常指服务商在请求处理完成后不持久化存储提示词、模型输出及可关联到具体用户的元数据。它常与监管要求挂钩,例如 GDPR 中的存储限制原则、HIPAA 对受保护健康信息的处理约束,以及金融行业对客户数据跨境与留存的审查。实践中,“零数据保留”的边界需要逐项确认:是否覆盖访问日志、错误追踪、监控指标和推理缓存;是否允许为滥用检测保留短期脱敏副本;服务端 Web 搜索产生的查询串是否也纳入不留存范围。文章把该承诺与美国托管并列,正是因为它主要服务于受监管行业的采购审查。
为什么"路由"成了基础设施的新战场
过去一年,多模型策略从"可选项"变成了"默认选项"。原因不复杂:没有任何一个开源模型在所有任务上都占优,代码生成、长文摘要、结构化抽取各有擅长的选手。团队如果为每个模型维护一套接入代码和计费账户,工程负担会迅速膨胀。
Inference Router这类产品的价值就在于把"模型选择"抽象成路由决策。开发者面对的是一个统一端点,背后由平台负责模型分发、故障切换和容量调度。99.9%的SLA承诺只有在多模型、多集群的路由架构下才有意义——单模型单集群很难给出这样的保障。
说个细节,"零数据保留"与"美国托管"这两条同时出现,说明You.com把合规叙事放在了产品设计的中心位置。对于金融、医疗等受监管行业的团队,这往往比模型跑分更具决策权重。
开源权重模型托管的三方博弈
Inference Router的推出,折射出当前推理市场的三方格局:
第一方是模型厂商自营API,优势是模型最新、优化最深,劣势是单一供应商风险;第二方是云厂商的托管推理服务,优势是基础设施与合规体系成熟,劣势是模型选择受限于云厂货架;第三方就是You.com这类独立路由平台,卖点是模型中立、接口统一、计费灵活。
独立路由平台的挑战同样明显。开源权重模型的推理优化(量化、批处理、KV缓存)需要深厚工程积累,否则延迟和吞吐会被云厂商拉开差距;另一方面,路由层本身可替代性强,平台需要用SLA、合规承诺和搜索等增值能力构建护城河。You.com选择用"零数据保留+美国托管+服务端搜索"三件套来差异化,思路是合理的,但最终能否留住客户,取决于推理性能的实际表现。
服务等级协议(SLA) 是服务商与客户之间关于可用性、性能或支持响应时间的正式合同条款,而非单纯的技术指标。99.9% 的月度可用性目标折算下来,每月允许约 43 分钟不可用;计算口径通常排除计划内维护、客户侧错误和不可抗力。真正决定 SLA 价值的是赔付机制:是按未达标时长比例返还费用,还是设置服务抵扣上限;故障认定由谁举证、多长时间内申诉有效;连续多月不达标是否允许客户无罚退出。对路由平台而言,SLA 还涉及上游模型供应商或云基础设施的故障是否计入自身责任,这决定了承诺能否在多层依赖下兑现。
开发者该怎么评估这类服务
如果你正在考虑把业务流量切到Inference Router或类似平台,建议从以下几个维度做验证:
接口兼容的真实程度。OpenAI兼容通常指请求/响应格式对齐,但流式输出、工具调用、结构化输出等边缘行为可能存在差异,需要用实际业务请求做回归测试。
SLA的赔付条款。99.9%意味着每月约43分钟的允许停机时间,关键要看违约后的赔付比例和认定流程,而不只是看数字本身。
数据保留的边界。"零数据保留"需要确认是否覆盖日志、监控指标和缓存层,以及服务端Web搜索产生的查询内容如何处理。
模型清单与版本策略。12款模型的具体构成、是否支持固定版本、模型下线是否有提前通知期,都直接影响生产环境的稳定性。
搜索能力的计费方式。服务端Web搜索是差异化功能,但其调用是否单独计费、延迟开销多大,需要在上线前压测确认。
小结
Inference Router的发布本身算不上技术突破,但它精准踩中了多模型时代的工程痛点:统一接口、合规托管、可用性承诺。对于不想被单一模型厂商绑定、又缺乏自建推理集群能力的团队,这类路由服务提供了一个务实的中间选项。真正的考验在于推理性能与SLA兑现——承诺写在合同里,口碑写在延迟曲线上。
背景补充
KV 缓存(KV Cache) 是大模型推理优化的关键机制之一。自回归生成时,模型需要为已处理的每个 token 保存注意力机制中的键(Key)和值(Value)张量,避免每一步重复计算历史上下文。KV 缓存能显著降低首 token 之后的生成延迟,但会占用大量显存,且随上下文长度线性增长。推理服务商常用的优化手段包括分页式 KV 缓存管理(如 vLLM 的 PagedAttention)、前缀缓存复用和缓存量化。对于聚合多模型的路由平台,KV 缓存策略直接影响吞吐成本与并发上限,也是其与云厂商推理服务拉开性能差距的核心工程环节之一。
相关推荐
B站唯一讲透Harness Engineering?企业级多Agent协同实战解析
解析Harness Engineering企业级多Agent协同的核心组件:编排层、状态管理、安全隔离与可观测性。结合B站教程素材,讨论面试官为何开始追问工程约束,以及如何理性看待“唯一讲明白”类技术内容。
AI Agent全栈实战课:从0到1掌握双框架开发
B站AI Agent全栈实战课程导学解析:四阶段覆盖基础概念、LangChain精讲、单Agent实战与CrewAI多智能体进阶,含零配置环境工具与开源代码,适合有编程基础的开发者系统入门。
手写Agents.md,让AI编程稳定性大幅提升
B站UP主通过视频编辑器和卡牌游戏两个项目对比,揭示手写Agents.md和设计文档能显著提升AI编程稳定性,解释Agents.md与技能注入机制的区别,并给出文档驱动开发的实用方法。