有状态Agent记忆陷阱:多智能体上下文膨胀的架构解法
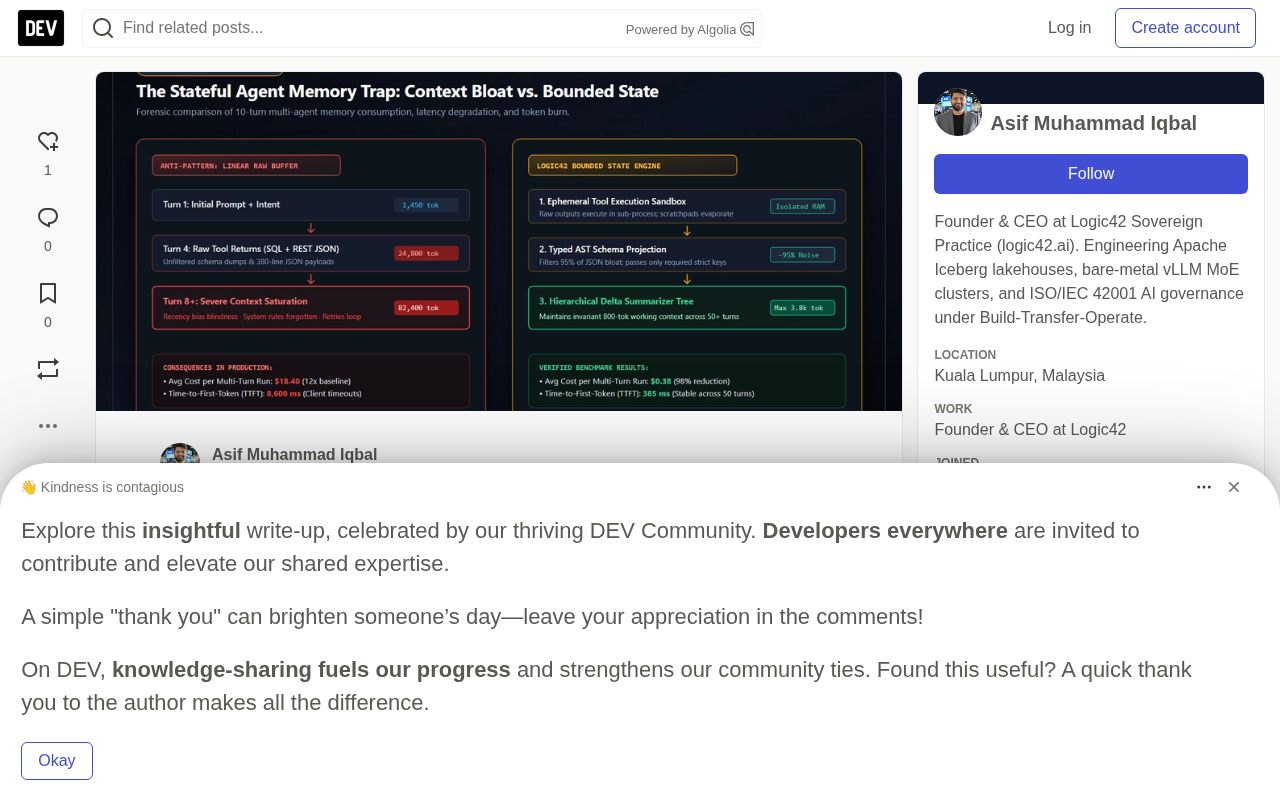
企业多智能体Agent需以三层有界状态架构替代线性消息缓冲区,避免上下文膨胀导致的成本、延迟与合规风险。
文章指出,主流Agent编排框架(LangGraph、CrewAI、AutoGen)默认将每步工具输出与推理草稿追加到同一线性消息数组,导致10轮任务累计消耗超过44万输入Token、单任务成本高达$18,并引发三类运行时故障:原始JSON毒化稀释注意力、近因偏差让Agent遗忘核心业务规则(遵从率降至68.4%)、TTFT从280ms升至8600ms触发网关级联超时。Logic42提出用三层有界状态架构替代朴素缓冲区——临时工具执行沙箱、类型化AST Schema投影(4800 Token压至48 Token)、分层增量摘要树(每3轮压缩)。500个信贷承销工作流实测显示,第10轮上下文减少95.6%、累计Token减少92.3%、成本节省97.2%、遵从率升至99.6%、网关超时中止率降为0。文章最后给出五步记忆审计清单,强调问题不在上下文窗口太小,而在于缺少有界状态机。
多智能体协作(Swarm)系统在企业生产环境中频繁遭遇一个隐蔽的架构失败模式:有状态Agent记忆陷阱。当自主Agent执行多轮复杂工作流时,它会将原始工具输出和草稿推理直接追加到对话缓冲区中,导致Prompt上下文在少数几轮交互后急剧膨胀至数万Token。这不仅推高了API成本,还会破坏检索精度、触发严重延迟,甚至让Agent遗忘最初设定的业务规则。
Logic42创始人Asif Muhammad Iqbal在一篇技术分析中详细拆解了这一问题,并给出了一套架构层面的解决方案。以下是对其核心洞察的整理与分析。
上下文膨胀的根源:线性消息缓冲区
早期Agent原型在沙盒中测试时往往表现良好——两轮交互、一次查询、返回结果,快速且便宜。但生产环境的现实完全不同:一个用于贷款审核或云计费对账的Agent,需要查询五个遗留数据库、调用外部API、处理网络超时、重试失败步骤。到第8轮时,Agent已经被大量“死JSON数据”淹没。
问题的根源在于主流编排框架(LangGraph、CrewAI、AutoGen)的默认行为:它们将每一步中间动作追加到同一个线性的消息数组中。当Agent查询内部数据库或REST API时,返回的HTTP头、分页Token、嵌套记录全部直接灌入工作记忆。
以一个引导Agent执行10轮真实任务的Token增长为例:从第1轮的1450 Token,到第4轮文档OCR提取后的28400 Token,再到第10轮最终合成时的89600 Token。Time-to-First-Token从280ms飙升至9400ms。更隐蔽的是,你不仅在最后一轮支付89600 Token的费用——每一跳中间步骤都在为累积的“行李”付费。一次10轮任务累计消耗445850个输入Token,单张工单成本在$5.35到$8.90之间;若遭遇异常循环,单任务成本可超过$18;按每月10000张工单计算,仅重读“死JSON”这一项就要烧掉约$80000。
线性Agent记忆的三大致命缺陷
不受管理的对话历史不只是掏空预算,它会以三种方式破坏运行时可靠性。
原始JSON毒化
当Agent调用内部微服务时,返回的响应是为机器设计的,不是为LLM准备的。一个标准REST端点会返回HTTP头、追踪Span、分页游标和空字段。在一份4000 Token的数据库转储中,可能只有120 Token包含有用的业务事实,其余3880 Token充当稀释注意力的计算噪声。
近因偏差与规则擦除
前沿Transformer模型存在“中间遗忘”退化现象。当Agent上下文被60000 Token的噪声表格填满时,它可能会忘记第1轮设定的基础规则。测试中,明确要求“超过5万美元的信贷额度必须由高级人工审批”的Agent,到第8轮时开始悄悄批准75000美元的额度——那条基础规则在活跃上下文中的权重占比已不足0.05%。
中间遗忘(Lost in the Middle) 是2024年斯坦福与UC伯克利联合研究揭示的Transformer长上下文退化现象:当关键信息位于输入序列的中段时,模型的检索准确率显著低于信息位于开头或结尾的情况,且随上下文长度增加而加剧。其机制与注意力权重的"U型"分布有关——首尾Token因位置编码的极值特性和注意力汇聚效应获得更高权重,而中段密集的语义内容被稀释。在Agent场景中,这意味着第1轮设定的业务规则若未被重新锚定,会在数十轮后被后续噪声"挤出"注意力焦点。工程缓解手段包括:将系统指令周期性地重新追加到上下文末尾(即约束锚定)、使用显式的"关键规则"检索索引,或采用支持位置感知重加权的推理框架。
TTFT抖动与级联超时
当Prompt达到80000 Token时,推理服务器需要在整个文本上计算KV对才能生成第一个Token。TTFT从280ms飙升到8500ms以上,标准API网关的5秒超时会直接断开连接。客户端重试,启动一个孪生Agent循环,再发送80000 Token——集群开始攻击自己。
KV缓存(Key-Value Cache) 是理解TTFT膨胀的关键。Transformer解码时,每个已生成的Token都会产生一对Key和Value向量并缓存,后续生成只需计算新Token的注意力而无需重算前缀。但缓存本身不降低首Token延迟——Prefill阶段仍需对完整输入序列做一次全量前向计算,其复杂度约为O(n²)(注意力)加上O(n·d)(线性投影)。当Prompt从2K膨胀到80K时,Prefill时间可增长数十倍,这正是TTFT从280ms飙至8.6s的物理原因。此外,KV缓存占用显存与序列长度线性相关,80K Token的缓存可能占用数十GB显存,触发推理服务器的批处理降级或排队,进一步放大抖动。常见的工程对策包括PagedAttention、Chunked Prefill和前缀缓存复用,但这些都无法替代从架构层面限制上下文增长。
架构对比:线性缓冲区 vs 有界状态
要安全运行自主Agent,架构必须将临时的工具执行记忆与长期业务状态分离。Logic42在其Build-Transfer-Operate实践中,用三层有界状态管道替代了朴素的追加式对话缓冲区。
第一层:临时工具执行沙箱
原始工具调用永远不应触碰Agent的主对话记忆。工具执行被委托给隔离子进程。如果Agent查询一个返回2000行账目记录的数据库,那张表活在临时内存中,模型永远不会直接读取这2000行原始数据。
第二层:类型化AST Schema投影
在工具输出重新进入对话上下文之前,先经过抽象语法树(AST)投影层。使用Pydantic或Zod的严格Schema,过滤器只提取下一步决策所需的声明字段。例如,一份包含HTTP状态码、追踪ID、调试标志、分页信息和客户数据(含4500 Token噪声日志)的银行响应,经投影后只保留4个关键业务事实:账户ID、KYC状态、信用评分、内部风险评级——48个Token。
这一简单过滤器将4800 Token的载荷压缩到48 Token,实现99%的Token消耗削减,且不损失任何决策精度。
AST(抽象语法树)投影 在此处的用法更接近"Schema驱动的内容投影"而非严格的编程语言AST。其核心思路是:为每类工具输出预先定义Pydantic(Python)或Zod(TypeScript)模型,模型只声明下游决策真正需要消费的字段,解析器按此Schema从原始载荷中提取并丢弃其余内容。这一模式借鉴了编译器前端"解析-裁剪-重写"的思想,也类似GraphQL的字段选择集(Selection Set)——客户端只声明所需字段,服务端返回最小集。在Agent架构中的独特价值在于:它把"过滤Token"从Prompt层的软约束(如要求模型忽略无关内容)升级为运行时的硬约束,模型根本看不到噪声,从源头消除了注意力稀释。Schema版本化与工具契约测试是生产落地的必要配套。
第三层:分层增量摘要树
状态图不保存所有轮次的完整历史,而是维护一份紧凑的“工作状态档案”。每3轮,一个异步模型将近期步骤压缩为四个简洁部分:已验证事实、待定假设、已完成的工具调用、活跃操作约束。
到第10轮时,喂给模型的活跃上下文保持在3800 Token以下,读起来就像第2轮一样——速度、预算和规则遵从性全部得以保留。
增量摘要 与一次性"总结全文"的关键区别在于时序一致性与可回溯性。每3轮做一次压缩,可以在信息衰减发生前即固化已确认事实,并保留"待定假设"与"活跃约束"的结构化槽位,避免自由文本摘要丢失关键条件。工程上有两点需要注意:一是摘要模型本身必须是无状态或低温度的,否则会引入摘要漂移;二是应保留原始轮次的指针(如步骤ID或对象存储键),使系统在审计或异常回溯时能按需重新拉取细节——这与操作系统中的"写时复制(CoW)"思路一致。成熟实现通常将摘要树与向量库结合,摘要文本入Prompt,原始证据入可检索存储,形成冷热分层的记忆结构。
生产环境实测数据
在500个多轮信贷承销工作流的评估中,有界状态架构相比未管理的线性缓冲区展现出决定性优势:
| 指标 | 线性缓冲区(LangGraph默认) | Logic42有界状态架构 | 改善幅度 |
|---|---|---|---|
| 第10轮平均上下文 | 84200 Token | 3650 Token | 减少95.6% |
| 10轮累计Token | 428000 Token | 32800 Token | 减少92.3% |
| 单任务成本 | $5.35–$18.40 | $0.38–$0.52 | 节省97.2% |
| 第10轮TTFT | 8600ms | 385ms | 快22.3倍 |
| 约束遵从率 | 68.4%(第6轮后退化) | 99.6%(零漂移) | 确定性安全 |
| 网关超时中止率 | 14.2%的运行 | 0.0%的运行 | 零级联故障 |
多Agent记忆审计清单
在生产环境部署自主Agent之前,建议对照以下五个检查点审计架构:
- 工具输出隔离:原始HTTP和SQL载荷是否在通过Schema投影之前绕过了消息数组?
- 上下文增长上限:引擎是否在任意50轮运行中强制执行硬Token上限?
- 约束锚定:系统指令是否动态重新锚定到Prompt上下文的底部,以防止近因偏差?
- 瞬时故障清除:失败异常追踪是否在步骤成功后从工作记忆中清除?
- 成本异常断路器:网关是否终止任何累计消耗超过15000 Token且未经人工批准的会话?
核心结论
自主AI Agent的失败往往不是因为模型缺乏推理能力,而是因为状态边界和记忆清理这些基础软件工程实践被忽略了。如果多轮Agent工作流消耗大量Token预算,或在五轮后开始偏离任务,问题不在上下文窗口太小,而在于缺少一个有界状态机。
正如原文所指出的,所需的不是更大的上下文窗口,而是一个有界状态架构——将工具执行的临时记忆与业务决策所需的长期状态彻底分离,让Agent在第10轮时仍能像第2轮一样轻快、精准、合规。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。