预测研究的设计公式:OLS与岭回归的样本外R²事前估算

新论文提出预测模型的设计公式,用四个量事前估算样本外R²和相关系数。
传统事前功效分析只回答能否检测到效应,无法回答模型在新样本上预测得多好。论文针对预测模型提出闭式设计公式,在收集数据前即可估算期望样本外R²和观测-预测相关系数r。公式依赖四个设计阶段量:样本量N、预测变量数p、假设总体R²和设计效率因子D*。D*刻画协变量杠杆分布的不均匀性,使公式对数据不平衡与偏态敏感,突破经典收缩公式仅依赖N和p的局限。论文在LOOCV框架下分别推导OLS和岭回归的期望表现,并通过模拟验证。智能手机行为预测人格的案例显示,事前计算能提前判断OLS无法超越样本均值基线而岭回归可以,配套R包predpower实现了全部计算。
在心理学、社会科学和数据科学中,研究者常常在收完数据后才发现模型的预测能力远低于预期。传统的事前功效分析(power analysis)只解决"能否检测到效应"的问题,却不回答"模型在新样本上能预测得多好"。一篇新论文提出了针对预测模型的设计公式,让研究者在收集数据之前就能估算期望的样本外 $R^2$ 和观测-预测相关系数 $r$。
传统收缩公式的盲区
经典的收缩公式(如Ezekiel公式、Adjusted $R^2$)在估算样本外表现时,只考虑两个因素:样本量 $N$ 和预测变量个数 $p$。这种简化隐含了一个假设——所有观测对模型拟合的影响力是均匀分布的。
现实中的数据几乎从不满足这个假设。当协变量存在不平衡(imbalance)或偏态(skew)时,某些观测点会成为高杠杆点,对回归系数产生不成比例的影响。这意味着即便两个研究的 $N$ 和 $p$ 完全相同,由于协变量分布形态不同,它们的样本外预测表现可能相差甚远。
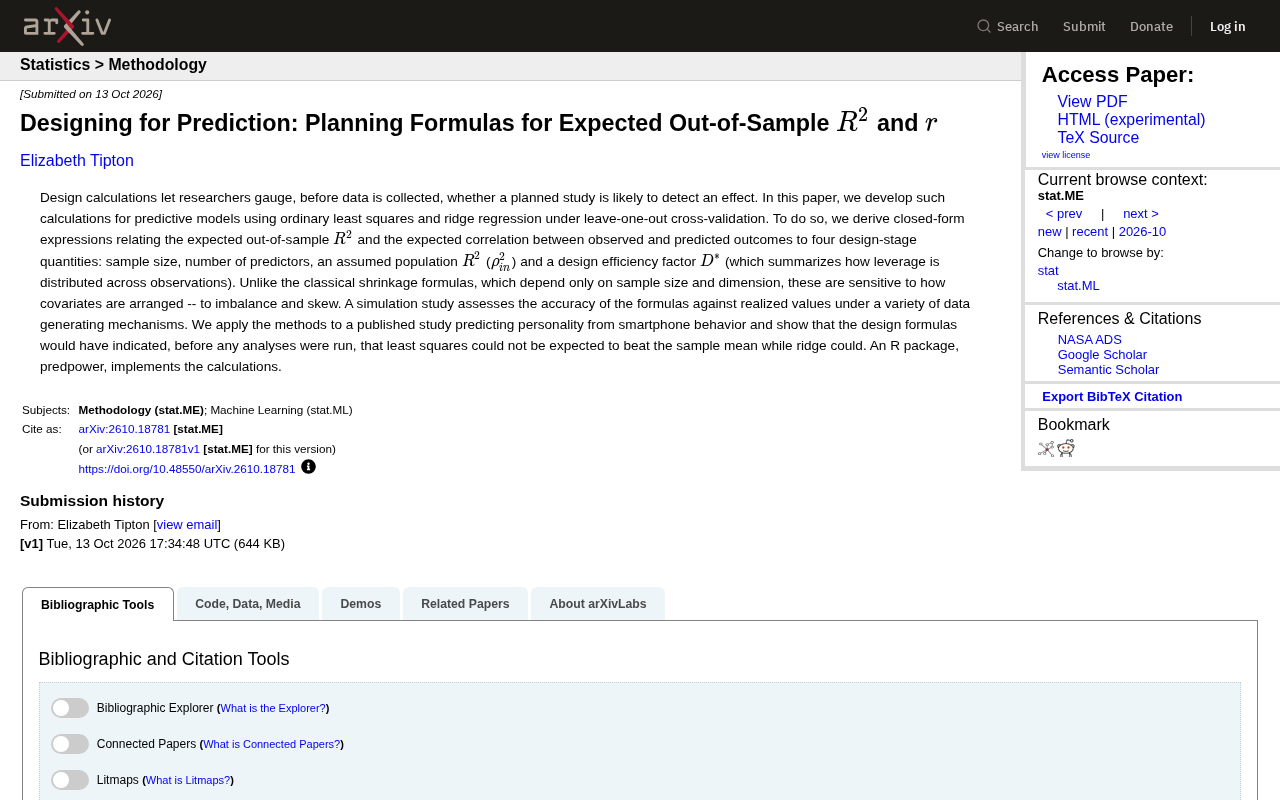
论文作者引入了一个关键的设计效率因子 $D^*$,用来概括杠杆在观测之间的分布方式。这使得新公式能够捕捉到传统方法忽略的结构性差异。
杠杆值(leverage) 是回归诊断中的核心概念,指第 $i$ 个观测对自身拟合值 $\hat{y}i$ 的影响力。在 OLS 中,杠杆值由帽子矩阵 $H = X(X^\top X)^{-1}X^\top$ 的对角元素 $h{ii}$ 给出,满足 $0 \le h_{ii} \le 1$ 且 $\sum_i h_{ii} = p+1$(含截距时)。当某个观测的协变量取值远离样本中心(例如极端偏态或分布不平衡),其 $h_{ii}$ 会接近 1,意味着该点几乎“独自决定”了自己的预测值,模型对该点的拟合几乎是插值而非泛化。高杠杆点会显著抬高训练集 $R^2$,却对样本外表现贡献甚微,从而让传统收缩公式高估预测能力。$D^*$ 正是对 ${h_{ii}}$ 分布偏离均匀状态的整体度量,因此能捕捉这一被经典公式忽略的结构效应。
四个设计阶段量决定预测表现
论文推导出的闭式表达式将期望样本外 $R^2$ 和期望相关系数 $r$ 与四个设计阶段可指定的量关联起来:
- 样本量 $N$:观测数量,传统功效分析的核心参数
- 预测变量个数 $p$:模型中包含的特征数量
- 假设的总体 $R^2$($\rho^2_{in}$):研究者对真实效应大小的先验估计
- 设计效率因子 $D^*$:衡量杠杆分布的均匀程度
$D^$ 的引入是这套方法区别于经典公式的核心。当数据分布均衡时,$D^$ 接近某个基准值,新公式退化为与传统公式相近的结果;当数据存在严重不平衡或偏态时,$D^*$ 会显著偏离基准,导致预测表现估算出现大幅调整。
样本外 $R^2$ 与观测-预测相关系数 $r$ 是衡量预测模型泛化能力的两个互补指标。样本外 $R^2$ 通常定义为 $1 - \frac{\sum (y_i - \hat{y}_i)^2}{\sum (y_i - \bar{y})^2}$,其中分母以样本均值为基线;当模型预测还不如直接用均值时,该值会降到 0 以下。相关系数 $r$ 则衡量预测值与真实值的线性一致性,对尺度不敏感,二者的平方关系并非严格成立(因为 $R^2$ 的分母固定为均值基线,而 $r^2$ 会随预测值的方差变化)。实际研究中报告哪一个取决于关注点:若关心绝对预测误差,看 $R^2$;若只关心排序或关联强度,看 $r$。理解这一区别有助于正确解读 predpower 输出的两个期望值。
留一交叉验证下的OLS与岭回归
论文的分析框架基于留一交叉验证(LOOCV),分别推导了普通最小二乘(OLS)和岭回归(ridge regression)的期望样本外表现。
对于OLS,闭式解揭示了样本外 $R^2$ 如何随 $D^$ 偏离理想值而衰减。对于岭回归,正则化参数的选择与 $D^$ 之间存在交互效应——在高杠杆数据中,岭回归的收缩机制能够部分补偿不平衡带来的预测损失。
模拟研究在多种数据生成机制下验证了公式的准确性。结果显示,在不同程度的协变量偏态和杠杆集中情况下,公式给出的期望值与实际实现值之间的偏差在可接受范围内。
留一交叉验证(LOOCV) 是 $K$ 折交叉验证在 $K=N$ 时的极端情形:每次留出一个观测作为测试集,用其余 $N-1$ 个观测训练模型,重复 $N$ 次后取平均误差。其优点是无随机划分带来的方差,且对线性模型存在闭式解——OLS 的 LOOCV 残差可写成 $e_i/(1-h_{ii})$,其中 $h_{ii}$ 正是杠杆值,这也解释了为何 $D^*$ 会自然进入期望样本外表现的公式。岭回归在 LOOCV 下的闭式解形式类似,只是分母中加入了正则化参数 $\lambda$,产生对高杠杆点的额外收缩。需注意 LOOCV 在高杠杆数据上方差较大,且当观测间存在相关性时可能高估泛化性能,这是解读公式结论时需要留意的边界条件。
智能手机行为预测人格:一个真实案例
论文将方法应用于一项已发表的研究——用智能手机行为数据预测人格特质。这个案例恰好展示了设计公式的实用价值。
按照公式的事前估算,在给定的样本量和预测变量数量下,OLS的期望样本外 $R^2$ 不足以超过样本均值基线——也就是说,用最小二乘回归做预测,还不如直接拿样本均值当预测值。但岭回归的期望表现则能够超越这个基线。
这一结论与已发表研究的实际分析结果一致。如果研究者在收集数据之前就运行了这套设计计算,就能提前知道应该选择岭回归而非OLS,从而避免在分析阶段才被动调整方法。
样本均值基线 指不做任何建模、直接以训练集 $\bar{y}$ 预测所有新样本时所能达到的表现。对样本外 $R^2$ 而言,这一基线恰好为 0;对相关系数 $r$ 而言,若 $\bar{y}$ 为常数则相关系数无定义。因此“OLS 无法超越样本均值基线”意味着其期望样本外 $R^2$ 小于等于 0,即最小二乘在高杠杆、弱信号数据上不仅没有泛化能力,反而比什么都不做更差。岭回归通过引入 $L_2$ 惩罚缩小系数,在高杠杆场景下降低方差,从而可能把期望 $R^2$ 推回 0 以上。这一对比凸显了预测导向研究中正则化的必要性:当真实效应较弱且协变量分布不平衡时,默认使用 OLS 是一个可预见的陷阱。
predpower工具包
论文附带了一个R包 predpower,实现了上述所有计算。研究者只需输入四个设计阶段参数,即可获得期望样本外 $R^2$ 和 $r$ 的估计值,以及对应的置信区间。
这套工具填补了预测导向研究在设计阶段的空白。对于机器学习实践者和定量社会科学研究者来说,它提供了一种在数据收集前评估预测模型可行性的系统方法——不仅问"能不能检测到效应",更问"能不能预测得准"。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。