UDA、SFDA与SSOD域适应方法对比:原理与选择指南

系统对比UDA、SFDA、SSOD三类域适应方法,为多模态跨季节鲁棒目标识别研究提供方法论选择框架。
本文以Reddit上一位开发者的真实困惑为引,系统梳理了域适应领域三种主流方法——无监督域适应(UDA)、无源域适应(SFDA)与半监督目标检测(SSOD)——的核心原理、技术路线和适用边界。文章指出,三者的本质差异在于目标域标签可用性与源域数据可访问性的不同组合。针对具体案例(RGB+LWIR双模态、跨季节、跨时段数据集),作者分析认为:由于开发者掌握完整标注且目标是研究条件偏移下的鲁棒性,最科学的做法并非单选一种方法,而是将三种方法设计为对照组,通过系统的消融实验分别量化模态偏移、季节偏移和时段偏移的独立影响,从而产出兼具工程价值与研究意义的结论。
引言:一个真实的技术困惑
在计算机视觉的实际项目中,模型在训练数据上表现优异,一旦部署到新环境却大幅退化——这就是所谓的"域偏移"(Domain Shift)问题。近日,一位从事鲁棒目标识别研究的开发者在Reddit上提出了一个颇具代表性的问题:面对一个包含多模态、跨季节、跨时段的复杂数据集,究竟应该选择UDA、SFDA还是SSOD?
这位开发者的具体情况是:数据集包含RGB与LWIR(长波红外)两种模态,采集自1月和5月两个不同季节、3个不同时间段。每张图像都配有XML格式的目标标注,因此可以选择使用全部标签训练,也可以仅使用少量标签。其核心研究目标是研究条件偏移(conditional shift)下的模型鲁棒性。
这个问题触及了域适应领域的核心方法论选择。本文将系统梳理UDA、SFDA、SSOD三类方法的原理与适用场景,并针对该具体任务给出分析建议。
域适应的核心概念:理解域偏移问题本质
域适应(Domain Adaptation)的核心目标,是让在源域(Source Domain)上训练的模型,能够良好地泛化到分布不同的目标域(Target Domain)。
在上述案例中,域偏移体现得非常典型:
- 模态偏移:RGB与LWIR在成像原理上完全不同,红外图像反映的是热辐射而非可见光反射;
- 季节偏移:1月与5月的光照、植被、背景差异显著;
- 时段偏移:不同时间段的光照条件带来外观变化。
这些变化属于典型的条件偏移——即输入分布 P(X) 发生变化,而目标类别本身(如"车辆""行人")的语义保持不变。理解这一点至关重要,因为它决定了适配策略的方向。
UDA、SFDA与SSOD三种方法的关键区别
三类域适应方法的本质差异,在于目标域标签的可用性和源域数据的可访问性:
| 方法 | 源域数据 | 目标域标签 | 适用场景 |
|---|---|---|---|
| UDA(无监督域适应) | 需要 | 完全无标签 | 目标域标注成本极高 |
| SFDA(无源域适应) | 不可访问 | 完全无标签 | 隐私/存储限制 |
| SSOD(半监督目标检测) | 需要 | 少量有标签 | 有部分标注预算 |
UDA无监督域适应:原理与适用场景
无监督域适应(Unsupervised Domain Adaptation, UDA) 假设你拥有带标签的源域数据和完全无标签的目标域数据。其核心思路是通过特征对齐,缩小两个域之间的分布差异。
常见的UDA技术路线包括:
- 对抗训练:引入域判别器,让特征提取器学习出"域不变"的表示(如DANN方法);
- 最大均值差异(MMD):直接最小化源域与目标域特征分布的统计距离;
- 自训练/伪标签:用源域模型为目标域生成伪标签,再迭代优化。
UDA适合目标域标注成本极高、几乎无法获得标签的场景。但在本案例中,由于开发者明确表示"每张图像都有XML标注",完全不用这些标签反而是一种资源浪费。
SFDA无源域适应:原理与适用场景
无源域适应(Source-Free Domain Adaptation, SFDA) 是UDA的一个更严苛变体:在适配阶段,你无法再访问源域数据,只有一个预训练好的源模型和无标签的目标域数据。
这一设定通常出现在:
- 数据隐私法规限制源数据共享;
- 源数据体量过大无法长期保存;
- 模型以"黑盒"形式交付。
SFDA的技术难点在于,没有源数据作参照,只能依靠模型内部的知识(如批归一化统计量、熵最小化、伪标签自监督)来完成适配。
对于该开发者而言,其自身掌握完整数据集,不存在源数据不可访问的约束,因此SFDA并非必要选择——除非研究目标特意要模拟"无源数据"的受限场景。
SSOD半监督目标检测:原理与适用场景
半监督目标检测(Semi-Supervised Object Detection, SSOD) 与前两者的定位略有不同。它并非严格意义上的"跨域"方法,而是关注如何在只有少量标注、大量无标注数据的情况下训练检测器。
典型方法如教师-学生框架(Teacher-Student),教师模型对无标签数据生成伪框,学生模型在有标签数据和高置信度伪标签上共同学习,并通过EMA(指数移动平均)更新教师。
SSOD与该项目的适配点在于:开发者提到"可以只用一小部分标签训练"。这恰好符合半监督的设定——用少量标注数据引导,充分利用剩余无标注数据。
针对该任务的域适应方法选择建议
结合开发者的具体条件,可以做出以下分析:
核心研究目标决定方法选择
开发者的最终目标是"研究条件偏移下的鲁棒性",而非单纯追求最高精度。这意味着方法选择应服务于"对比实验"的科学性:
-
如果拥有充分标注:可以设计一个跨域实验——在RGB(1月)上训练,在LWIR(5月)上测试,用UDA方法衡量特征对齐带来的鲁棒性提升。这是研究"模态+季节"双重偏移的理想设置。
-
如果想模拟标注稀缺:则采用SSOD,仅用少量目标域标签,观察半监督策略能否稳定提升跨条件性能。
-
若要研究隐私/受限场景:可引入SFDA作为对照,验证在无源数据条件下的适配能力。
推荐的实验路径
对于这类"研究鲁棒性"的项目,最有价值的做法是将多种域适应方法作为对照组横向比较,而不是纠结于单选一种:
- 基线:直接源域训练、目标域测试(衡量原始域偏移程度);
- UDA:作为无标签适配的上界参考;
- SSOD:作为少量标签下的实用方案;
- 消融实验:分别测试模态偏移、季节偏移、时段偏移的独立影响。
这种实验设计能清晰揭示"哪种偏移最难适配",从而真正回答"条件偏移下鲁棒性"这一核心问题。
结语
域适应方法的选择,本质上不是"哪个更好"的问题,而是"你拥有什么、想验证什么"的问题。UDA、SFDA、SSOD分别对应了标签与数据可用性的不同约束边界。
对于这位Reddit开发者而言,既然目标是研究鲁棒性,最科学的做法是把这些方法当作可控变量,通过系统的对比实验,量化多模态、跨季节、跨时段偏移各自的影响。这不仅能回答工程问题,更能产出有价值的研究洞察。
相关推荐
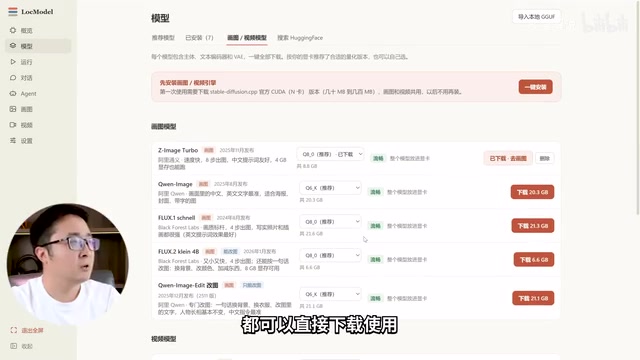
本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。