预算有限如何调用多个基础模型?新框架用Q学习动态选择
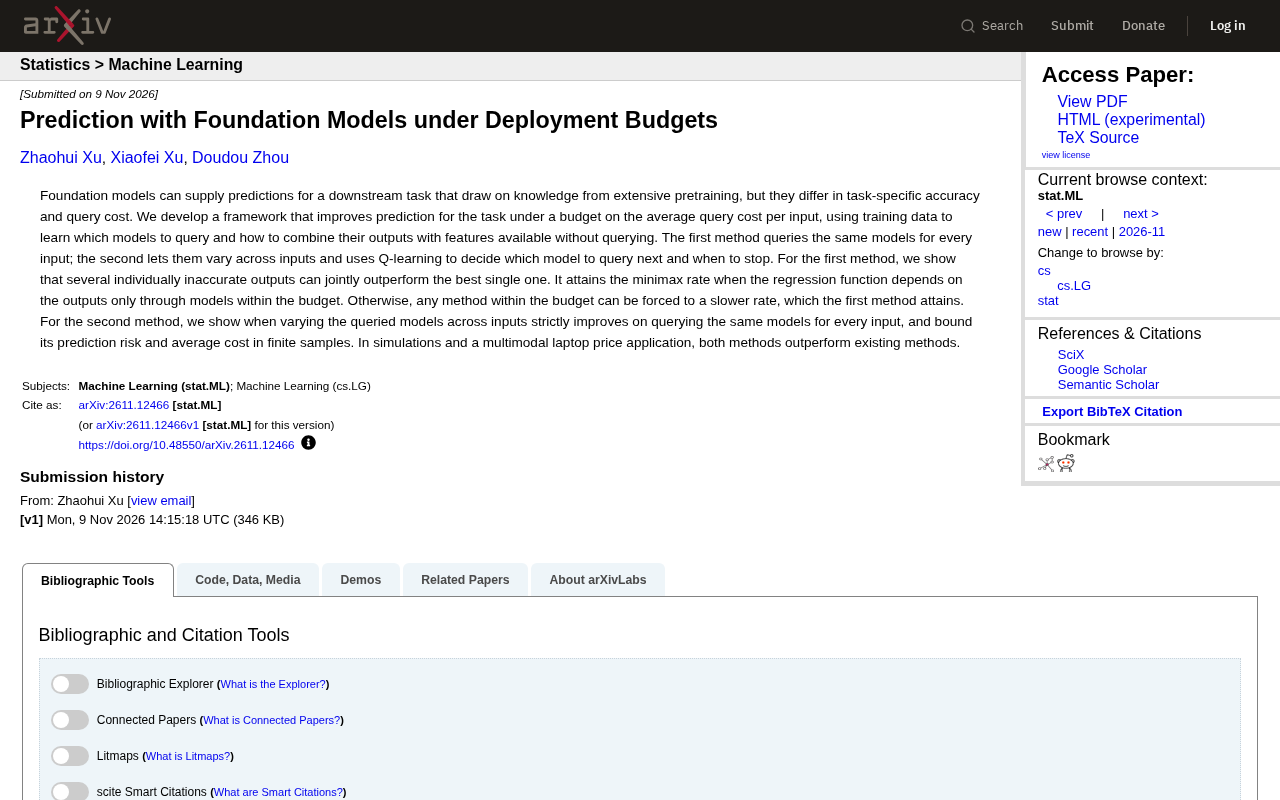
在平均查询预算约束下,用固定查询或Q学习动态组合多个基础模型可提升预测精度。
本文介绍了一项关于预算约束下组合多个基础模型的研究。基础模型在特定任务上准确率各异且查询成本不同,实际部署常面临平均每输入成本上限。研究者提出两种方法:一是对所有输入查询固定的一组模型并融合输出,理论证明多个不够准确的模型联合可超越最佳单个模型,且达到极小极大速率;二是用Q学习按输入动态决定查询哪些模型及何时停止,并给出有限样本风险与成本上界。模拟实验和多模态笔记本电脑价格预测应用显示,两种方法均优于现有方案。文章指出,将模型调用视为可优化的决策问题,有助于在预算内实现更优性价比。
为什么需要关注基础模型的查询成本
基础模型凭借大规模预训练,能够为下游任务提供开箱即用的预测能力。但不同模型在特定任务上的准确率差异显著,而且每次查询的成本并不相同——有的模型轻量便宜,有的则需要调用庞大参数或复杂推理,代价高昂。
现实部署场景中,我们往往面临一个预算约束:平均每个输入允许的查询成本有上限。如何在预算内组合多个基础模型的输出,既提升预测精度又不超支,成为一个关键问题。最近一篇研究提出了系统性的框架来解决这个矛盾。(素材来源:rss,Screenshot: screenshots/source/54398_0.png)
两种策略:固定查询与自适应Q学习
研究者设计了两种方法,利用训练数据学习“查询哪些模型”以及“如何结合输出”与无需查询即可获得的特征。
方法一:对每个输入查询相同模型
第一种方法对所有输入都查询一组固定的模型,然后融合它们的输出。看似简单,但论文证明了一个反直觉的结论:多个各自不够准确的输出,联合起来可以超越其中最好的单个模型。这背后的逻辑是,不同模型的错误模式可能互补,集成后能抵消部分偏差。
在理论层面,当回归函数仅通过预算内的模型输出起作用时,该方法达到极小极大速率(minimax rate)。反之,如果回归函数依赖预算外的模型,任何受预算约束的方法都会被强制进入更慢的速率,而该方法恰好也能达到这个较慢速率。这意味着方法一在理论上接近最优。
方法二:按输入动态选择模型
第二种方法允许每个输入查询不同的模型集合,并使用Q学习来决定“下一个查询哪个模型”以及“何时停止查询”。这类似于一个强化学习智能体,在每一步根据当前已有信息判断继续查询是否值得。
论文明确了在什么条件下,按输入变化查询模型能严格优于固定查询同一组模型,并给出了有限样本下的预测风险与平均成本上界。这为动态策略的有效性提供了理论保障。
极小极大速率(minimax rate) 是统计学习理论中衡量估计方法最优性的核心概念。它刻画的是:在所有可能的真实数据分布中,最坏情况下的期望误差随样本量增大而收敛的最快速度。若某方法达到极小极大速率,意味着没有其他方法能在最坏情况下显著超越它,因此该方法在理论意义上是速率最优的。文中方法一在回归函数仅依赖预算内模型输出时达到该速率,说明其误差收敛速度已无法被普遍改进;而当回归函数依赖预算外模型时,任何受预算约束的方法都只能达到更慢的速率,方法一亦匹配该下界,进一步印证了其理论上的紧致性。
Q学习 是一种无模型强化学习算法,通过迭代更新状态-动作值函数 Q(s, a) 来学习最优策略。在本框架中,“状态”编码了当前已查询的模型及其输出,“动作”对应下一步查询哪个模型或停止查询,“奖励”则综合了预测精度的提升与查询成本。Q学习使智能体能够在未知环境动态中,通过试错平衡探索(尝试新查询)与利用(基于已有知识决策),从而学得按输入自适应的查询策略。与固定查询相比,Q学习无需预先指定查询顺序,能灵活应对不同输入的异质性,这解释了它为何在理论上可严格优于静态方法。
实验验证:模拟与真实应用双双胜出
研究者通过模拟实验和一个多模态笔记本电脑价格预测应用,对比了两种方法与现有方法的表现。结果显示,两种方法均优于已有方案。笔记本电脑价格预测涉及图像、文本等多模态特征,模型查询成本各异,恰好体现了预算约束下模型选择的实际价值。
对AI应用开发的启示
对于AI应用开发者而言,这项研究传递了一个务实信号:不必迷信单一最强模型,也不必为每个输入都调用最贵的模型。通过训练数据学习查询策略,可以在预算内组合多个基础模型,获得更优的性价比。尤其是Q学习驱动的动态查询,为按需分配计算资源提供了可落地的思路。
不过,论文的理论分析依赖于一定的假设条件,实际部署时仍需针对具体任务验证。但框架本身指出了一个清晰方向:把模型调用当作可优化的决策问题,而不是固定流水线。
相关推荐
Starlink Mini 2 发布:便携卫星上网再进化
Starlink Mini 2 在 Hacker News 引发热议,帖子获 285 点、291 条评论。本文梳理便携卫星终端的迭代方向、社区讨论焦点及实际使用场景。
PewDiePie自搜趣谈:退休、自研AI模型Ajax与Linux日常
PewDiePie发布自搜视频,回应退休传闻,透露自研AI模型Ajax已达60 tokens/s、仍处BF16训练阶段,并分享Arch Linux日常、OpenAI封禁经历与对YouTube生态的疲惫感。
PewDiePie自曝失败:两年喂乌鸦计划为何翻车?
PewDiePie分享两年失败经历:试图与日本乌鸦交朋友,从喂花生到拯救倒吊乌鸦,最终被一位日本爸爸“抢走”荣耀。视频展现了与野生动物互动的真实挑战,以及创作者坦诚失败的一面。