语言模型先验+交互式查询:程序归纳准确率提升22%

研究提出贝叶斯交互式程序归纳框架,用语言模型作先验、贪心查询消除歧义,显著提升准确率与样本效率。
该研究从贝叶斯视角重新审视程序归纳,将其形式化为后验概率集中过程:给定语言模型提供的程序先验,学习器主动选择信息量最大的输入并向用户查询输出,使后验质量逐步集中到目标程序。理论分析证明贪心查询选择算法在 O(1/γ log 1/p0(f*)) 次查询后终止,并可返回近似等价的目标程序。为高效实现该算法,研究采用重要性采样估计查询选择目标,在 CodeARC 基准上相比仅用语言模型的智能体准确率提升 22 个百分点,所需示例减少 10.5 倍,验证了贝叶斯框架与语言模型先验结合的有效性。
程序归纳(Program Induction)旨在从少量输入输出示例中恢复出程序,从而降低编程门槛——用户只需演示规则行为,无需手动实现。然而,仅凭有限示例恢复程序本质上是模糊的:无限多个程序在未见的输入上可能产生不同输出,却与有限示例一致。近日,一项研究从贝叶斯视角重新审视该问题,提出交互式程序归纳框架,利用语言模型作为先验,并通过主动查询最大化信息量,在CodeARC基准上显著提升了准确率。
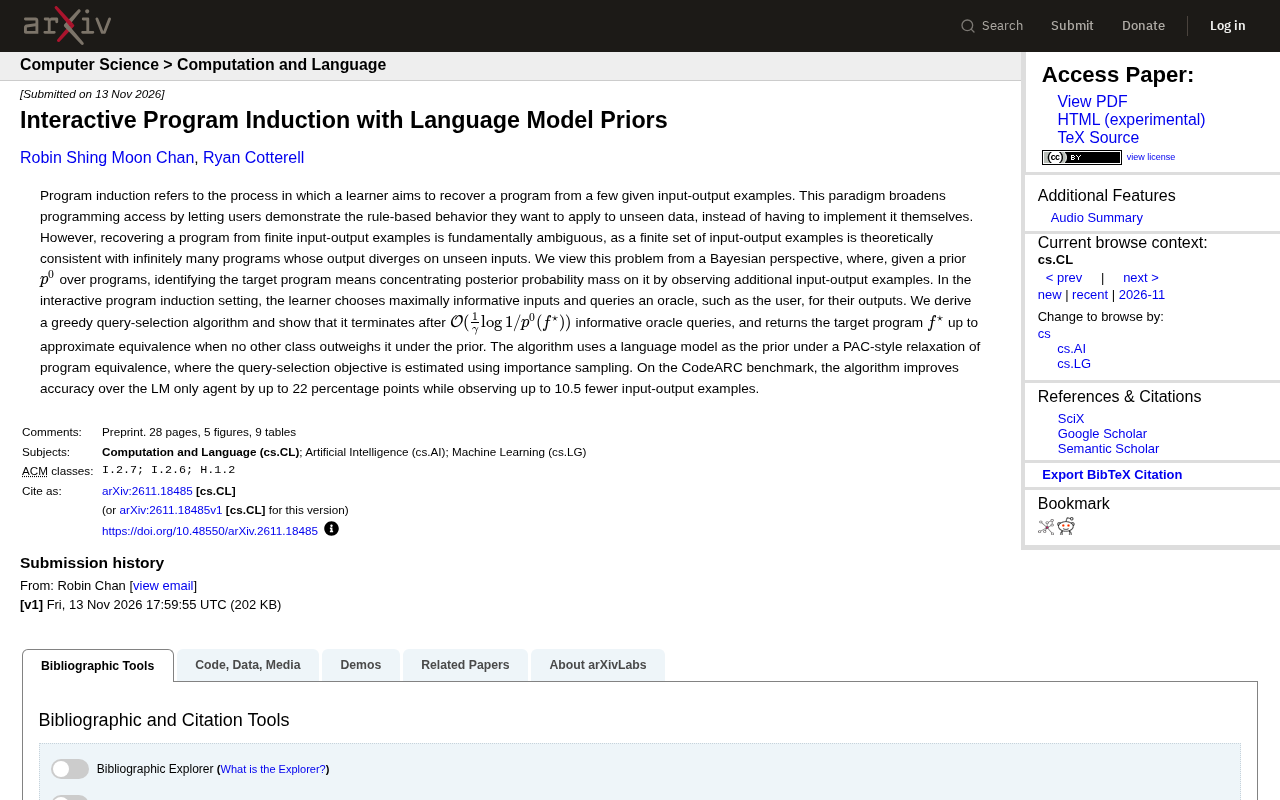
贝叶斯视角下的程序归纳
研究将程序归纳视为后验概率集中过程:给定程序先验 (p^0),观察更多输入输出示例后,目标程序的后验概率质量逐渐集中。在交互式设定中,学习器主动选择信息量最大的输入,并向预言机(如用户)查询输出。理论分析表明,贪心查询选择算法经过 (\mathcal{O}(\frac{1}{\gamma}\log 1/p^0(f^\star))) 次查询后终止,并在先验下无其他类超越时,返回近似等价的目标程序 (f^\star)。
这一框架的关键在于将语言模型作为先验,并在PAC-style放松的程序等价定义下,使用重要性采样估计查询选择目标。理论保证为算法提供了可解释的终止条件,而语言模型的引入则让先验更贴近真实程序分布。
后验集中(posterior concentration) 是贝叶斯统计中的核心概念:随着观测数据增多,后验分布的质量会逐渐向真实参数集中,集中速率由先验质量与数据生成分布共同决定。在程序归纳中,"参数"就是一整段程序,先验 (p^0) 是语言模型给出的程序分布,观测数据是用户提供的输入输出示例。理论上的收敛界 (\mathcal{O}(\frac{1}{\gamma}\log 1/p^0(f^\star))) 揭示了两个关键因素:(\gamma) 反映每次查询对目标程序的区分能力,(p^0(f^\star)) 则体现先验对真实程序的偏好程度——先验越"看好"目标程序,所需查询越少。这正是引入语言模型先验的理论动机。
PAC-style 放松的程序等价:经典 PAC 学习框架要求学到的假设与目标概念在输入分布上完全一致,但在程序归纳中,许多在语义上行为等价的程序(如不同实现方式的排序函数)在语法上差异巨大,且有限示例下很难精确判定等价。因此研究采用放松的等价定义:不要求逐输入完全一致,而是允许在低概率输入上存在偏差。这一放松让"近似恢复目标程序"成为可操作的目标,也为重要性采样估计提供了数学基础。
贪心查询与重要性采样
算法的核心是贪心选择信息量最大的查询。每一步,学习器评估候选输入对后验分布的潜在影响,选择能最大程度区分候选程序的输入。由于精确计算后验困难,研究采用重要性采样来估计查询选择目标,从而高效近似最优查询。
这种设计使得算法在查询次数和准确率之间取得平衡:理论保证查询次数为对数级,而实际中通过语言模型先验进一步减少所需示例。在CodeARC基准上,该算法相比仅使用语言模型的智能体,准确率提升高达22个百分点,同时观察的输入输出示例最多减少10.5倍。
重要性采样(importance sampling) 是一种用易采样分布来估计难采样分布下期望值的蒙特卡洛技术:从提议分布 (q) 中抽样,并用权重 (p(x)/q(x)) 修正偏差,从而无偏估计目标分布 (p) 下的统计量。在本算法中,真实后验 (p(f \mid \text{examples})) 难以精确计算,因为需要对所有可能程序求和;研究于是用语言模型先验与已观测示例构造提议分布,对候选程序采样并加权,近似估计每个候选输入对后验的"信息增益"。由此,贪心查询选择无需枚举整个程序空间,即可在可计算代价下逼近最优查询,这是算法在实验中显著减少查询次数的关键工程手段。
实验效果与意义
在CodeARC基准上的实验表明,交互式程序归纳结合语言模型先验能显著提升样本效率。准确率提升22个百分点意味着更多复杂程序能被正确归纳,而查询次数减少10.5倍则降低了用户交互负担。这一结果验证了贝叶斯框架与语言模型先验结合的有效性。
该研究为程序归纳提供了一条可扩展的路径:通过语言模型捕捉程序先验知识,再通过主动查询消除歧义。未来,这种方法有望应用于更广泛的编程辅助场景,让非专家用户通过少量示例即可获得可靠的程序。
CodeARC 基准是评估程序归纳与程序合成能力的测试集,其任务形式通常是给出一组输入输出示例,要求模型或算法恢复出符合示例的函数实现。该基准强调从少量示例中泛化到未见输入,因此能直接衡量样本效率与归纳准确性。本文报告的"准确率提升 22 个百分点"与"示例减少 10.5 倍"均是在该基准的交互式设定下、相对仅使用语言模型的智能体测得,说明主动查询机制在同等交互预算下能更有效地消除程序歧义。
总结
这项研究将程序归纳形式化为贝叶斯后验集中问题,提出贪心查询选择算法,并利用语言模型作为先验,在理论上保证了查询效率,在实验中实现了准确率和样本效率的双重提升。其核心贡献在于为交互式程序归纳提供了严谨的框架和实用的算法,推动了少样本编程的发展。
相关推荐

@ai-sdk/harness-fx 1.0.107 发布:依赖 MCP 升级,补丁更新
@ai-sdk/harness-fx 1.0.107 版本发布,主要更新依赖 @ai-sdk/mcp 至 2.0.103。了解这次补丁更新的内容、对 AI SDK 开发者的影响以及升级建议。

硅谷怎么了?O'Reilly长文引发Hacker News热议
O'Reilly Radar 发表《What Happened to Silicon Valley?》,在 Hacker News 获 302 分、153 条评论。文章梳理这场关于硅谷创新生态与文化变迁的公共讨论,分析为何技术社区对硅谷身份的追问再次升温。
马杜罗被捕后,委内瑞拉何去何从?
委内瑞拉前总统马杜罗被美军抓捕后关押于布鲁克林监狱,2027年将在纽约受审。本文梳理其执政历程、美国指控、选举争议及委内瑞拉当前权力真空与石油博弈。