语音AI代理延迟优化:分阶段测量与流式降低响应时间

拆解语音对话回合五阶段,分阶段埋点并用p50/p95与流式化压低延迟。
文章基于VRM AI Technology团队的技术分享,把一个语音对话回合拆为端点检测、ASR收尾、LLM首token、工具调用、TTS首字节五个阶段,主张逐阶段测量而非只看端到端总时长。测量方案是一个Python轻量Tracer,用defaultdict累积样本、time.monotonic计时,并在样本不足20个时跳过报告;流式阶段需在首个token到达时停表而非等生成结束。数据分析上应对比p50与p95,尾部偏高通常指向冷连接、长prompt、重试或网络抖动,并优先优化占比最大的阶段。降低感知延迟最有效的手段是阶段间流式化,此外打断路径应纳入延迟预算,并通过CI回放录音断言各阶段p95预算防止劣化。
在语音对话中,响应延迟直接决定了体验的自然程度。文字聊天里停顿一两秒无伤大雅,但在电话场景中,同样的停顿会让用户以为线路断了。本文基于VRM AI Technology团队的技术分享,拆解一个对话回合的各个阶段,介绍如何为每个阶段埋点测量,并总结降低延迟的常用手段。
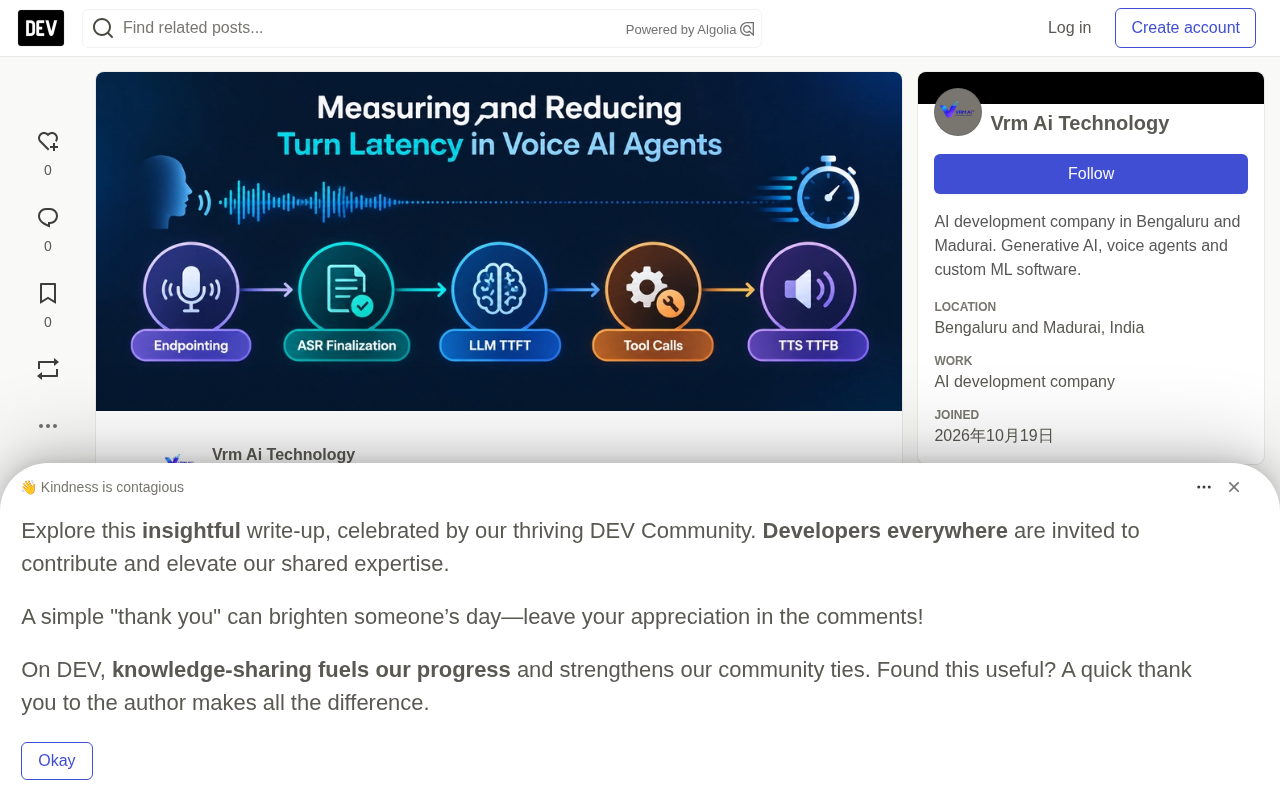
一个对话回合的时间花在哪里
一个回合从主叫方停止说话开始,到回复的第一段音频播出为止。这个区间可以拆成五个主要阶段:
- 端点检测(Endpointing):判断用户是否已经说完。
- ASR收尾(Finalization):在最后一个音频帧之后生成最终转录文本。
- LLM首Token时间(TTFT):模型开始生成之前的等待时间。
- 工具调用(Tool calls):CRM、日历或数据库查询等外部请求。
- TTS首字节时间(TTFB):语音合成输出第一块音频之前的延迟。
不启用流式处理时,总延迟大致等于这些阶段之和。启用流式后,部分阶段可以重叠,具体方式后文展开。无论哪种情况,动手优化之前,每个阶段都需要独立的测量数据。平均分掩盖了用户真正感知到的慢回合,团队强调要关注p50和p95两个分位数。
为回合埋点:一个轻量Tracer就够
测量不需要重型APM系统起步。VRM团队给出的方案是一个Python写的小型跟踪器,按阶段收集毫秒级耗时,并输出分位数报告。核心设计有三点:
- 用
defaultdict(list)按阶段累积样本; - 用
time.monotonic()计时,避免系统时钟调整带来的误差; - 样本数不足20个时跳过报告,因为样本太少时p95没有统计意义。
对于一次性完成的阶段(如工具查询),用record上下文管理器包裹即可自动计时。对于流式阶段(如LLM TTFT),关键是在看到第一个token时停表,然后继续消费剩余流,而不是等到整个响应结束。这个细节决定了TTFT测量的准确性——很多团队会把生成总时长误当成首token延迟。
start = time.monotonic()
first_token_seen = False

for token in llm_stream(prompt):
    if not first_token_seen:
        tracer.add("llm_ttft", (time.monotonic() - start) * 1000)
        first_token_seen = True
    # 在这里把每个token传给下一阶段(如TTS)
time.monotonic()是Python标准库中的单调时钟函数,它的返回值只保证单调递增,不受系统时间(NTP同步、手动改表、夏令时切换)调整的影响。与之相对的time.time()返回的是墙钟时间,在测量耗时场景下若系统时钟发生回拨或跳变,会得到负数或异常放大的间隔,导致延迟统计失真。因此在测量阶段耗时时,业内惯例是端点两次调用time.monotonic()再相减。需要留意的是它的绝对值没有实际意义(起点由操作系统决定),只能用于求差;跨进程或跨机器比较时间戳时应改用带同步时钟的方案。
读懂数据:p95与p50的差距是关键信号
拿到分位数报告后,第一步是对比p95和p50。如果p50正常但p95偏高,问题通常是间歇性的:冷连接、超长prompt、重试或网络抖动。这类问题不会出现在均值里,却恰恰是用户体验中最刺眼的部分。
第二步是横向对比各阶段,找出占据回合时间最大份额的那一个,优先处理。比如LLM TTFT占了60%的延迟,那么优化工具调用就是事倍功半。
p50(中位数)表示有一半的回合耗时低于该值,p95表示95%的回合低于该值,剩余5%的慢回合落在尾部。平均值对尾部不敏感:少量极慢回合会被大量正常回合稀释,从而掩盖真实体感。分位数则直接刻画"最差的那部分用户经历了什么"。样本量对分位数估计的可靠性影响很大——样本太少时p95实际上只由个别异常点决定,波动剧烈,这也是前文要求样本数不足20个时跳过报告的原因。工程上通常还会同时观察p99,并对超过阈值的长尾回合单独打点归因。
阶段间流式化:让等待重叠起来
串行等待每个阶段完成再启动下一个,延迟会快速累加。VRM团队把阶段重叠列为降低感知延迟最有效的手段之一,具体做法包括:
- ASR部分结果流式输出:让最终转录在语音结束后尽快就绪,而非等到整段处理完毕;
- LLM token流与TTS联动:第一个完整句子或从句就绪,立即启动语音合成;
- TTS音频分块下发:不要等整个音频文件合成完再播放,按块推送给用户。
这样做的效果是,用户可以在后续内容还在生成时,就听到回复的开头。感知延迟因此大幅下降,尽管端到端总时长未必缩短。
流式(streaming)指数据在生成过程中分块逐步产出,而非全部完成后一次性返回。对LLM而言,流式输出意味着模型每生成一个token就立即推送给下游,下游可以据此提前启动处理;对TTS而言,流式合成允许在音频尚未全部生成时就开始播放首块。流水线化的关键在于各阶段以"块"为粒度交接,而不是以"完整结果"为粒度交接。代价是下游需要在信息不完整时做决策,例如TTS在句子边界未确定时就要开始合成,因此工程上常以标点或从句边界作为切分触发点,在响应速度与语音自然度之间取得平衡。
打断处理是延迟预算的一部分
真实通话中用户会打断。当播放期间检测到语音活动时,系统需要停止音频输出、取消进行中的生成,并回到聆听状态。VRM团队特别指出,打断路径的响应速度应当计入延迟预算——对打断反应慢,和对回答反应慢一样不自然。这一点在工程上容易被忽略,因为打断是一条"非正常"路径,但它发生的频率在真实对话中并不低。
打断(barge-in)指用户在AI播报回复期间开口说话。系统通过语音活动检测(VAD)识别到用户语音后,需要完成三件事:立即停止正在播放的音频、向尚在进行中的LLM与TTS发起取消、切换回聆听与端点检测状态。其中"取消"要求下游流式接口支持中止信号,否则已排队的token和音频块会继续占用资源并造成串音。打断路径的耗时通常从检测到用户语音起算,到音频真正静音为止,它与正常回复路径一样应有独立的测量与预算阈值。
用回放测试守住延迟预算
延迟会随着prompt、工具和模型的演进而悄悄劣化。VRM团队建议保留一组固定的录音测试语句,在CI中回放并断言各阶段的p95不超过预算:
def test_turn_latency_budget():
    report = run_replay_suite()
    assert report["llm_ttft"]["p95_ms"] < 800
    assert report["tool_call"]["p95_ms"] < 300
文中的800ms和300ms只是占位阈值,实际预算应基于自己的测量结果和产品要求来设定。这个思路的价值在于把延迟从"上线后靠用户投诉发现"变成"每次提交都能验证"的工程指标。
实践要点
把VRM团队的方法浓缩成可落地的几条:
- 将每个回合拆成五个阶段,逐阶段测量,不要只测端到端总时长;
- 跟踪p50和p95,而不是平均值;
- 在阶段之间启用流式,让它们重叠执行;
- 把打断路径当作一等公民处理;
- 用CI回放测试为每个阶段设置延迟预算,防止劣化。
这套方法不依赖特定供应商或框架,对自建语音代理的团队具有直接参考价值。延迟优化的前提永远是先看清时间花在了哪里,而分阶段埋点正是那个"看清"的动作。
相关推荐

零成本搭建AI超级员工系统:智能体自动工作流全解析
深度拆解B站演示的AI超级员工系统:Agent智能体编排、数字人口播、地图与企业获客、24小时智能客服及法务模块全覆盖。分析零成本开户背后的商业逻辑与合规风险,帮助创业者判断这套AI数字员工系统的真实投产比。

Chatbot与AI Agent的本质区别:从对话到执行的跨越
Chatbot和AI Agent有什么区别?本文基于Learn Tech频道的MCP系列讲解,用订机票、笔记摘要等实例说明:Chatbot只给答案,Agent通过思考-行动-观察循环真正完成任务,并拆解模型、工具、记忆、目标四大部件及MCP的桥梁作用,同时讨论Agent的适用边界与权限风险。

免费GitHub仓库:342小时AI课程,从数学到MCP服务器
一个免费GitHub仓库提供342小时AI课程,包含523节课、20个阶段,覆盖数学基础到Agent构建和MCP服务器。支持目标驱动学习,每节课产出可留存的prompt、skill或agent,已有近10万人开始学习。