语音转文字总出错?混乱录音转录优化实战指南

一个普遍的痛点:语音转文字为何总在关键时刻掉链子
最近在 Reddit 上看到一位用户的吐槽,道出了很多人的心声:几乎所有的语音转文字工具在处理「完美录音」时表现都不错,但一旦遇到会议记录、随手录的语音备忘、带背景噪音的音频,就开始漏词、甚至凭空「编造」出奇怪的词句。而当录音里混杂多种语言时,情况更糟——半句话转得还算准确,剩下半句就成了不知所云的乱码。
这位用户的困惑很有代表性:「我本以为它能帮我省时间,结果最后还是得坐在那里一句句修改。是我期待太高了吗?还是说这项技术目前就只能做到这个程度?」
这背后,揭示了当前语音识别(ASR)技术的真实边界,也隐藏着不少可以优化的空间。
为什么「不完美录音」会让转录准确率崩塌
训练数据与真实场景的鸿沟
语音识别(Automatic Speech Recognition, ASR)技术经历了从隐马尔可夫模型(HMM)、高斯混合模型(GMM)到如今端到端深度学习模型的数十年演进。现代主流ASR系统多基于Transformer架构,通过在海量音频-文本对上进行监督学习来建立声学特征与文字序列的映射关系。然而,训练数据的来源分布直接决定了模型的能力边界。
大多数语音识别模型是在相对「干净」的音频上训练的——清晰的发音、单一说话人、低噪音环境。大多数公开数据集(如LibriSpeech)以朗读体英语为主,录制环境相对受控,与真实会议、街头采访等场景存在显著的**域偏移(domain shift)**问题。而现实中的会议录音往往是多人交叉发言、话筒距离不一、伴随空调声、键盘声甚至走动声。当输入音频偏离训练分布时,模型准确率会断崖式下跌。
ASR 幻觉问题:模型会自己「编词」
用户提到的「编造奇怪的词」,在技术上称为幻觉(hallucination)。像 OpenAI Whisper 这类端到端深度学习模型,采用序列到序列(seq2seq)架构,本质上是一个条件语言模型:给定音频特征,预测最可能的词元序列。这种设计在正常音频下表现出色,但也埋下了幻觉的种子。
当音频片段的声学信息不足时(如纯静音、白噪音或低信噪比片段),模型的语言先验会主导输出——它不会留白,反而倾向于生成符合语言统计规律但与实际音频无关的文字。研究表明,Whisper 在静音段产生幻觉的概率尤为突出,这也正是转录结果读来流畅、内容却完全对不上原音的根本原因,同时也是 VAD 预处理被广泛推荐的核心依据。
混合语言转录:语言切换点是重灾区
**代码转换(Code-switching)**是指说话人在同一段对话中交替使用两种或多种语言的语言现象,在双语或多语社区极为普遍,也是公认的 ASR 难题。从技术角度看,处理代码转换需要模型同时维护多套语音-语言映射,并能在帧级别识别语言边界。
然而,当前大多数 ASR 系统在语言检测阶段仍以**片段级(segment-level)**为主,无法做到词级别的实时切换识别。很多系统默认整段音频使用同一语言,一旦语言检测锁定错误,后半句就会被用错误的语言模型「硬解」,产生乱码。此外,不同语言在音素系统上的差异巨大,同一音频段被不同语言声学模型解码时会产生截然不同的输出,这是混合语言转录失败的根本原因。
提升语音转文字准确率的实用方法
从源头改善音频质量
技术再强也架不住输入太差。条件允许时优先做到:
- 靠近声源录音,减少混响和环境噪音;
- 使用音频降噪工具预处理,如 Adobe Podcast 语音增强、Krisp 等,先压制背景噪音再转录;
- 会议场景尽量使用独立收音设备,而非笔记本内置麦克风。
输入质量每提升一档,转录准确率的回报往往是非线性的。
选对转录模型,而非只用默认工具
开源领域中,Whisper large-v3 相比早期版本在噪音鲁棒性上有明显提升。若追求速度与准确率的平衡,可尝试以下两款扩展工具:
- WhisperX:在 Whisper 基础上引入了**强制对齐(forced alignment)机制,利用 wav2vec 2.0 实现词级时间戳对齐,并集成基于 pyannote.audio 的说话人日志(speaker diarization)**功能,可自动区分不同说话人的发言片段;
- faster-whisper:通过将 Whisper 模型转换为 CTranslate2 格式,在保持准确率基本不变的前提下推理速度可提升约 4 倍,显著降低了在消费级硬件上运行大型模型的门槛,是本地部署场景下的主流选择。
针对幻觉问题,以下参数调优经验值得参考:
- 开启 VAD(语音活动检测) 预处理,先切掉静音段再输入模型,能显著减少无中生有的编造;
- 适当调低
temperature参数,降低模型「自由发挥」的倾向; - 配置
no_speech_threshold和logprob_threshold,让模型在不确定片段时保持沉默而非硬凑。
多语言转录的针对性策略
若音频是稳定的两三种语言混合,可以:
- 使用明确支持多语言的模型,而非强制单语言解码;
- 对长音频先做分段处理,避免语言检测被单一片段误导;
- 商业 API 如 Google Cloud Speech-to-Text、AssemblyAI 提供 code-switching 专项支持,混合语言场景下通常比通用开源模型更稳定。
理性看待语音识别技术的现状
回到那位用户的核心疑问:这是技术的天花板,还是可以优化的空间?答案是两者都有。
以**字错率(Word Error Rate, WER)**这一标准评估指标为参考——其计算公式为(替换数+删除数+插入数)/ 参考词总数——在标准基准测试集(如 LibriSpeech test-clean)上,Whisper large-v3 的 WER 已降至 2% 左右,接近甚至部分超越人类标注者(约 4-5%)。然而这一数字在嘈杂的真实场景下会急剧恶化:在复杂声学环境下,即使是顶尖模型的 WER 也可能飙升至 20-40%,深刻揭示了「野生场景」下可靠的自动转录仍是未完全解决的问题。
指望「一键完美转录、零修改」目前并不现实。不过,通过音频预处理 + 合适的模型 + 参数调优的组合,绝大多数人的实际体验可以有质的飞跃——从「转出来还得逐句重写」变为「转出来只需局部微调」。
务实的使用心态
把语音转文字定位为**「初稿生成器」而非「终稿交付工具」**,是当下最健康的预期管理。它帮你完成 80% 的机械劳动,剩下 20% 的校对由人来把关。随着模型持续迭代,这个「20%」正在稳步缩小——但至少今天,人机协作仍是处理混乱录音的最优解。
核心要点
相关推荐

DeepSeek Harness零基础安装与测试实战指南
面向测试工程师的DeepSeek Harness教程:从Node.js环境搭建、NPX一条命令启动,到配置DeepSeek官方及第三方模型、网页搜索与文件读写实战,并解析轨迹视图带来的智能体可观测性。
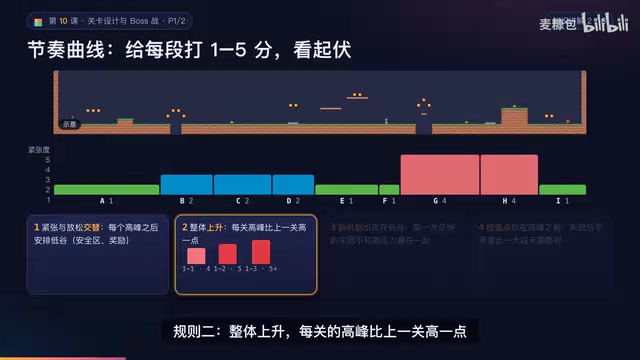
AI游戏开发实战:用四步法和节奏曲线设计关卡
AI游戏开发实战第十课:用四步法(教学、练习、组合、考验)和1-5分节奏曲线设计关卡,配合视线引导与安全区原则,实现Animatable Body 2D移动平台,并生成1-2地下洞窟与1-3守卫大厅的ASCII关卡草图。

AI游戏开发实战:两阶段Boss状态机与死亡热力图调优
AI游戏开发实战第10课:用状态机实现两阶段Boss,以颜色信号和0.4秒预警底线保证公平性,通过死亡热力图定位难度断崖,并按从轻到重的修正手段一次只改一处,附验收清单与常见坑。