元认知校准:人机协同中人类审查者的真正价值
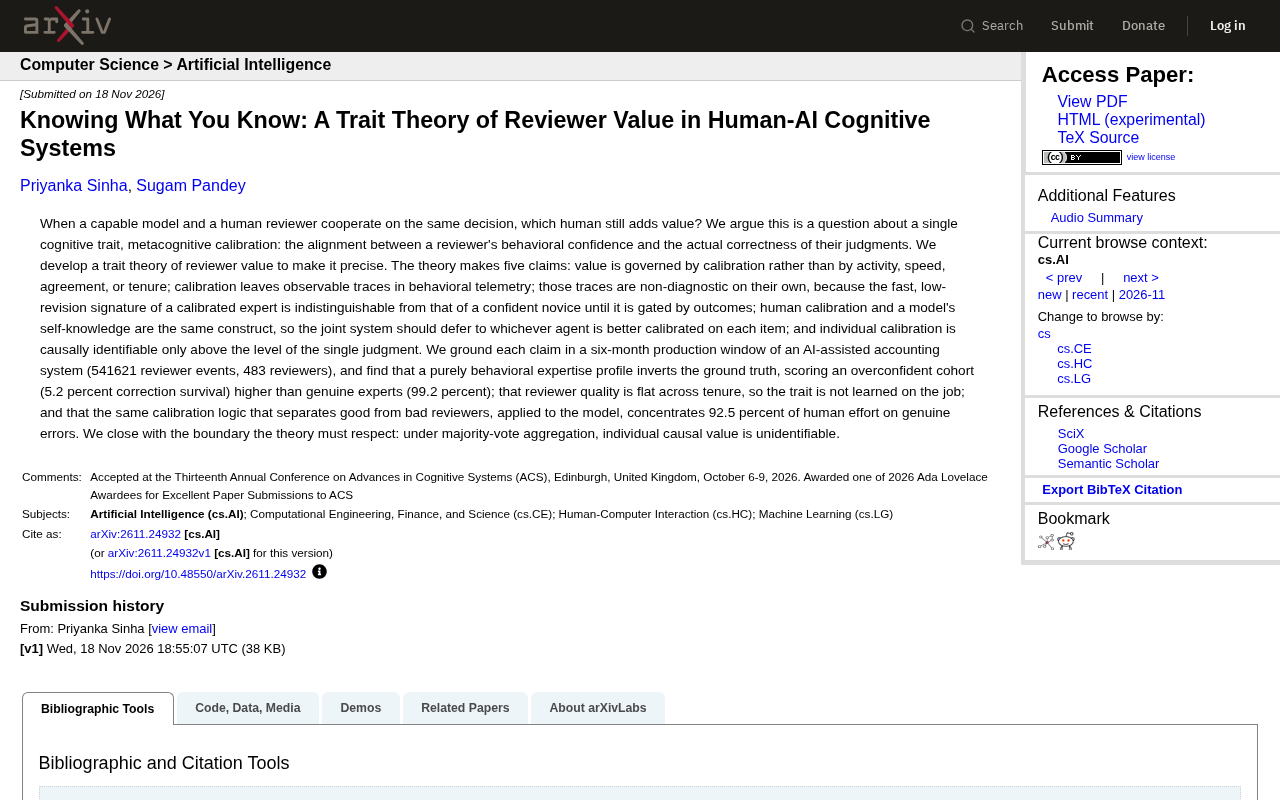
研究提出审查者价值取决于元认知校准而非行为指标,行为画像会颠倒专家与新手。
该研究提出“审查者价值特质理论”,主张人机协同中人类审查者的核心价值是元认知校准——行为置信度与实际正确性的对齐程度,而非活跃度、速度、一致率或资历。基于AI辅助会计系统六个月的生产数据,研究发现纯行为化专家画像会完全颠倒真实情况,给过度自信群体打出高于真正专家的分数;审查者质量在资历维度上基本持平,说明校准更似个体特质而非在职习得。研究进一步指出人类校准与模型自我认知是同一构念,联合系统应在每个条目上服从校准更好的一方。理论边界在于多数投票聚合下个体因果价值不可识别。对企业而言,行为指标不应单独作为质量依据,需引入结果门控并识别个体校准水平。
当强大的AI模型与人类审查者共同参与同一决策时,人类究竟贡献了什么价值?一篇题为《Knowing What You Know: A Trait Theory of Reviewer Value in Human-AI Cognitive Systems》的研究给出了一个反直觉的答案:审查者的价值不取决于活跃度、速度、一致率或资历,而取决于元认知校准——即审查者的行为置信度与其判断实际正确性之间的对齐程度。
核心观点:校准优于一切行为指标
该研究提出“审查者价值特质理论”,包含五个层层递进的论断。第一,审查者价值由校准而非活跃度、速度、一致率或资历主导。第二,校准会在行为遥测中留下可观测的痕迹。第三,这些痕迹本身并不具有诊断性——一个校准良好的专家表现出的“快速、低修改”模式,与一个自信满满的新手在结果介入之前无法区分。第四,人类的校准能力与模型的自我认知是同一构念,因此联合系统应当在每个条目上服从校准更好的一方。第五,个体校准只有在超越单次判断的层面才具备因果可识别性。
这一理论框架的价值在于,它把“人类审查者是否还有用”这种模糊的焦虑,转化为一个可操作、可测量的认知特质问题。
元认知校准是元认知研究中的核心概念,指个体对自身判断正确性的主观信心与实际正确率之间的匹配程度。一个校准良好的审查者,在他有把握时确实更可能正确,在他犹豫时确实更可能出错;而校准不良者则表现为过度自信(高信心低正确率)或信心不足。常用度量包括Brier分数、校准曲线与期望校准误差(ECE)。这一概念之所以关键,是因为它把“信心”从主观感受转化为可被统计检验的客观属性,从而使“审查者是否有价值”成为可测量的问题,而非依赖资历或活跃度等代理指标。
生产环境数据揭示的悖论
研究基于一个AI辅助会计系统长达六个月的运行窗口,覆盖大量审查者事件与数百名审查者。数据分析揭示了一个令人警醒的现象:一个纯行为化的“专家画像”会完全颠倒真实情况。该画像给一个过度自信的群体打出高分,而该群体的修正存活率极低;相反,真正专家的修正存活率接近满分。换句话说,如果只看行为信号,系统会把自信的新手误判为专家,把真正的专家排在后面。
另一个关键发现是,审查者质量在资历维度上基本持平。这意味着校准能力并非通过在职经验习得,而更像是某种个体特质。这一结论对依赖“资深审查者”的组织设计提出了挑战。
修正存活率是衡量审查者修改质量的指标:审查者对模型输出所做的修正,在后续流程(如上游复核、最终审计或结果验证)中未被推翻或回退的比例。存活率高,意味着修正确实纠正了错误;存活率低,则说明修正本身可能是误改或无效劳动。它与“修改次数”“修改速度”等行为指标的根本区别在于,它需要结果门控——即等待下游验证后才能计算,因此无法在单次判断当下即时获得。这正是研究中强调“校准痕迹本身不具诊断性”的原因:行为信号即时可得但会误导,结果信号可靠但滞后。
把校准逻辑反用于模型
研究进一步指出,区分好审查者与差审查者的校准逻辑,同样可以应用于模型本身。当系统将人类努力集中到真正的错误上时,大部分人类投入被引导至有意义的修正,而非无效的反复确认。这提示了一种联合系统的设计原则:不是简单地在人机之间分配任务,而是动态地判断在当前条目上哪一方的校准更可靠。
模型的自我认知(也称模型校准或置信度校准)指模型对其输出正确性的置信度估计是否与实际准确率对齐。现代大语言模型普遍存在过度自信问题:其输出的概率或口头表达的置信度往往高于真实正确率。研究主张人类校准与模型校准是同一构念,意味着可以用统一的度量框架比较二者,并在每个条目上让校准更可靠的一方主导决策。这一思路区别于传统的“人机分工”或“人在回路”设计,后者预设人类始终充当最终把关者,而校准框架允许模型在自身更可靠的条目上自主决策。
理论的边界:多数投票下的不可识别性
研究没有回避理论的局限。在多数投票聚合机制下,个体的因果价值是不可识别的——你无法从集体输出中分离出单个审查者的贡献。这一边界条件提醒我们,校准理论并非万能钥匙,它需要与具体的聚合机制和决策架构配合使用。
因果不可识别性源于因果推断中的经典难题:当多个个体的判断被聚合成单一输出时,观测到的只是集体结果,无法反推每个个体对结果的独立因果贡献。在多数投票机制下,一个个体的票只有在成为决定性一票时才会影响输出,而这种情况在数据中难以系统观测。要识别个体价值,需要引入随机化、留一法或按条目记录个体判断与结果的配对数据。这一限制并非该研究独有,而是所有集体决策系统评估个体贡献时面临的普遍方法论挑战。
对企业与AI产品设计的启示
对于构建人机协同系统的团队而言,这项研究传递了几个务实信号。审查者的行为速度、低修改率或高一致率都不应被单独用作质量指标;需要引入结果门控来验证校准痕迹。审查者培训若试图通过经验积累来提升校准,效果可能有限,更有效的做法是识别并匹配个体校准水平。把人类注意力集中到模型校准较弱的条目上,能显著提升联合系统的效率。
该研究目前以预印本形式呈现,其结论基于单一会计系统的生产数据,跨领域的外部效度仍有待检验。但“元认知校准作为审查者价值核心”这一命题,为人机协同的质量评估提供了一个值得认真对待的新坐标系。
相关推荐

Gemini 4 Neon评测:跑分比肩Carbon,API定价与额度解析
Google Gemini 4 Neon正式上线,跑分紧咬Carbon,API定价3/15为Hydrogen两倍。本文汇总B站UP主实测:Neon可平替90% Carbon场景,AntiGravity中额度消耗仅为Carbon三分之一,并解析订阅渠道限制与2API封号风险。

Gemini 4 Helium或将至?Google订阅限制松绑信号
Google团队成员预告发布将继续,社区推测Gemini 4 Helium(Flash Lite)或成下一款模型;订阅封禁争议获回应,产品负责人以「Soon」暗示可能开放限制。本文梳理Gemini动向、OpenAI Coding Agent与风险管理、豆包实时音视频API及算力商业动态。

AI辅助React开发实战:视频应用优化与错误处理
14年经验开发者演示如何用AI辅助优化React视频应用:通过ImageKit将视频从80MB压缩至5MB(约94%),并实现可靠的错误处理与重试机制。包含与AI协作的规划、代码理解和验证方法。