月费20美元vs年费百万:Cursor与Blitzy的本质差异
Cursor与Blitzy不是竞争对手:前者辅助开发者逐文件编码,后者自主运行数天将整个企业级项目做到生产就绪。
本文核心论点是:月费20美元的Cursor与年费可达500万美元的Blitzy并非同一赛道的竞争者,差异根源在于「工作单元」与「上下文」的本质不同。Cursor以函数或文件为粒度工作,开发者全程在环并充当「缺失的上下文」;Blitzy则先花数天逆向工程整个代码库构建知识图谱,再调度数千个智能体完成整个项目。在Grafana三百万行代码的实测中,两者都修复了播放列表bug,但Cursor产出的是约300行改动的「能跑的Demo」,缺少字段校验等生产必备细节;Blitzy产出的是含集成测试、文档、翻译字符串、输入校验的83文件PR,可直接合并上线。两款工具目标不同,各自完成了其设计使命,不应置于同一天平上比较。
两种截然不同的工作单元
Cursor每月20美元,而另一款企业级AI编程工具Blitzy的费用可高达每年500万美元。乍看之下天差地别,但视频作者给出了一个关键判断:它们其实不是竞争对手,甚至根本不在同一个赛道上。
理解两者差异的核心,在于「工作单元」的不同。Cursor、Claude Code、Copilot这类工具,工作粒度停留在函数、文件或一个小功能上。你全程在环(in the loop),一次会话里不断与它交互、修改、再交互。而Blitzy的工作粒度是「整个项目」——它可以连续运行数天,你不需要盯着每一次编辑,只需要审批一份计划。
换句话说,Blitzy把大量时间花在前期的规划和提示词上,告诉它你想实现什么,然后它花几天时间把项目做到「几乎完全成型」再交还给你。这是两种完全不同的协作模式。
为什么会有这道分水岭:上下文
这种分裂的根源在于上下文窗口。当一个智能体在你的代码上工作时,系统提示、工具、技能、对话历史和项目代码都在争夺同一个上下文窗口。等到它真正开始编辑文件时,实际上一次只能容纳大约五千到一万行代码。
作者强调,这不是产品缺陷,而是智能体工作原理决定的数学现实。目前最大的上下文窗口是一百万token,根本装不下三百万行代码。
那么Cursor、Copilot这些小型智能体是如何在庞大代码库上工作的?答案很简单:你就是那块缺失的上下文。你了解架构,知道哪四个文件重要,你把智能体指向它们,它就能做得很好。但这个前提是——代码是你自己的,你清楚里面发生了什么。
一旦把这个前提拿掉,面对三百万行你从没见过的代码,你不知道哪些文件重要、该遵循什么约定,智能体也和你一样两眼一抹黑。它无法一次性摄取整个代码库,如果你自己都不懂,它也给不出你想要的结果。
上下文窗口(Context Window)是大语言模型一次能「看到」的文本总量上限,以token为单位计量(大致上,1000个token约等于750个英文单词或500个汉字)。模型在生成每一个回复时,只能参考窗口内的信息,窗口之外的内容对它来说完全不存在。这一限制并非工程偷懒,而是Transformer架构的注意力机制(Self-Attention)带来的根本约束——计算复杂度随序列长度呈平方级增长,导致超大上下文的推理成本极高。即便是目前最大的百万token窗口(约75万英文单词),对于动辄数百万行的企业级代码库来说也远远不够。更重要的是,上下文窗口是系统提示、工具描述、对话历史与代码内容共同竞争的有限空间,真正留给代码本身的份额往往只有窗口总量的一小部分,这正是文章中「五千到一万行」这一数字的由来。
Blitzy的暴力解法:先逆向,再动手
Blitzy针对的正是这类问题。它采用一种「暴力」策略:在写下第一行代码之前,先花几天时间摄取你的整个代码库,把它逆向工程成一张知识图谱,理解每一个组件——每个服务、每份契约、每个奇怪的约定,甚至是有人早年间随手加进去的东西,它都会捕捉到。
然后它针对这份理解运行数千个智能体,而不是只盯着代码库的一小块视图。整个摄取过程根据代码库规模可能需要两到四天,随后生成一份庞大的规格说明文档。当你下达任务时,同样是运行数天、预留大量算力、调度数千个智能体,最后交还给你一份几乎完成的工作。
一个耐人寻味的细节是:Blitzy自己的工程师每天都在用Claude Code和Cursor。他们的秘诀在于编排(orchestration)——把多个模型融合在一起使用,甚至包括并非当前前沿的旧模型。真正的智能藏在他们设计的系统里,而不是原始的「大脑」中。哪怕换一个LLM进去,差别也不大,因为决定成败的是系统架构。
编排(Orchestration)在AI智能体领域指的是一套协调多个AI模型或智能体协同工作的系统架构。与单纯依赖单一大模型的「大脑」不同,编排系统会将复杂任务拆解为子任务,分配给最适合的模型或工具并行处理,再将结果汇聚整合。知识图谱(Knowledge Graph)则是一种将实体(如代码中的函数、服务、类)及其相互关系结构化存储的数据表示方式,使智能体能够像查询数据库一样检索代码库的架构信息,而非每次都从头阅读原始代码文件。Blitzy的核心壁垒正在于此:它将逆向工程的结果固化为可反复查询的知识图谱,让后续数千个智能体在任务执行阶段无需重新理解代码库,从而突破了上下文窗口的硬性限制。
实战对决:三百万行代码的Grafana
为了直观展示差异,作者选择了地球上最大的开源代码库之一——Grafana,约三百万行代码,并挑选了一个用户从很早以前就在请求、却始终没实现的功能。
这个功能与Grafana的播放列表(Playlist)有关。播放列表可以在电视等屏幕上循环切换不同仪表盘。但存在一个bug:当用户希望循环展示多台服务器(server A、B、C)的不同视图时,播放列表始终只停留在server A,无法按预期在host变量的不同服务器间切换。有Grafana贡献者早年曾评论说这功能「很有用但相当复杂耗时」,于是一直没做。
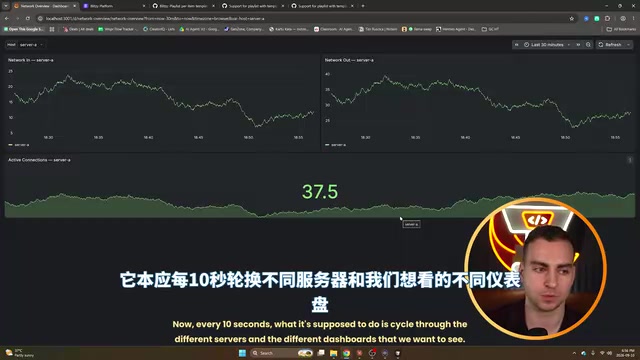
作者坦言这不是一场公平的比较——他故意给了Cursor一个它从未被设计来完成的任务。他在Cursor里粘贴了详细的提示词并附上原始issue链接,选用当前最强模型并开到最高思考等级,然后看它如何逐个文件慢慢工作。
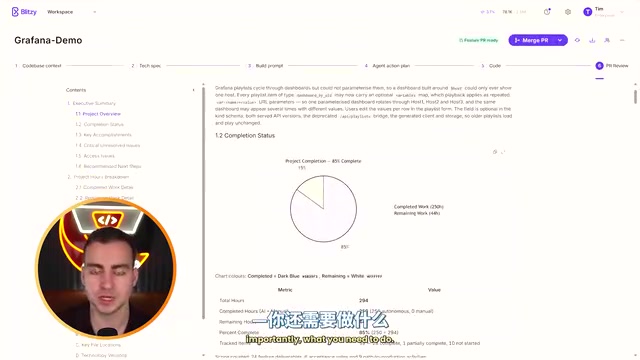
而Blitzy这边,流程是先生成代码库上下文文档,再产出一份深度技术规格(约300到400页,包含系统架构、依赖、mermaid图表、时序图等),然后由你给出详细的build prompt,它生成智能体行动计划,你审批后它才开始写代码。这个项目Blitzy花了两三天完成。
关键差异:能跑的Demo vs 能合并的PR
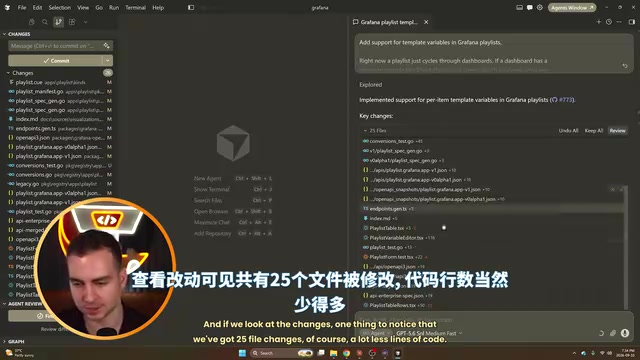
结果出人意料:Cursor也真的把bug修好了。它改动了约25到26个文件、300行左右代码,涉及schema、存储桥接、编辑器、播放逻辑和少量测试。运行验证后,播放列表确实能在server A、B、C之间正确循环。
而Blitzy的PR改动了83个文件、19000行新增(其中不少是markdown文档)。两者都解决了问题,但差距体现在「完成度」上。
Blitzy的PR包含了大量你实际上线时才会需要的东西:集成测试、断言旧播放列表逐字节序列化保持不变(确保老用户不受影响)、更新OpenAI规范、翻译字符串、附带警告的用户文档,还有作者自己都没想到的诸多细节。它还发布了明确的限制——32个变量、每个变量64个值,超限会带着字段名报错,并配有11个测试用例来验证。
相比之下,作者测试Cursor的版本时发现:它接受空白变量名、允许单个变量拥有多达500个不同值、字段没有校验。在个人笔记本上无所谓,但推向生产环境时,这些都可能引发事故。
作者的结论是:Cursor的版本没有错,它确实解决了被要求的问题,但它做出的是一个「能跑的Demo」;而Blitzy做出的是一个「企业可以直接合并的PR」。在Grafana这样的企业级代码库里,一个可合并的pull request价值要高得多。
这也正是为什么Blitzy更多被企业而非个人开发者使用。合并PR后,它还会自动把改动同步回技术规格,让知识图谱始终保持最新。两款产品目标不同,都完成了各自的使命——它们本就不该被放在同一个天平上衡量。
Pull Request(PR)是现代软件团队通过代码托管平台(如GitHub、GitLab)提交代码变更的标准流程。开发者在独立分支上完成修改后,发起PR请求将其合并进主干代码,触发自动化测试(CI/CD)、代码审查(Code Review)和安全扫描等门控流程,通过后才能正式上线。「可合并的PR」(mergeable PR)在企业语境中意味着代码变更已满足所有上线前提:测试覆盖率达标、边界条件已处理、文档同步更新、国际化字符串已翻译、API规范已更新——这些工作在个人项目中常被省略,但在多团队协作的生产环境中缺一不可。Blitzy输出83个文件、19000行改动的PR之所以被视为更高价值,正是因为它覆盖了从功能实现到生产就绪之间这段通常需要人工补全的「最后一公里」。
相关推荐
西伯利亚冰雪公主与斯基泰世界的考古之谜
西伯利亚冰雪公主是阿尔泰乌科克高原冰封墓葬中出土的斯基泰女性木乃伊,其纹身、丝绸与随葬品揭示了古代游牧文明的艺术、社会结构与跨区域交流。本文梳理其考古价值与相关争议。
SQL 行模式匹配:用 MATCH_RECOGNIZE 实现"行级正则"
MATCH_RECOGNIZE 让 SQL 拥有"行级正则"能力,用类正则语法匹配连续行序列,轻松检测暴力破解、交易异常、用户行为路径等顺序模式,告别繁琐的自连接与窗口函数。
黑客攻入Flock监控摄像头,暴露车牌识别系统内幕
黑客成功入侵Flock Safety的车牌识别监控摄像头,暴露了ALPR系统的内部运作机制。本文解析事件经过、系统工作原理及其引发的隐私与数据安全争议。