在线温度采样:信息论视角下的LLM解码新方法

论文从信息论出发,将温度采样解释为交叉熵预算下的最优解,并提出有理论保证的在线自适应温度算法EOS。
该论文从信息论根基重新审视LLM解码中的温度采样问题。作者基于Kac引理和渐近均分性质,揭示了生成多样性与重复概率之间的信息论对偶关系,并证明离线最优温度采样等价于交叉熵预算约束下的熵最大化问题,逆温度正是预算的拉格朗日乘子。针对条件分布逐个揭示的在线场景,论文提出熵在线采样(EOS)算法,在每个前缀上重新求解温度参数以逼近全局最优。理论分析表明EOS的熵损失和预算超支均为O(R log n),且下界证明任何严格满足预算的在线算法至少损失Ω(R)熵,说明EOS在log n因子内最优。实验验证了EOS能有效追踪离线最优温度并在熵指标上优于固定温度采样。
在线温度采样:信息论视角下的LLM解码新方法
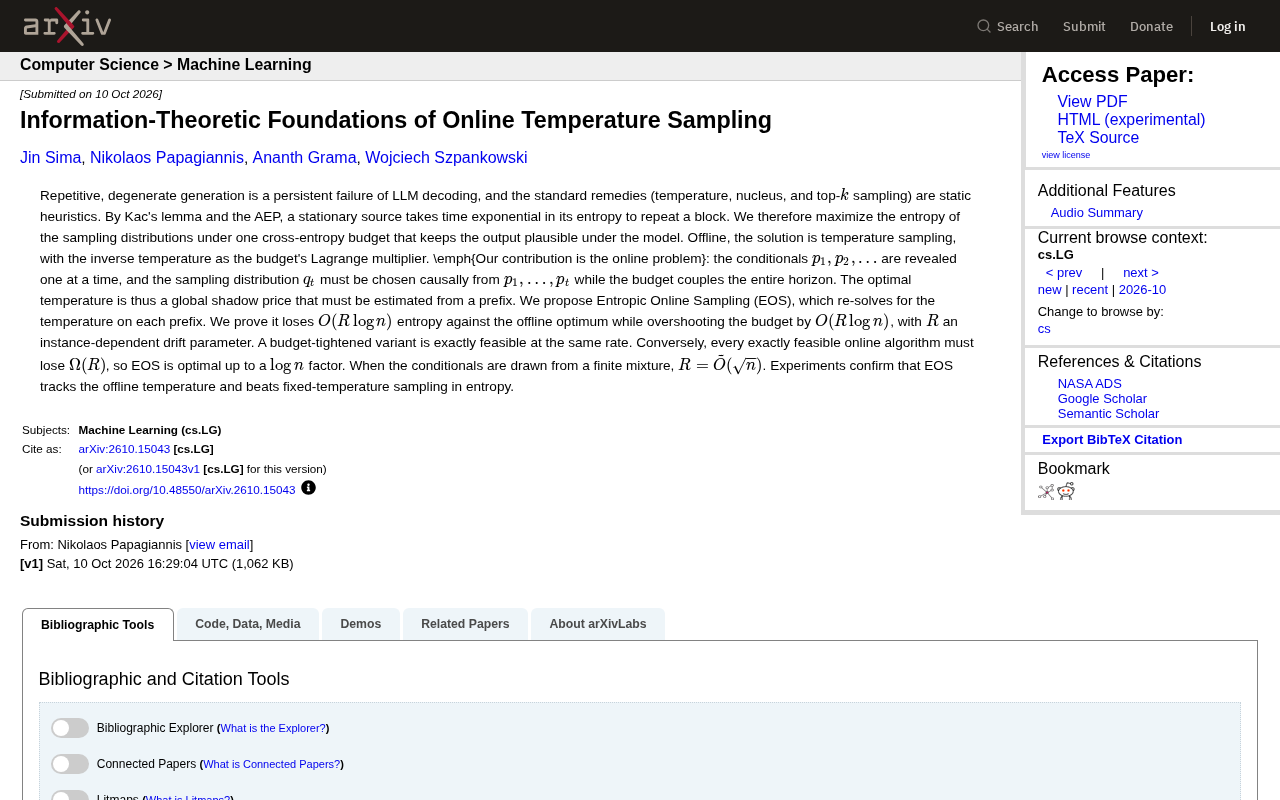
大型语言模型(LLM)在生成文本时,常常陷入重复、退化的困境——同一句话翻来覆去地说,或者陷入无意义的循环。温度采样、核采样和top-k采样这些标准补救措施,本质上都是静态启发式方法:无论上下文如何变化,超参数一旦设定就固定不变。一篇来自arXiv的最新论文《Information-Theoretic Foundations of Online Temperature Sampling》试图从信息论根基上重新审视这个问题,并提出了一种能够动态调整温度的在线采样算法。
从离线最优到在线难题
论文的核心洞察建立在Kac引理和渐近均分性质(AEP)之上:一个平稳信源要重复某个块,所需时间随其熵呈指数增长。换句话说,生成多样性与重复概率之间存在深刻的信息论对偶关系。为了抑制退化生成,自然的思路是最大化采样分布的熵,同时施加一个交叉熵预算约束,确保输出在模型看来仍然合理。
这个约束优化问题的离线解恰好就是温度采样——逆温度参数正是预算约束的拉格朗日乘子。这个结论本身并不令人意外,但它为温度采样提供了一个严格的信息论解释:温度不再是一个需要手动调节的超参数,而是模型似然性与输出多样性之间权衡的影子价格。
真正的挑战在于在线场景。在实际生成过程中,条件分布 $p_1, p_2, \dots$ 是逐个揭示的,而采样分布 $q_t$ 必须因果地从已知前缀 $p_1, \dots, p_t$ 中决定,但预算约束却耦合了整个生成时域。这意味着最优温度是一个全局影子价格,必须从局部信息中估计出来。
Kac引理源于遍历理论,最初用于研究动力系统中返回时间的统计性质。其核心结论是:对于一个平稳遍历系统,某一状态或状态块的期望返回时间与其测度成反比。在信息论语境下,这一引理被推广为:平稳信源重复输出某个长度为n的块所需的时间,随该块的熵呈指数增长。直观理解是,一个块包含的信息量越大(熵越高),信源恰好再次生成同一序列的概率就越低,平均等待时间就越长。这为文中“生成多样性与重复概率之间存在信息论对偶关系”提供了数学根基:模型输出越确定(低熵),越容易陷入重复循环;输出越多样(高熵),重复所需时间指数级增长。
**渐近均分性质(AEP)**是信息论的基石定理之一,由Shannon提出。它指出,对于独立同分布或平稳遍历信源,当序列长度n趋于无穷时,几乎所有典型序列的出现概率都近似等于2^{-nH},其中H是信源熵。AEP将熵与典型序列的数目和概率直接联系起来:熵越高,典型序列越多,单个序列的概率越低。这一性质是理解Kac引理在信源重复问题中应用的关键桥梁,也为后续基于熵的采样目标函数提供了理论正当性。
EOS算法:从局部前缀估计全局温度
针对这个在线问题,作者提出了熵在线采样(Entropic Online Sampling,EOS)算法。EOS的核心机制是在每个前缀上重新求解温度参数——本质上是在线地逼近那个全局最优的拉格朗日乘子。
理论分析给出了明确的性能保证。EOS相对于离线最优解的熵损失为 $O(R\log n)$,同时预算超支也在 $O(R\log n)$ 量级,其中 $R$ 是一个依赖于具体实例的漂移参数。作者还提出了一个预算收紧变体,能够在相同速率下严格满足预算约束。
更关键的是下界结果:任何严格满足预算的在线算法都必须损失 $\Omega(R)$ 的熵。这意味着EOS在 $\log n$ 因子范围内已经是最优的。当条件分布来自有限混合模型时,$R = \tilde{O}(\sqrt{n})$,给出了一个具体且可控的界。
这套分析框架的价值在于,它将温度采样从一个工程技巧提升为有理论保障的在线决策问题,并且清晰地量化了在线信息受限所带来的不可避免的代价。
拉格朗日乘子与影子价格:在约束优化问题中,拉格朗日乘子衡量的是当约束放松一个单位时,目标函数最优值的边际改善量。经济学中常将其解释为“影子价格”——即约束资源的隐含价值。在本文的框架下,交叉熵预算约束要求采样分布与模型分布之间的平均交叉熵不超过某个阈值,而逆温度β正是这个约束的拉格朗日乘子。β越大(温度越低),采样分布越接近模型分布,交叉熵越小但熵也越低;β越小(温度越高),熵越大但交叉熵可能超出预算。因此β精确地量化了“合理性”与“多样性”之间的边际替代率。
在线学习中的“遗憾”与全局约束:在线优化问题通常用“遗憾”(regret)来衡量在线决策与事后最优决策之间的差距。本文的EOS算法面临的特殊困难在于,预算约束是全局的——它耦合了整个生成时域的所有采样决策,而算法只能因果地、逐个前缀地做决策。这类似于在线资源分配问题:每一步消耗多少预算未知,但总预算有上限。EOS通过在每个前缀上重新求解局部优化来逼近全局最优的拉格朗日乘子,其O(R log n)的熵损失和预算超支保证,正是这种在线逼近策略的理论代价。
有限混合模型假设:论文中提到的“条件分布来自有限混合模型”是一种常见的统计建模假设,指每个条件分布p_t可以表示为有限个基分布的凸组合,即p_t = Σ_k π_k f_k,其中π_k是混合权重,f_k是基分布。这一假设在语言模型中具有合理性:不同上下文可能激活不同的语义模式或话题,每个话题对应一个基分布。在有限混合模型下,漂移参数R可以被具体界定为Õ(√n),这意味着随着序列长度增长,在线温度的估计误差以平方根速率增长,而非线性增长。这一结果让EOS的性能保证从抽象的O(R log n)变为具体可控的Õ(√n log n),为实际应用提供了更明确的预期。
实验验证与实用意义
实验部分验证了理论预测:EOS能够有效追踪离线最优温度的变化轨迹,并且在熵指标上优于固定温度采样。这个结果有两层含义。
在实践层面,EOS为LLM解码提供了一种无需手动调参的自适应温度策略。传统方法中,工程师需要根据任务类型和模型行为反复试验温度值,而EOS原则上可以自动完成这一过程,并且有信息论层面的性能保证。
在理论层面,这项工作建立了在线学习与信息论之间的新连接。温度采样的在线版本本质上是一个带有全局约束的在线优化问题,其分析工具(Kac引理、AEP、拉格朗日对偶)来自多个经典领域,但组合方式颇具新意。
当然,从理论到大规模部署仍有距离。EOS需要在每个前缀上重新求解优化问题,计算开销是否可接受、数值稳定性如何保证,都是实际应用中需要考量的问题。论文的实验规模也相对有限,在更大规模模型和更长生成序列上的表现仍有待验证。
解码策略的理论化趋势
这项工作反映了一个更广泛的趋势:LLM推理阶段的解码策略正在从经验驱动走向理论驱动。过去几年中,从温度采样到核采样再到各种惩罚机制,大多依赖直觉和实验试错。而EOS代表的方向是,用严格的信息论和在线学习框架来重新推导这些启发式方法,并给出可证明的性能边界。
对于关注LLM推理优化的研究者和工程师来说,这篇论文提供了一个值得关注的视角:解码策略的设计不必停留在启发式层面,信息论可以给出更坚实的理论基础和更清晰的性能边界。
核采样(Nucleus Sampling)与top-k采样是当前LLM解码中最常用的两种启发式策略。Top-k采样在每一步只从概率最高的k个token中采样,k为固定超参数;核采样则动态选择累积概率达到阈值p的最小token集合,再从中采样。两者都旨在截断低概率的“长尾”token,以避免生成不连贯的内容。然而,它们的超参数(k或p)同样是静态的,无法根据上下文复杂度自适应调整。EOS与这些方法的根本区别在于:它不是通过截断分布来控制质量,而是通过信息论约束下的熵最大化来动态调节温度,且其调节过程有在线学习理论保证。从更广的视角看,EOS代表的“约束优化+在线学习”框架有潜力统一和重新解释现有的各种解码启发式方法,将解码策略设计从参数调优问题转化为有明确目标函数和约束的优化问题。
相关推荐

uGAP:统一100+非洲地理数据集的AI平台
uGAP是开普敦大学团队开发的非洲地理空间AI平台,统一120余个非洲数据集并提供Python SDK,支持数据发现、处理与模型训练一站式工作流,已用于气旋洪水制图等实战场景。

Cursor能控制你的电脑了:AI代理可驱动桌面应用测试
Cursor 新增桌面控制能力,AI 代理可驱动 iOS 模拟器等桌面应用测试自己构建的功能。本文分析这一更新对开发工作流的影响、技术实现可能路径及可靠性考量。

Vibecoding自研推理引擎:理想丰满,现实骨感
Reddit开发者分享Vibecoding自研推理引擎的真实经历:用WebGL2和GLSL在浏览器跑GGUF Q4模型,却陷入tokenizer调试地狱。本文分析浏览器端LLM推理的工程难点,以及为何直接clone llama.cpp是更理性的选择。